



Tolerancia a Fallos: Impulsando Fiabilidad, Disponibilidad y Seguridad en Sistemas Críticos
Los sistemas que carecen de tolerancia a fallos son inherentemente menos fiables. Para ingenieros enfocados en RAMS —Fiabilidad, Disponibilidad, Mantenibilidad y Seguridad— diseñar con tolerancia a fallos es por tanto esencial, especialmente para equipos críticos donde la falla puede poner en peligro todo el sistema.
En este artículo describimos las características centrales de sistemas tolerantes a fallos y demostramos cómo el diseño redundante puede elevar la fiabilidad.
¿Qué es la tolerancia a fallos?
La tolerancia a fallos es la capacidad de un sistema para continuar operando cuando ocurre una falla. Diseños de alta tolerancia a fallos —ya sea por redundancia de hardware, redundancia de software o monitoreo activo— deben eliminar puntos únicos de falla (PUF) para sostener operación parcial o total.
La Esencia de los Diseños Tolerantes a Fallos
Desarrollar un diseño tolerante a fallos requiere un entendimiento profundo de los modos de falla potenciales a lo largo del ciclo de vida del equipo, sus causas raíz y los impactos resultantes. Los ingenieros deben balancear la fiabilidad deseada contra restricciones de coste y recursos. Es un error pensar que un sistema tolerante a fallos debe proteger contra toda falla posible; en su lugar, la tolerancia debe igualar la criticidad de la falla para lograr optimización coste-efectiva.
Características de los Sistemas Tolerantes a Fallos
Crear un sistema tolerante a fallos implica acciones deliberadas en cada etapa del ciclo de vida —especificación, diseño, validación y verificación (V&V), mantenimiento, operación y disposición. Las siguientes técnicas se aplican comúnmente:
- Detección y visualización de fallas
- Diagnóstico y contención de fallas
- Enmascaramiento y compensación de fallas
1) Detección y visualización de fallas
La detección es el elemento fundacional de cualquier diseño tolerante a fallos. Sin detección precisa de fallas y notificación, las capas de mitigación subsiguientes no pueden funcionar. Por ejemplo, un sistema de monitoreo de presión de neumáticos (TPMS) usa un sensor de presión para alertar al conductor cuando un neumático está sobre-inflado. La única tolerancia aceptable en este caso es detección y alerta precisas; cualquier acción correctiva está fuera del alcance del TPMS.
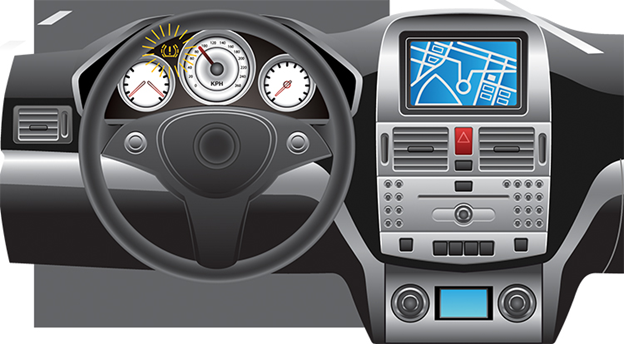
Una representación de la activación del TPMS
2) Diagnóstico y contención de fallas
En aplicaciones críticas, la detección es seguida por algoritmos de diagnóstico que localizan la falla y disparan medidas de contención. Un sistema de control distribuido (DCS) para una planta de proceso monitorea sensores, identifica presión anormal y abre automáticamente una válvula de seguridad para ventilar exceso de presión a una antorcha, previniendo incendio o explosión.
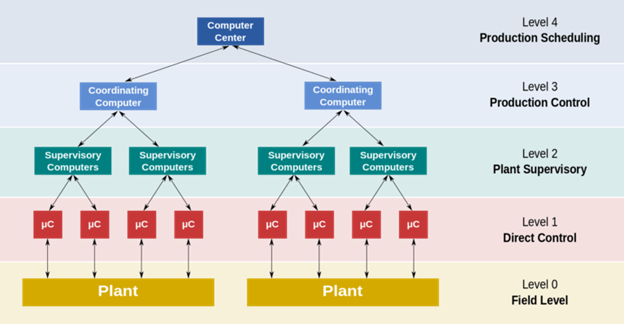
Una representación del sistema DCS
3) Enmascaramiento y compensación de fallas
El enmascaramiento de fallas es particularmente valioso en equipos habilitados para IoT donde ciberataques pueden inyectar datos falsos. Al detectar flujos anómalos y sustituir valores correctos, el sistema previene la propagación de información de estado errónea. En redes eléctricas, sistemas SCADA monitorean voltaje y frecuencia; un ciberataque que manipule estos límites podría disparar un apagón. Algoritmos de enmascaramiento protegen contra tal manipulación.
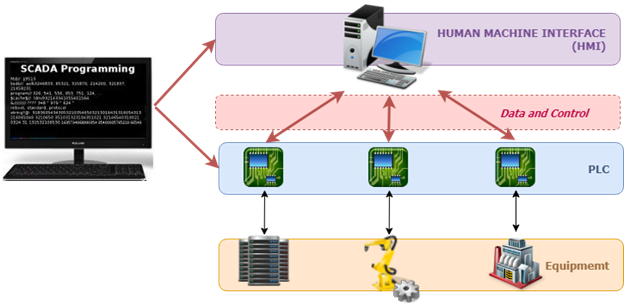
Una representación del sistema SCADA
Mejorando la Tolerancia a Fallos mediante Diseños Redundantes
La redundancia —desplegar un sistema alterno que pueda asumir la función cuando el primario falla— es la forma más directa de impulsar la tolerancia a fallos. Sin embargo, la redundancia indiscriminada puede inflar coste y complejidad, por lo que la decisión debe justificarse mediante un análisis riguroso de coste-beneficio.
Si bien la redundancia mejora la tolerancia a fallos, añadir sistemas al azar no debería ser el objetivo ya que el coste requerido para añadir cualquier nuevo sistema puede superar significativamente el beneficio de fiabilidad alcanzable.
Los tipos de redundancia se clasifican ampliamente como activos o pasivos.
Redundancias activas
La redundancia activa opera múltiples unidades concurrentemente. Un ejemplo simple son dos bombas funcionando a media capacidad; juntas logran la presión objetivo. Esquemas más avanzados —redundancia K-de-N y degradación grácil— permiten que un subconjunto de unidades permanezca en línea mientras otras sirven como repuestos calientes, asegurando operación continua mientras los componentes fallan.
Redundancia K-de-N mantiene un subconjunto predeterminado de unidades funcionando, permitiendo un pool mayor de repuestos para tomar el relevo ante falla. Degradación grácil permite que el rendimiento del sistema disminuya proporcionalmente con la pérdida de componentes, evitando la necesidad de sets de repuestos idénticos costosos.
Redundancias pasivas
La redundancia pasiva coloca equipo en standby que se activa solo cuando el primario falla. Existen dos variantes:
- Redundancias pasivas operativas —repuestos calientes que permanecen inactivos sin carga. Por ejemplo, un alternador en standby se sincroniza automáticamente si el alternador primario falla.
- Redundancias pasivas no operativas —repuestos fríos que deben encenderse o iniciarse manualmente. Una bomba de agua municipal que se enciende manualmente cuando la bomba primaria falla es un ejemplo típico.
Técnicas de Fiabilidad para Analizar la Tolerancia a Fallos
Analizar la tolerancia a fallos se basa en herramientas probadas de ingeniería de fiabilidad: Análisis de Modos de Falla y Efectos (AMFE) y Análisis de Árbol de Fallas (AAF). AMFE examina componentes individuales desde una perspectiva bottom-up, mientras que AAF modela la propagación de fallas desde una vista top-down. Modelos de Markov y simulaciones Monte Carlo cuantifican además cómo evolucionan las probabilidades de falla en el tiempo y cómo la incertidumbre impacta el rendimiento general.
Tolerancia a Fallos y Operaciones de Mantenimiento
Los sistemas tolerantes a fallos no eliminan el mantenimiento, pero proporcionan un colchón de seguridad que extiende el intervalo entre intervenciones. Un Sistema Computerizado de Gestión de Mantenimiento (CMMS) sigue siendo esencial para programar acciones correctivas antes de que fallas acumuladas precipiten una falla catastrófica. En la práctica, la tolerancia a fallos da a los equipos de mantenimiento margen de maniobra, permitiéndoles priorizar reparaciones críticas mientras diferir trabajo no urgente.
A pesar de costes iniciales más altos y complejidad de diseño, los diseños tolerantes a fallos entregan ganancias medibles en fiabilidad de equipos y tiempo de actividad del sistema.
Mantenimiento y reparación de equipos
- Rendimiento Superior en Mantenimiento y Fiabilidad: Estrategias Probadas para Éxito a Largo Plazo
- Mantenimiento y Fiabilidad: Por qué "Lo suficientemente bueno nunca lo es" impulsa el éxito empresarial
- Por qué la atención al detalle impulsa el éxito en mantenimiento y confiabilidad
- Proveedores de mantenimiento y confiabilidad: Guía crítica para compradores
- Equilibrando flexibilidad y confiabilidad en la manufactura moderna
- Aplicando la Entropía para Impulsar la Excelencia en Mantenimiento y Confiabilidad
- UT Lanza el Centro de Fiabilidad y Mantenibilidad, Reenfocándose en la Excelencia en Fiabilidad
- Lecciones de fiabilidad y seguridad desde una aventura en kayak
- ISA publica tercera edición actualizada de libro sobre Evaluación de Seguridad y Fiabilidad de Sistemas de Control
- Guía esencial para instalar y mantener un sistema séptico fiable
- COVID-19 y la nube: Cómo los grandes proveedores empoderaron a las empresas durante la pandemia