



Computación analógica en memoria: Inferencia Edge AI de bajo consumo
El machine learning y deep learning están ahora tejidos en la tecnología cotidiana. Desde asistentes de lenguaje natural a detección de objetos en tiempo real, la IA impulsa un número creciente de dispositivos de consumo e industriales. Sin embargo, la mayoría de estas aplicaciones dependen de motores de inferencia basados en cloud —una arquitectura que plantea preocupaciones sobre privacidad, consumo de energía, latencia y coste.
Desplegar IA localmente en el edge puede eliminar esos problemas. El principal obstáculo es el drenaje de potencia impulsado por memoria de aceleradores de redes neuronales digitales convencionales. Cuando pesos y activaciones se obtienen de DRAM o SRAM, el movimiento de datos solo consume dos a tres órdenes de magnitud más energía que la aritmética en sí. La computación analógica en memoria aborda este cuello de botella realizando operaciones multiply-accumulate (MAC) directamente dentro de un array de memoria no volátil.
IA basada en Cloud: Los puntos de dolor
Cuando un dispositivo edge reenvía datos crudos a un servidor remoto, surgen varios problemas:
- Privacidad y seguridad — Información personal o confidencial se transmite y almacena en centros de datos.
- Uso de energía innecesario — Cada bit enviado por radio, almacenado en cloud y re-recuperado quema energía.
- Latencia para inferencia small-batch — Las respuestas pueden tomar más de 100ms, lo cual es perceptible para usuarios.
- Ineficiencia de economía de datos — Sensores generan streams masivos; subirlo todo no es ni económico ni sostenible.
Para superar estos desafíos, un modelo entrenado se construye primero en una plataforma de alto rendimiento (cloud, granja GPU, etc.). Los pesos resultantes se mapean luego a un motor de inferencia ligero que realiza la computación localmente.
La naturaleza MAC-intensiva de redes neuronales
Incluso modelos ligeros están dominados por MACs. Por ejemplo, MobileNet-v1 con input 224×224 contiene 4.2 millones de parámetros y requiere 569 millones de MACs por inferencia. La multiplicación y acumulación se realizan en un producto denso matriz-vector.
Por qué la computación digital lucha
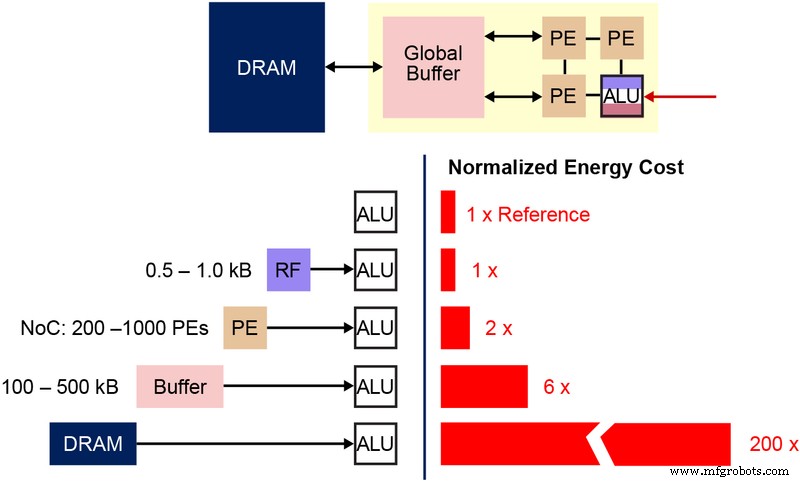
En un acelerador convencional, pesos y activaciones se almacenan en DRAM/SRAM y deben traerse a una unidad aritmético-lógica (ALU). La Figura 3 ilustra el cuello de botella de memoria: la energía gastada moviendo datos (50-100 pJ por transferencia) eclipsa los 250 fJ por operación MAC. Incluso con técnicas agresivas de reuso de datos, la arquitectura Von Neumann impone un límite duro a la eficiencia energética.
Computación analógica en memoria al rescate
Al embeber computación en el array de memoria mismo, la necesidad de transportar pesos desaparece. La transferencia de datos restante se limita a la señal de entrada, que típicamente es una salida de sensor. Celdas flash operando en régimen sub-threshold consumen corrientes sub-nanoamp, haciendo la potencia activa despreciable. En standby, las celdas no volátiles retienen datos sin consumo de potencia.
La plataforma memBrain™ de Silicon Storage Technology (una compañía de Microchip) ejemplifica este enfoque. Construida sobre la tecnología de memoria SuperFlash® (ESF3), cada bitcell puede programarse a un voltaje de umbral preciso (Vt), estableciendo una conductancia que representa un peso. Cuando se aplica un voltaje de entrada, la corriente a través de la celda iguala el producto de la entrada y el peso almacenado.
Arquitectura de memoria multi-nivel
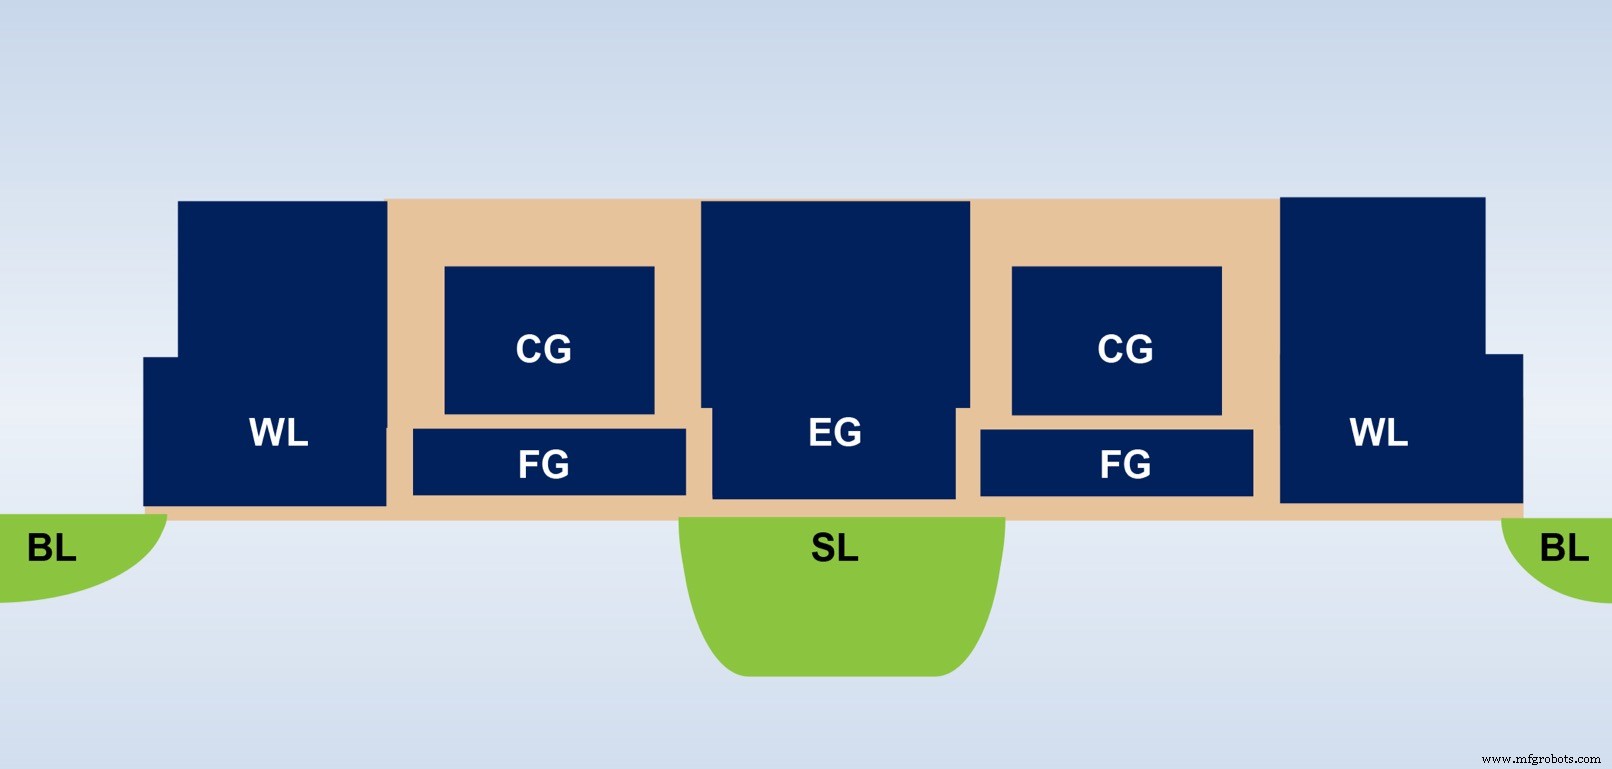
La Figura 4 muestra la sección transversal de una bitcell ESF3. La celda incluye cinco terminales —Control Gate (CG), Word Line (WL), Erase Gate (EG), Source Line (SL) y Bitline (BL). EG de alto voltaje programa el floating gate, mientras biasing de bajo voltaje en los otros terminales lee o escribe la celda.
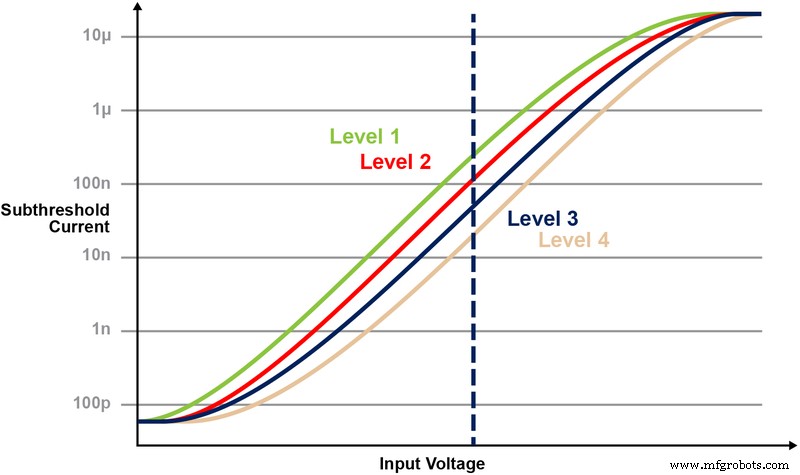
La programación de grano fino ajusta el Vt del floating-gate para producir una curva I-V específica. La Figura 5 demuestra un ejemplo de 2 bits donde cuatro niveles Vt distintos producen cuatro respuestas de corriente separadas cuando se aplica un voltaje CG fijo.
MAC en el array de memoria
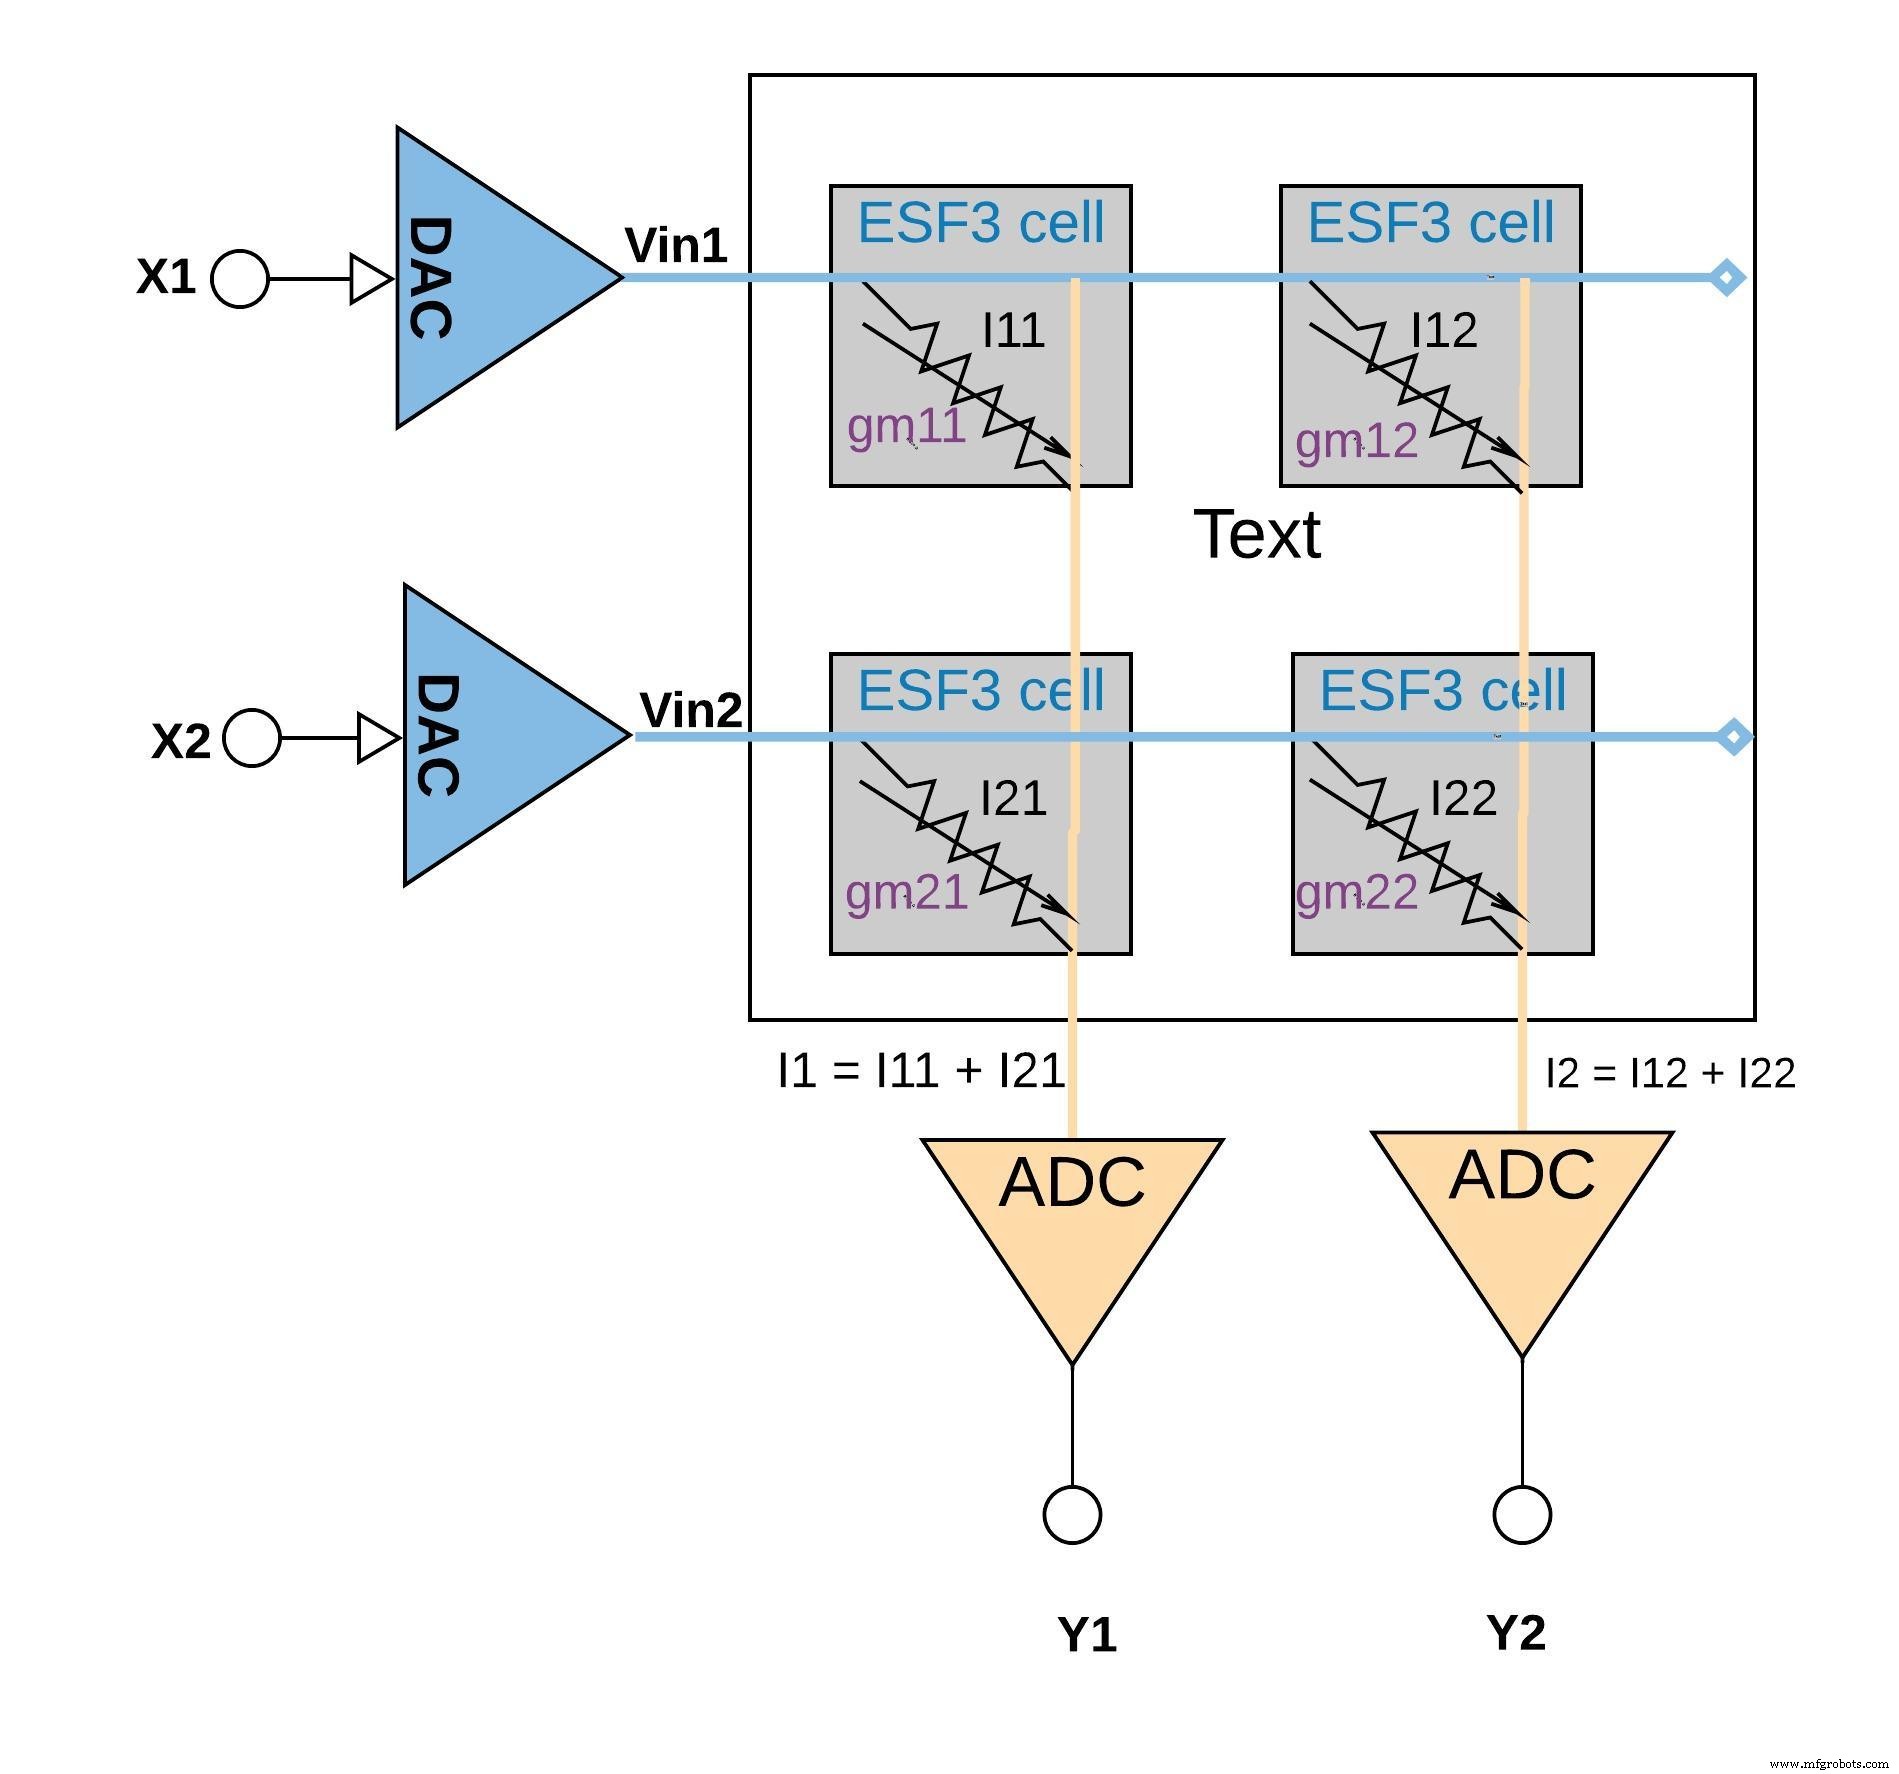
La conductancia gm de cada celda encarna un peso entrenado. La corriente Iout = gm · Vin implementa el paso de multiplicación. Cableando muchas celdas en paralelo, las corrientes de columna suman naturalmente, produciendo la operación de acumulación. La Figura 6 visualiza un array 2×2 realizando dos MACs y una acumulación.
A mayor escala, una matriz de pesos puede mapearse sobre un solo array de memoria. La Figura 7 muestra el layout de matriz para una capa fully connected.
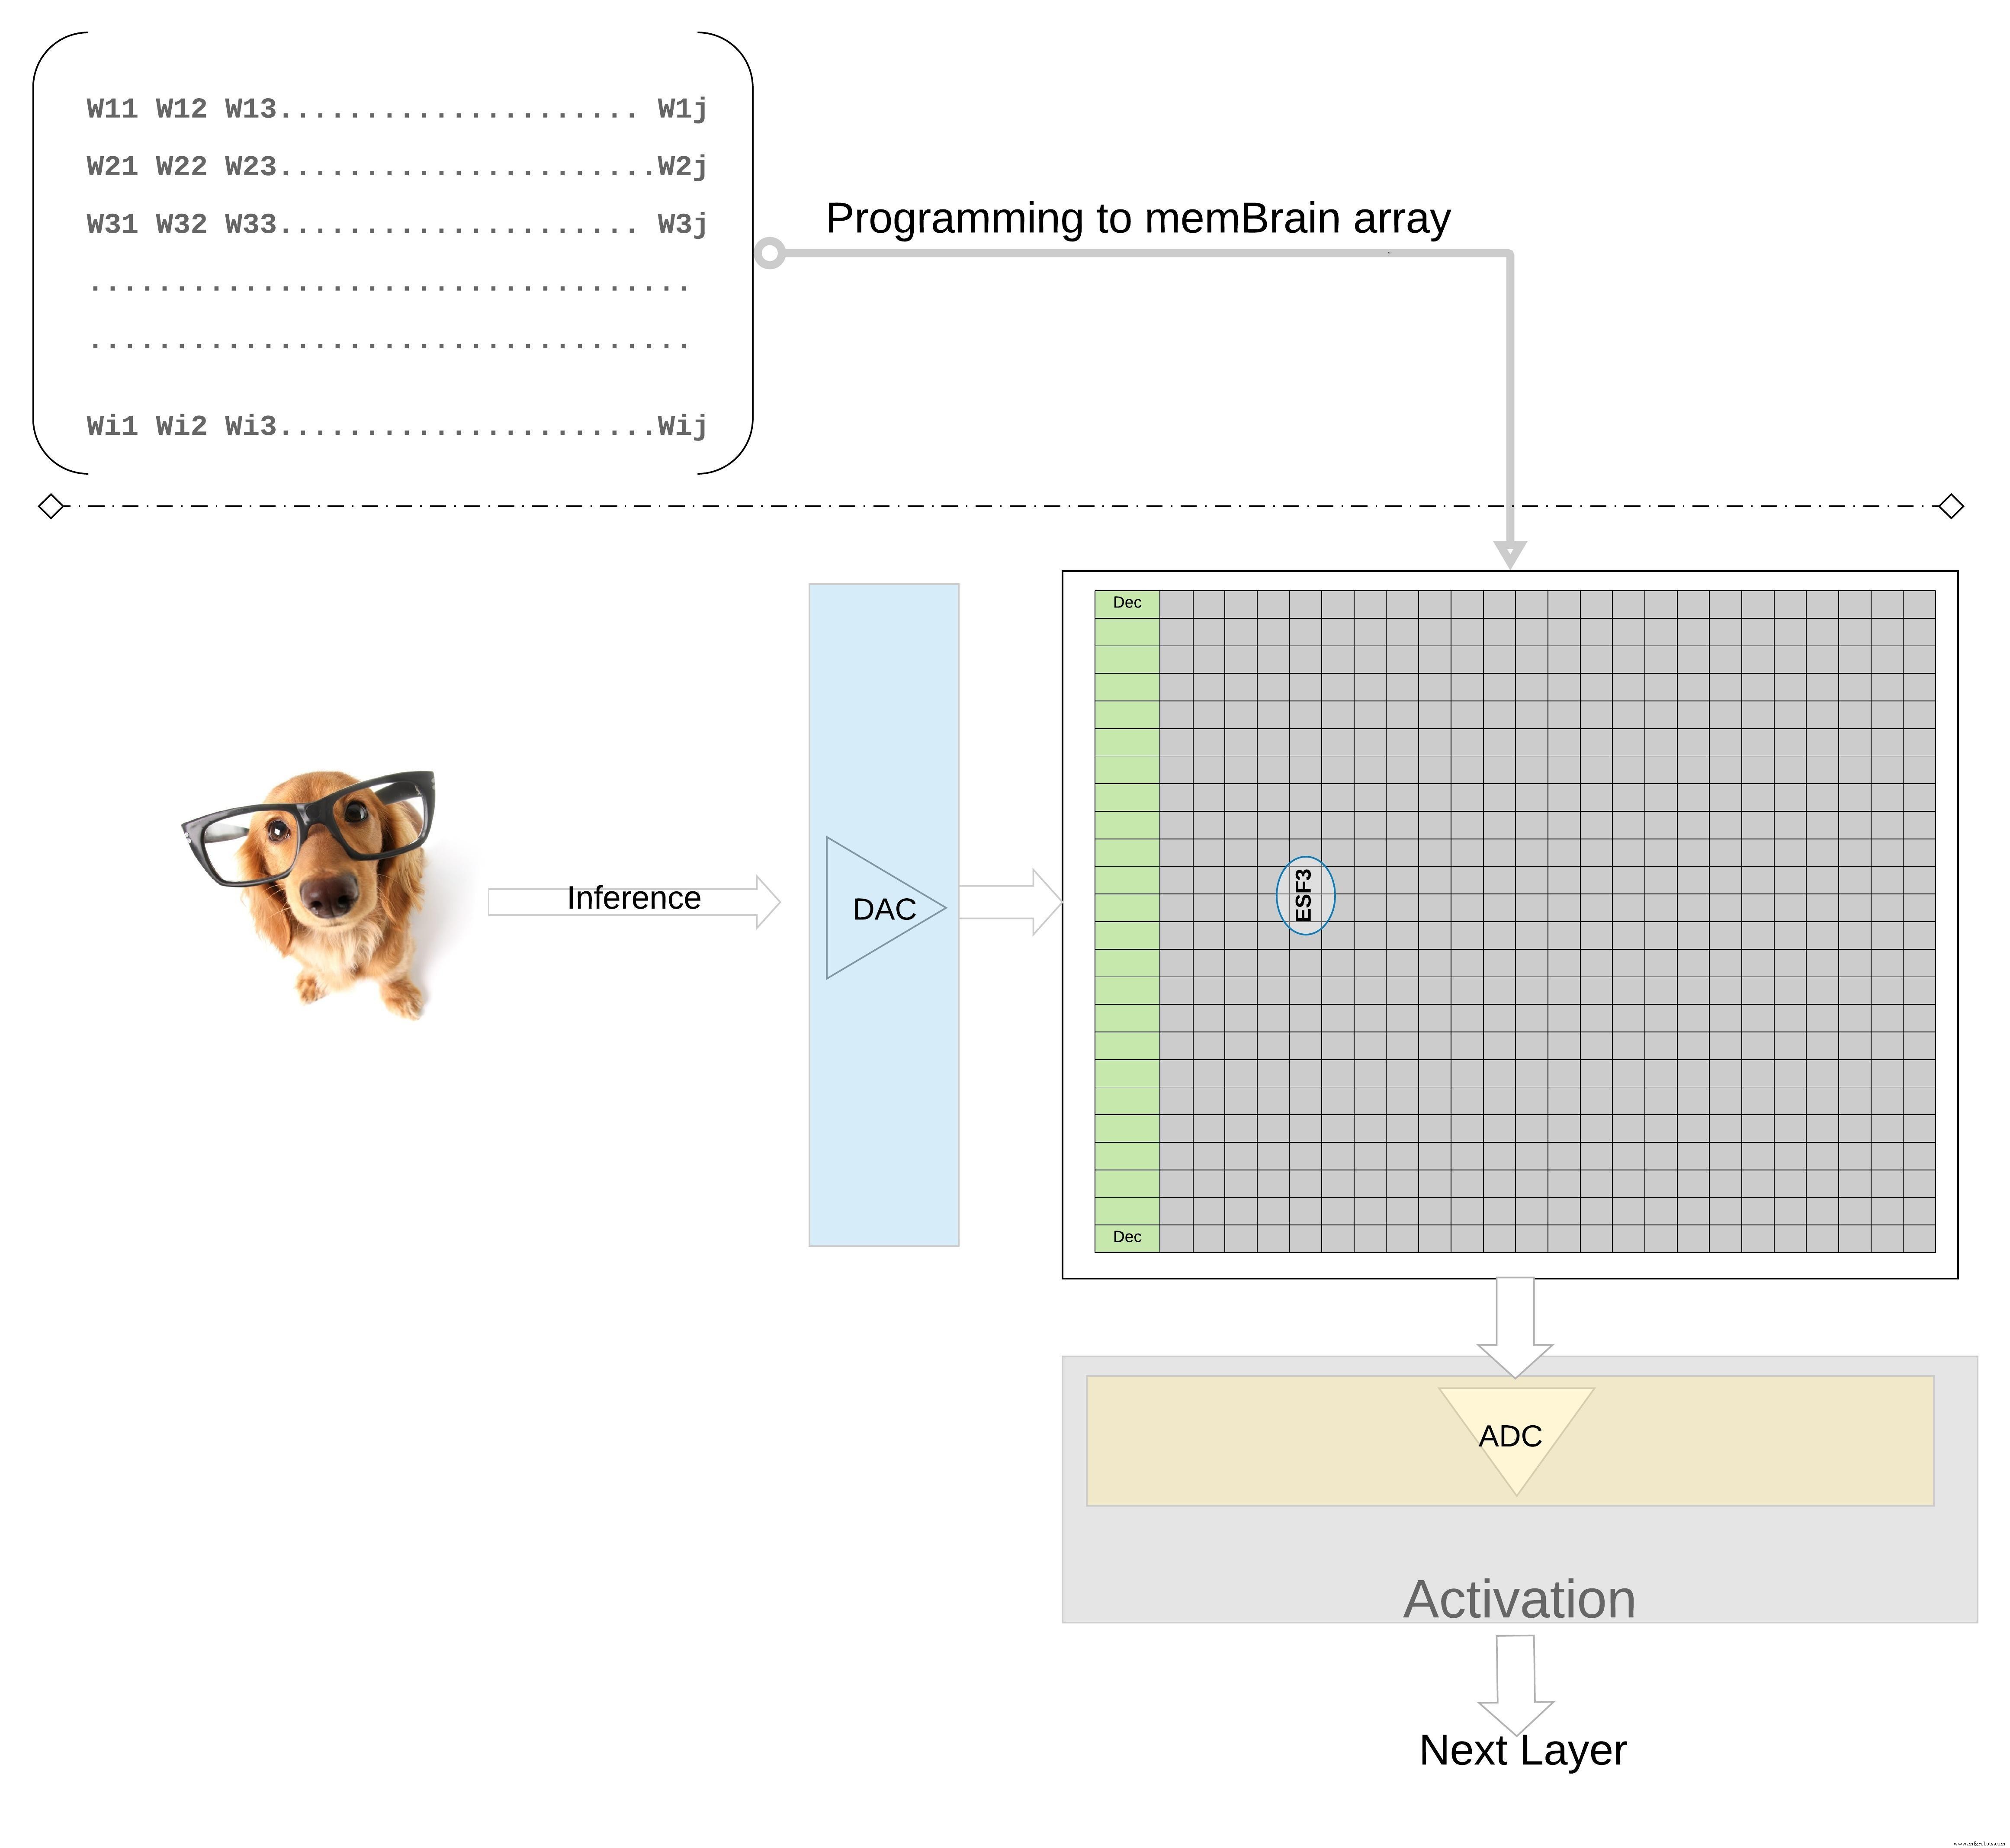
El flujo de inferencia es directo: datos de sensor se digitalizan, convierten a voltaje analógico por un DAC, se alimentan al array, y las corrientes de columna resultantes se digitalizan por un ADC para subsiguientes etapas de activación y pooling.
Modularidad y escalabilidad
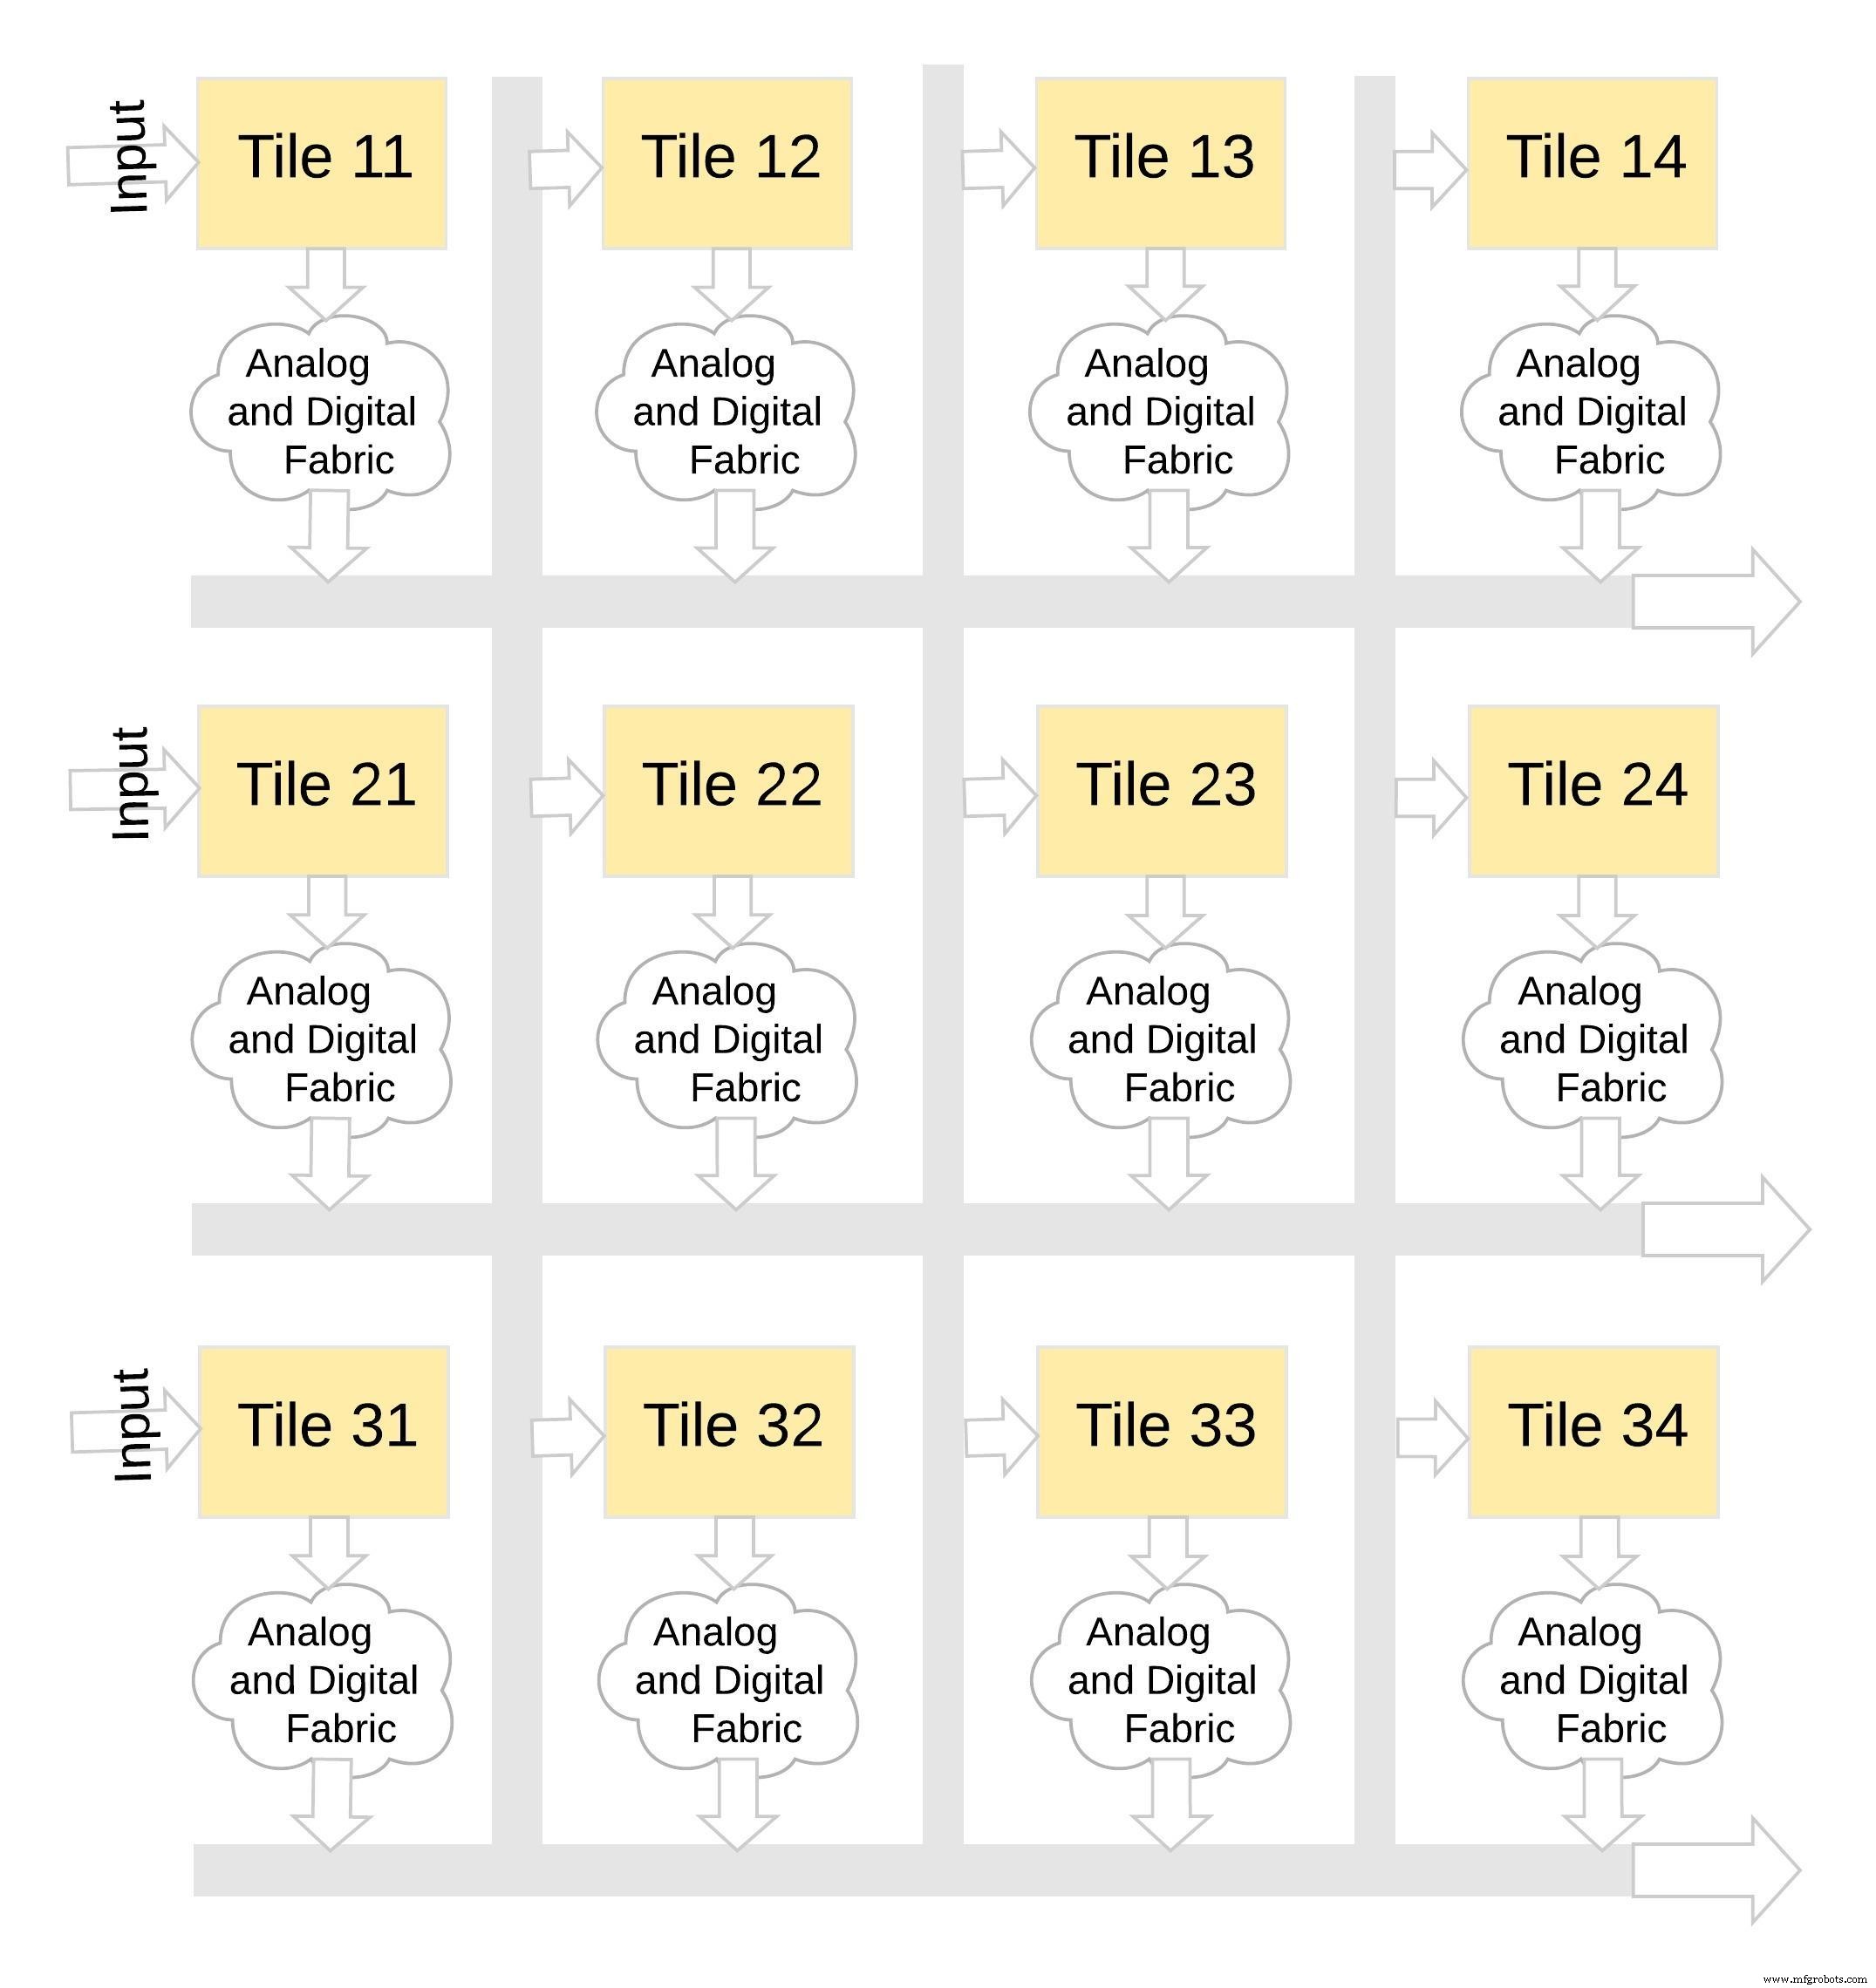
Los tiles memBrain están diseñados para apilarse. La Figura 8 muestra una configuración 3×4 donde múltiples tiles comparten un interconnect analógico-digital común. Los datos se mueven a través de tiles via un bus compartido, permitiendo construcción de redes profundas sin un solo die monolítico.
Software Development Kit (SDK)
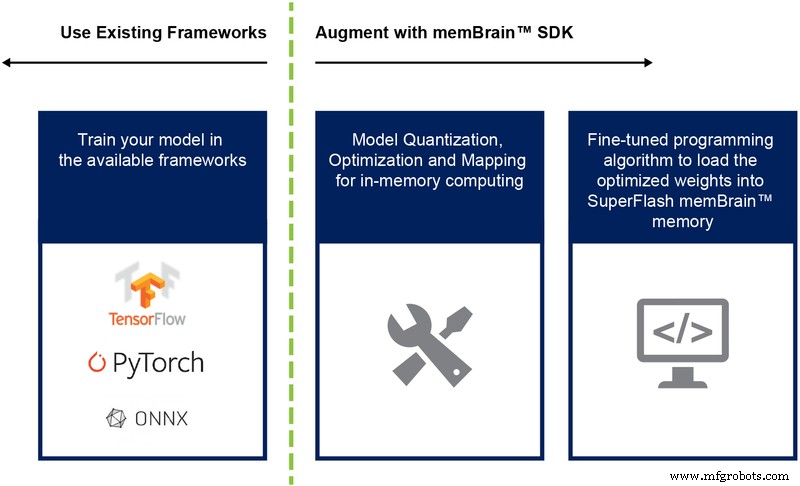
El SDK acompañante es framework-agnóstico. Ya sea que entrene en TensorFlow, PyTorch u otra librería, el SDK maneja cuantización de modelo, mapeo y despliegue al hardware memBrain. La Figura 9 esboza el workflow desde entrenamiento a inferencia.
Ventajas clave
- Ultra-bajo consumo — Computación en memoria elimina movimiento de datos, celdas flash operan sub-threshold, y no se necesita potencia en standby. La arquitectura también explota sparsidad, ya que pesos o entradas cero dejan celdas inactivas.
- Huella compacta — La celda split-gate de 1.5 transistores almacena un valor de 4 bits, mientras que un SRAM de 6 transistores requeriría 24 transistores para los mismos datos. El resultado es un área de die dramáticamente menor.
- Coste de desarrollo reducido — Al aprovechar procesos flash maduros y evitar la necesidad de geometrías ultra-densas, costes de mask set y lead times se reducen significativamente comparado a ASICs diseñados para edge AI.
La IA en el edge promete aplicaciones transformativas, pero potencia y coste siguen siendo factores limitantes. La computación analógica en memoria, respaldada por tecnología flash multi-nivel probada, ofrece un camino práctico y de bajo coste para llevar inferencia inteligente directamente al sensor.
Incrustado
- Cómo los cortes de energía amenazan sus fuentes de alimentación y cómo protegerlas
- Cómo los talleres de fabricación pequeños pueden adoptar soluciones digitales de forma rentable
- Aprovechando Tecnología Conectada para Resolver Desafíos Clave de la Cadena de Suministro
- Cómo el Edge Computing puede transformar la TI empresarial: Una perspectiva equilibrada
- Por qué la computación en la nube empodera a los equipos TI
- Edge Computing desmitificado: Casos de uso prácticos en transporte, utilities y manufactura
- Edge Computing: 5 Riesgos Potenciales — y Cómo Superarlos
- Aprovechando datos IIoT para impulsar la rentabilidad en manufactura esbelta
- Edge Computing: El catalizador que impulsa la Industria 4.0
- 6 razones convincentes para adoptar edge computing
- Computación en el borde y 5G: Impulsando la transformación empresarial