



Optimizando Tamaño de Capa Oculta para Impulsar Precisión de Red Neuronal
En este artículo, realizaremos experimentos de clasificación y analizaremos cómo la dimensionalidad de la capa oculta impacta el rendimiento de una red neuronal.
Aprenda cómo ajustar la capa oculta en un Perceptrón puede mejorar precisión, reducir tiempo de entrenamiento y mantener latencia aceptable —todo demostrado con una implementación en Python y datasets reales.
Antes de profundizar, revise publicaciones anteriores en nuestra serie de redes neuronales para construir una base sólida:
- Cómo Realizar Clasificación Usando una Red Neuronal: ¿Qué es el Perceptrón?
- Cómo Usar un Ejemplo Simple de Red Neuronal Perceptrón para Clasificar Datos
- Cómo Entrenar un Perceptrón Neuronal Básico
- Entendiendo el Entrenamiento Simple de Redes Neuronales
- Introducción a la Teoría de Entrenamiento para Redes Neuronales
- Entendiendo la Tasa de Aprendizaje en Redes Neuronales
- Aprendizaje Automático Avanzado con el Perceptrón Multicapa
- La Función de Activación Sigmoide: Activación en Redes Neuronales Perceptrón Multicapa
- Cómo Entrenar un Perceptrón Multicapa Neuronal
- Entendiendo Fórmulas de Entrenamiento y Retropropagación para Perceptrones Multicapa
- Arquitectura de Red Neuronal para una Implementación en Python
- Cómo Crear una Red Neuronal Perceptrón Multicapa en Python
- Procesamiento de Señales Usando Redes Neuronales: Validación en Diseño de Redes Neuronales
- Conjuntos de Datos de Entrenamiento para Redes Neuronales: Cómo Entrenar y Validar una Red Neuronal Python
- ¿Cuántas Capas Ocultas y Nodos Ocultos Necesita una Red Neuronal?
- Cómo Aumentar la Precisión de una Capa Oculta de Red Neuronal
El número de nodos en una capa oculta influye directamente en la precisión de clasificación y velocidad de entrenamiento. Nuestros experimentos proporcionarán intuición basada en datos para seleccionar un tamaño de capa oculta que balancee velocidad, latencia y precisión.
Benchmarking en Python
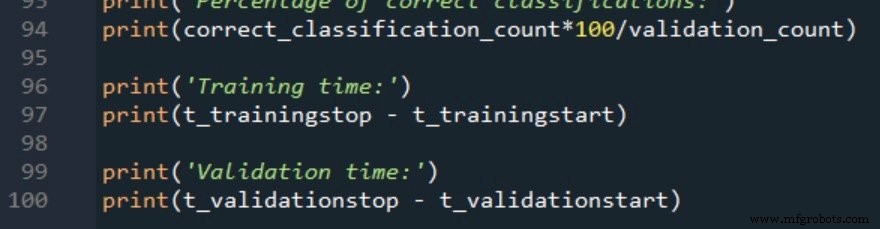
Aumentaremos el código Python existente de la Parte 12 para registrar duraciones de entrenamiento y validación usando time.perf_counter(). A continuación se muestra la instrumentación de tiempo:
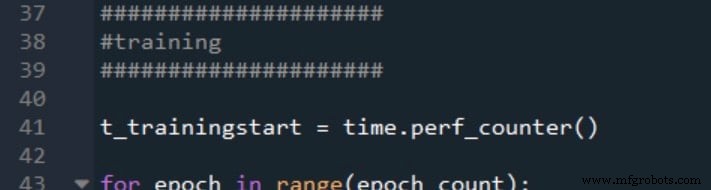
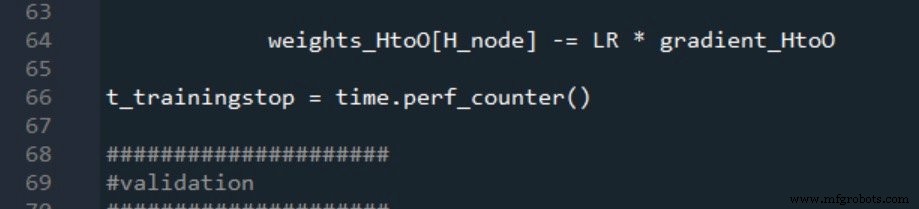
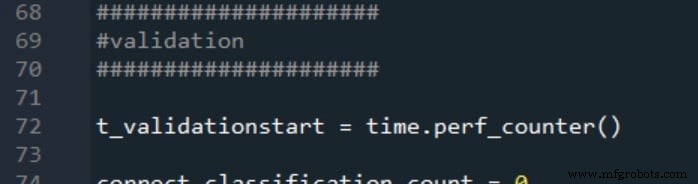
El tiempo de validación sigue el mismo patrón:
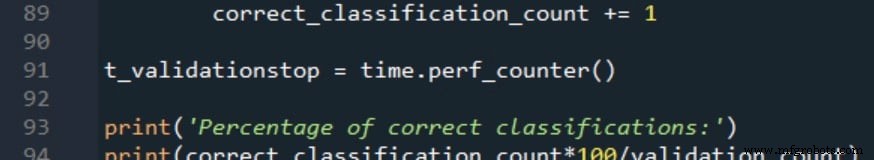
Los resultados se reportan como:
Datos de Entrenamiento y Procedimiento de Medición
Probamos una tarea de clasificación binaria usando cuatro entradas numéricas que van de –20 a +20. La arquitectura de red es 4 nodos de entrada, una sola capa oculta y un nodo de salida. Los valores de entrada se generan con la fórmula de Excel mostrada abajo:
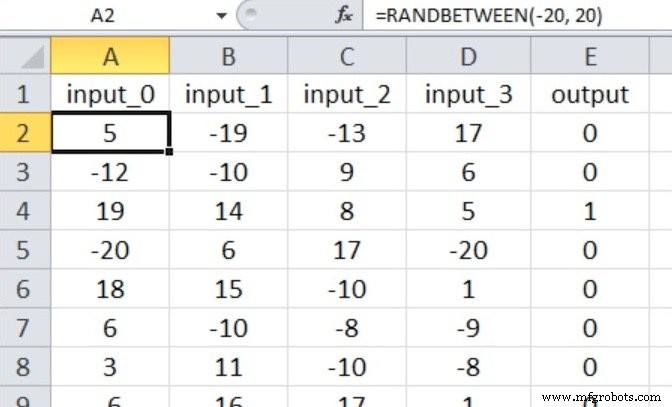
Tamaños de dataset: 40,000 muestras de entrenamiento y 5,000 de validación. Usamos tasa de aprendizaje de 0.1 y realizamos una época completa por ejecución. Cada dimensión de capa oculta se prueba cinco veces; la precisión y tiempos reportados son promedios aritméticos.
Experimento 1: Problema de Baja Complejidad
El objetivo es verdadero solo cuando las primeras tres entradas exceden cero; la cuarta entrada es irrelevante:
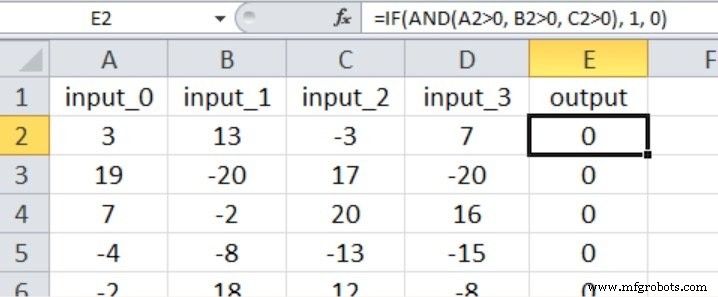
Siguiendo la guía de dos-tercios del tamaño de entrada, comenzamos con H_dim = 2. Los resultados se resumen a continuación:
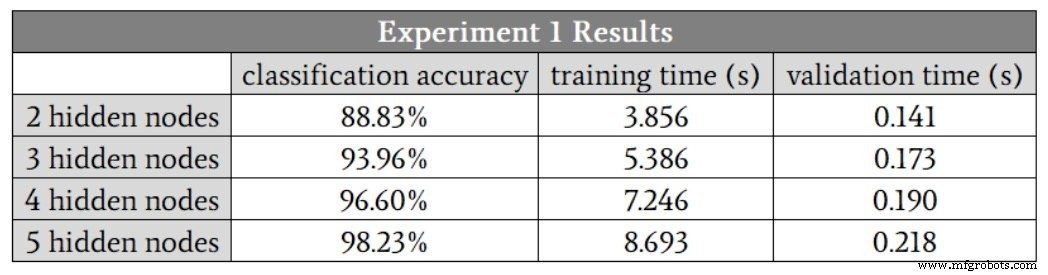
La precisión mejora hasta cinco nodos ocultos, pero la ganancia marginal de cuatro a cinco nodos es modesta porque una ejecución con cuatro nodos fue un outlier (88.6%). Eliminando ese outlier, cuatro nodos superan ligeramente a cinco. El tiempo de entrenamiento sube 1.9x de dos a cuatro nodos, mientras que el tiempo de validación aumenta solo 1.3x, subrayando que el entrenamiento es la fase computacionalmente más intensiva.
Experimento 2: Problema de Complejidad Moderada
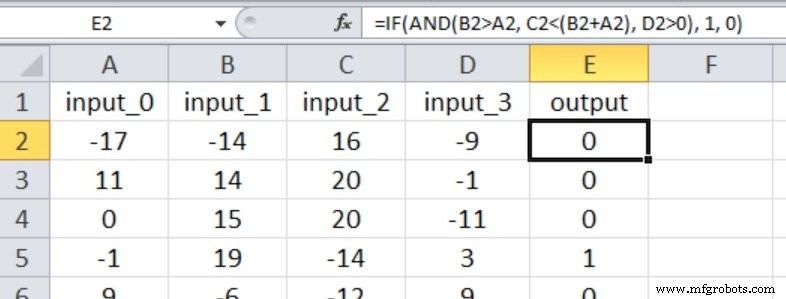
Todas las cuatro entradas influyen en la salida, con comparaciones más matizadas:
Comenzando con tres nodos ocultos, los resultados son:
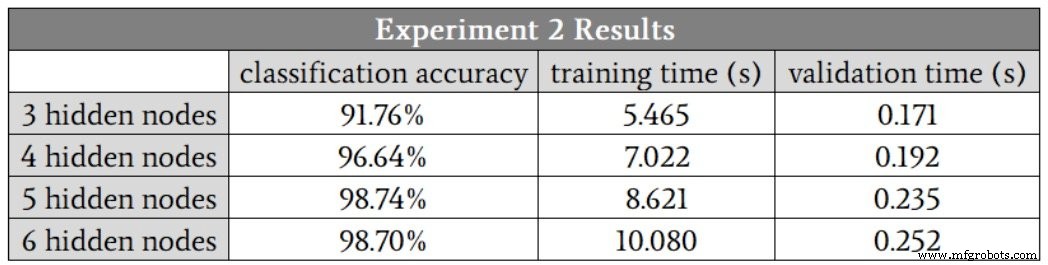
Aquí, cinco nodos ocultos parecen óptimos, balanceando precisión y velocidad. A diferencia del Experimento 1, las ejecuciones con cinco y seis nodos no muestran outliers de baja precisión, sugiriendo que capas ocultas mayores confieren robustez contra varianza de entrenamiento.
Experimento 3: Problema de Alta Complejidad
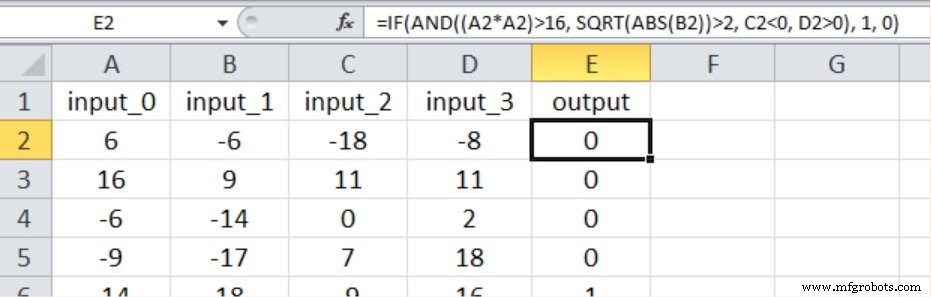
Este escenario introduce no linealidad: una entrada se eleva al cuadrado, otra se radica:
Los resultados son los siguientes:
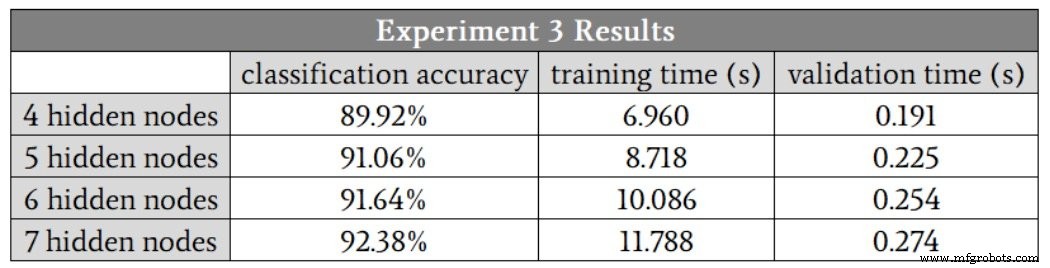
La precisión cae comparado con tareas de menor complejidad, incluso con siete nodos ocultos. Mejoras como agregar término de sesgo o recocer la tasa de aprendizaje podrían mejorar rendimiento, pero hasta que tales cambios se validen, se recomienda una capa oculta de siete nodos.
Conclusión
Estos experimentos ilustran un claro compromiso: aumentar la dimensionalidad de la capa oculta generalmente impulsa precisión y estabilidad pero a costa de tiempos de entrenamiento más largos. Use los insights basados en datos aquí para informar sus elecciones de diseño al construir clasificadores basados en Perceptrón.
Robot industrial
- Thomas WebTrax vs. Google Analytics y Thomas Network: ¿Qué herramienta impulsa tus leads industriales?
- Cómo los Sensores de Red 0G Protegen las Cadenas de Frío de Vacunas
- Elegiendo el Número Correcto de Capas Ocultas y Nodos en una Red Neuronal
- Entrenando Redes Neuronales con Excel: Construyendo y Validando un Perceptrón Multicapa en Python
- Construyendo una Red Neuronal Perceptrón Multicapa en Python: Guía Práctica
- Diseñando un Perceptrón Neuronal Flexible en Python: Arquitectura, Sesgo y Activación
- Entrene su Perceptrón Multicapa: Estrategias Probadas para Rendimiento Óptimo
- Elige el Sistema de Corte Láser Ideal: Maximiza Productividad y Precisión
- Entrenando un Perceptrón Neuronal Básico con Python: Guía Paso a Paso
- Cómo las redes conectadas están revolucionando la agricultura moderna
- Asegurando IoT del hardware a la aplicación: Un blueprint capa por capa