



Entrene su Perceptrón Multicapa: Estrategias Probadas para Rendimiento Óptimo
Podemos mejorar enormemente el rendimiento de un Perceptrón agregando una capa de nodos ocultos, pero esos nodos ocultos también complican un poco el entrenamiento.
Hasta ahora en la serie de AAC sobre redes neuronales, ha aprendido sobre clasificación de datos usando redes neuronales, especialmente de la variedad Perceptrón.
Póngase al día con la serie abajo o sumérjase en esta nueva entrada que explicará los fundamentos de la red neuronal perceptrón multicapa (MLP).
- Cómo Realizar Clasificación Usando una Red Neuronal: ¿Qué es el Perceptrón?
- Cómo Usar un Ejemplo Simple de Red Neuronal Perceptrón para Clasificar Datos
- Cómo Entrenar un Perceptrón Neuronal Básico
- Entendiendo el Entrenamiento Simple de Redes Neuronales
- Introducción a la Teoría de Entrenamiento para Redes Neuronales
- Entendiendo la Tasa de Aprendizaje en Redes Neuronales
- Aprendizaje Automático Avanzado con el Perceptrón Multicapa
- La Función de Activación Sigmoide: Activación en Redes Neuronales Perceptrón Multicapa
- Cómo Entrenar un Perceptrón Multicapa Neuronal
- Entendiendo Fórmulas de Entrenamiento y Retropropagación para Perceptrones Multicapa
- Arquitectura de Red Neuronal para una Implementación en Python
- Cómo Crear una Red Neuronal Perceptrón Multicapa en Python
- Procesamiento de Señales Usando Redes Neuronales: Validación en Diseño de Redes Neuronales
- Conjuntos de Datos de Entrenamiento para Redes Neuronales: Cómo Entrenar y Validar una Red Neuronal Python
¿Qué es una Red Neuronal Perceptrón Multicapa?
El artículo anterior demostró que un Perceptrón de capa simple simplemente no puede producir el tipo de rendimiento que esperamos de una arquitectura de red neuronal moderna. Un sistema limitado a funciones linealmente separables no podrá aproximar las complejas relaciones entrada-salida que ocurren en escenarios reales de procesamiento de señales. La solución es un perceptrón multicapa (MLP), como este:
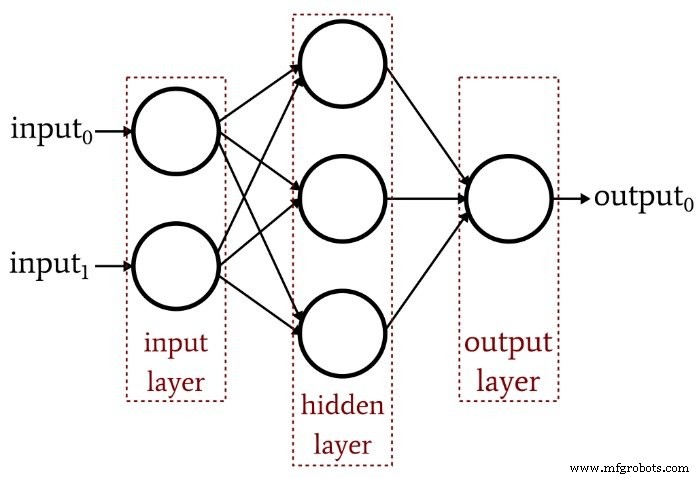
Al agregar esa capa oculta, convertimos la red en un "aproximador universal" que puede lograr clasificación extremadamente sofisticada. Pero siempre debemos recordar que el valor de una red neuronal depende completamente de la calidad de su entrenamiento. Sin abundantes datos de entrenamiento diversos y un procedimiento de entrenamiento efectivo, la red nunca "aprenderá" cómo clasificar muestras de entrada.
Por Qué la Capa Oculta Complica el Entrenamiento
Miremos la regla de aprendizaje que usamos para entrenar un Perceptrón de capa simple en un artículo anterior:
\[w_{new} = w+(\alpha\times(output_{expected}-output_{calculated})\times input)\]
Observe la suposición implícita en esta ecuación: Actualizamos los pesos basados en la salida observada, así que para que esto funcione, los pesos en el Perceptrón de capa simple deben influir directamente en el valor de salida. Es como elegir la temperatura del agua del grifo girando las dos perillas de caliente y frío. La relación entre temperatura general y acción de perilla es bastante directa, e incluso quienes no les gustan las matemáticas pueden encontrar la temperatura deseada jugueteando con las perillas un rato.
Pero ahora imagine que el flujo de agua a través de las tuberías de caliente y frío está relacionado con la posición de la perilla de una manera compleja y altamente no lineal. Usted gira constante y lentamente la perilla de agua caliente, pero la tasa de flujo resultante varía erráticamente. Prueba la perilla de agua fría y hace lo mismo. Establecer la temperatura ideal del agua bajo estas condiciones —especialmente ya que la "salida" debe lograrse a través de una combinación de dos relaciones de control confusas— sería mucho más difícil.
Así es como entiendo el dilema de la capa oculta. Los pesos que conectan los nodos de entrada a los nodos ocultos son conceptualmente análogos a esas perillas mecánicamente erráticas —porque los pesos entrada-a-oculta no tienen un camino directo a la capa de salida, la relación entre estos pesos y la salida de la red es tan compleja que la regla de aprendizaje simple mostrada arriba no será efectiva.
Un Nuevo Paradigma de Entrenamiento
Desde que la regla de aprendizaje original del Perceptrón no puede aplicarse a redes multicapa, necesitamos repensar nuestra estrategia de entrenamiento. Lo que vamos a hacer es incorporar descenso de gradiente y minimización de una función de error.
Una cosa a tener en cuenta es que este procedimiento de entrenamiento no es específico a redes neuronales multicapa. El descenso de gradiente viene de teoría de optimización general, y el procedimiento de entrenamiento que empleamos para MLPs también es aplicable a redes de capa simple. Sin embargo, como lo entiendo, el descenso de gradiente estilo MLP es (al menos teóricamente) innecesario para un Perceptrón de capa simple, porque la regla más simple mostrada arriba eventualmente hará el trabajo.
Derivar las ecuaciones reales de actualización de pesos para un MLP involucra matemáticas intimidantes que no intentaré explicar inteligentemente en esta coyuntura. Mi objetivo para el resto de este artículo es proporcionar una introducción conceptual a dos aspectos clave del entrenamiento MLP —descenso de gradiente y la función de error— y luego continuaremos esta discusión en el próximo artículo incorporando una nueva función de activación.
Descenso de Gradiente
Como el nombre implica, el descenso de gradiente es un medio de descender hacia el mínimo de una función de error basado en pendiente. El diagrama abajo transmite la forma en que un gradiente nos da información sobre cómo modificar pesos —la pendiente de un punto en la función de error nos dice en qué dirección necesitamos ir y qué tan lejos estamos del mínimo.
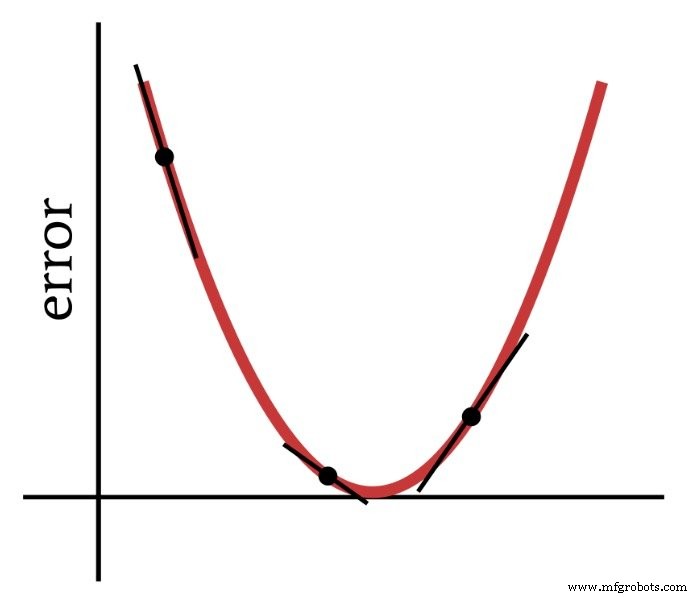
Así, la derivada de la función de error es un elemento importante de los cómputos que usamos para entrenar un Perceptrón Multicapa. En realidad, necesitaremos derivadas parciales aquí. Cuando implementamos descenso de gradiente, hacemos cada modificación de peso proporcional a la pendiente de la función de error con respecto al peso siendo modificado.
La Función de Error (AKA Función de Pérdida)
Un método común de cuantificar el error de una red neuronal es elevar al cuadrado la diferencia entre el valor esperado (u "objetivo") y el valor calculado para cada nodo de salida, y luego sumar todas estas diferencias al cuadrado. Puede llamar a esto "suma de diferencias al cuadrado" o "error cuadrático sumado" o quizás varias otras cosas, y también verá la abreviatura LMS, que significa least-mean-square, porque el objetivo del entrenamiento es minimizar el error cuadrático medio. Esta función de error (denotada por E) puede expresarse matemáticamente de la siguiente manera:
\[E=\frac{1}{2}\sum_k(t_k-o_k)^2\]
donde k indica el rango de nodos de salida, t es el valor de salida objetivo, y o es el valor de salida calculado.
Conclusión
Hemos sentado las bases para entrenar exitosamente un Perceptrón Multicapa, y continuaremos explorando este interesante tema en el próximo artículo.
Robot industrial
- Entendiendo Topologías de Red: De Punto a Punto a Anillo y Estrella
- Descubra su clave de seguridad de red: pasos fáciles para encontrar y proteger su Wi‑Fi
- Redes neuronales artificiales impulsan el rendimiento de comunicaciones inalámbricas
- Evaluando la Seguridad de la Red de Planta: ¿Está Preparado?
- Preparar la fuerza laboral del mañana para la Industria 4.0: estrategias de formación para la fábrica digital
- Mínimos Locales en Entrenamiento de Redes Neuronales: ¿Mito o Realidad?
- Cómo convertirse en electricista automotriz: formación, funciones y perspectivas laborales
- CEVA presenta NeuPro‑S: Procesador IA next‑gen para inferencia deep neural network en el edge
- Endureciendo Dispositivos IoT Industriales para Prevenir Ciberataques
- Cómo las redes conectadas están revolucionando la agricultura moderna
- Cómo las redes inteligentes impulsan la eficiencia y el crecimiento empresarial