



Mínimos Locales en Entrenamiento de Redes Neuronales: ¿Mito o Realidad?
Entendiendo el papel de los mínimos locales en el entrenamiento de perceptrones y redes neuronales multicapa.
En la serie de redes neuronales de AAC, hemos examinado muchos aspectos del diseño y entrenamiento de perceptrón multicapa. Antes de profundizar en mínimos locales, revise las publicaciones previas:
- Cómo Realizar Clasificación Usando una Red Neuronal: ¿Qué es el Perceptrón?
- Cómo Usar un Ejemplo Simple de Red Neuronal Perceptrón para Clasificar Datos
- Cómo Entrenar un Perceptrón Neuronal Básico
- Entendiendo el Entrenamiento Simple de Redes Neuronales
- Introducción a la Teoría de Entrenamiento para Redes Neuronales
- Entendiendo la Tasa de Aprendizaje en Redes Neuronales
- Aprendizaje Automático Avanzado con el Perceptrón Multicapa
- La Función de Activación Sigmoide: Activación en Redes Neuronales Perceptrón Multicapa
- Cómo Entrenar un Perceptrón Multicapa Neuronal
- Entendiendo Fórmulas de Entrenamiento y Retropropagación para Perceptrones Multicapa
- Arquitectura de Red Neuronal para una Implementación en Python
- Cómo Crear una Red Neuronal Perceptrón Multicapa en Python
- Procesamiento de Señales Usando Redes Neuronales: Validación en Diseño de Redes Neuronales
- Conjuntos de Datos de Entrenamiento para Redes Neuronales: Cómo Entrenar y Validar una Red Neuronal Python
- ¿Cuántas Capas Ocultas y Nodos Ocultos Necesita una Red Neuronal?
- Cómo Aumentar la Precisión de una Capa Oculta de Red Neuronal
- Incorporando Nodos de Sesgo en su Red Neuronal
- Entendiendo Mínimos Locales en Entrenamiento de Redes Neuronales
Entrenar una red neuronal es una tarea de optimización sofisticada. Si bien rara vez necesitamos entender cada matiz matemático para construir modelos efectivos, el fenómeno de los mínimos locales sigue siendo una consideración teórica crítica.
Por Qué Importan los Mínimos Locales
Históricamente, los mínimos locales se veían como un obstáculo mayor para el entrenamiento, especialmente para mapeos entrada-salida complejos. Investigaciones recientes —como estudios sobre geometría de superficie de pérdida (p. ej., Choromanska et al., 2015; Dauphin et al., 2014)— sugieren que arquitecturas modernas y heurísticas de entrenamiento reducen la severidad de este problema. No obstante, entender los mínimos locales nos ayuda a apreciar cómo los optimizadores basados en gradiente navegan paisajes de pérdida de alta dimensionalidad y por qué ciertas estrategias de entrenamiento pueden escapar de puntos subóptimos.
Definiendo un Mínimo Local
Considere una superficie de error cuadrática simple: f(x, y) = x² + y². Cualquier punto que produzca el error más bajo posible —llamado mínimo global— es el objetivo del entrenamiento. En un cuenco perfectamente convexo, el descenso de gradiente siempre convergerá a este punto sin importar la posición inicial.
En la práctica, las superficies de pérdida están lejos de ser convexas. Pueden contener múltiples valles y mesetas, como se ilustra a continuación:
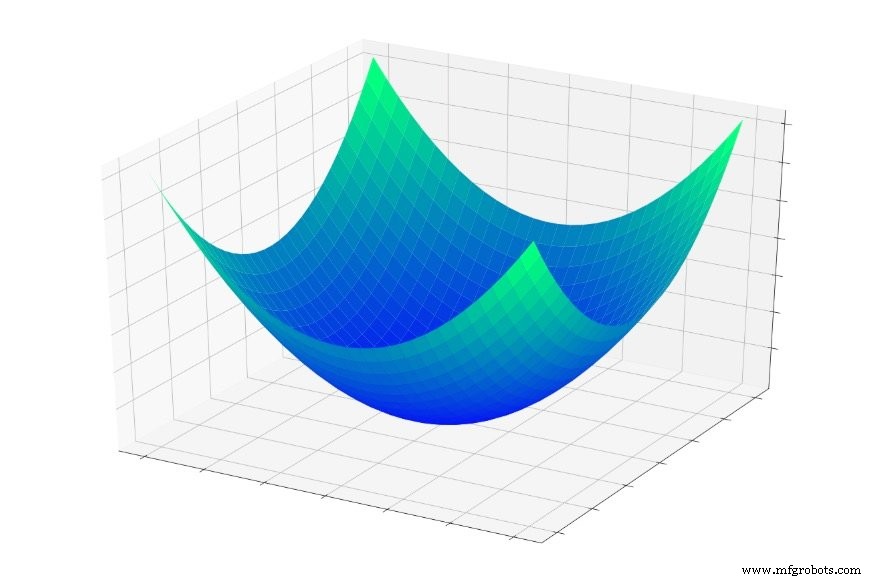
Cuando el optimizador entra en una cuenca poco profunda, puede asentarse en un mínimo local —el punto más bajo dentro de esa región local— pero no el global. Sin conocimiento global, el algoritmo no puede "escalar" de vuelta para explorar valles más profundos.
¿Realmente Necesitamos el Mínimo Global?
Si bien alcanzar el mínimo global a menudo correlaciona con menor error de entrenamiento, no siempre es sinónimo de mejor generalización. Redes altamente expresivas que logran un ajuste perfecto en datos de entrenamiento pueden sobreajustar, reduciendo rendimiento en muestras no vistas. En tales casos, un mínimo local bien ubicado puede proveer una solución más robusta. Además, los puntos de silla —regiones planas donde los gradientes se anulan en algunas direcciones— pueden plantear un desafío mayor que simples mínimos locales (Goodfellow et al., 2015).
Implicaciones Prácticas
Prácticas modernas de entrenamiento mitigan efectos de mínimos locales mediante técnicas como descenso de gradiente estocástico, programación de tasa de aprendizaje, momentum, optimizador Adam y esquemas de inicialización de pesos. Métodos de ensemble y regularización (dropout, L2) también ayudan al modelo a evitar sobreajuste al mínimo global.
Conclusión
Los mínimos locales permanecen como un aspecto fascinante del entrenamiento de redes neuronales. Entender su impacto informa la elección de arquitectura, optimizador y estrategia de regularización. En el próximo artículo, exploraremos técnicas concretas —como recocido de tasa de aprendizaje y optimizadores adaptativos— que guían redes hacia mínimos deseables.
Robot industrial
- Entendiendo Topologías de Red: De Punto a Punto a Anillo y Estrella
- Entendiendo Protocolos de Red: De Capa Física a Arbitraje Avanzado
- Redes neuronales artificiales impulsan el rendimiento de comunicaciones inalámbricas
- Entrenar una gran red neuronal genera 284.000 kg de CO₂ —Equivalente a 5 coches durante su vida útil
- Agregando Nodos de Sesgo a un Perceptrón Multicapa en Python
- Optimizando Tamaño de Capa Oculta para Impulsar Precisión de Red Neuronal
- Elegiendo el Número Correcto de Capas Ocultas y Nodos en una Red Neuronal
- Corte por láser de fibra robótico vs corte por plasma: diferencias clave y cómo elegir la solución adecuada
- STMicroelectronics lanza STM32Cube.AI: potenciando dispositivos edge con redes neuronales embebidas
- CEVA presenta NeuPro‑S: Procesador IA next‑gen para inferencia deep neural network en el edge
- Red Neuronal de NIST Detecta Pequeñas Formas Geométricas en Imágenes Densas con 97% de Precisión