



Construyendo un Autoencoder Variacional con TensorFlow: Guía Práctica
Domine los fundamentos de los autoencoders, descubra cómo los autoencoders variacionales los mejoran y recorra una implementación paso a paso en TensorFlow.
La inteligencia artificial ha transformado innumerables sectores, y la compresión de datos no es la excepción. Los autoencoders —especialmente sus variantes variacionales— proporcionan esquemas de compresión generativos potentes que son tanto eficientes como expresivos. Esta guía desglosa los conceptos centrales y lo lleva a través de una implementación completa de TensorFlow usando el dataset MNIST.
Aplicaciones de Autoencoders
Los autoencoders son ampliamente adoptados en campos que van desde traducción automática neuronal hasta descubrimiento de fármacos, desruido de imágenes y detección de anomalías. Su capacidad para aprender representaciones comprimidas e informativas los convierte en una herramienta imprescindible para pipelines modernos de ML.
Componentes Clave de un Autoencoder
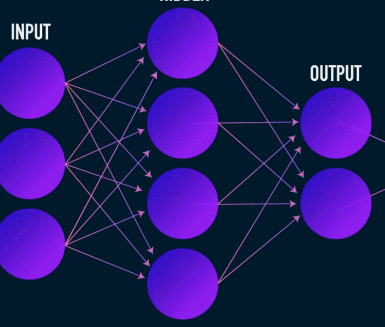
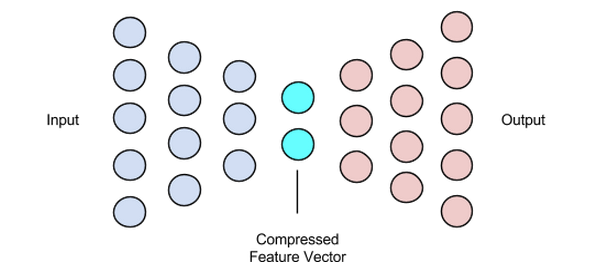
A diferencia de redes neuronales típicas, los autoencoders presentan un cuello de botella que fuerza una representación latente de baja dimensionalidad. La arquitectura comprende tres partes primarias:
- Codificador – comprime datos de entrada en un vector latente.
- Cuello de Botella (Vector Latente) – almacena las características más salientes.
- Decodificador – reconstruye la entrada desde el vector latente.
El codificador y decodificador suelen ser redes feed-forward, pero variantes especializadas —convolucionales para imágenes, recurrentes para texto— son comunes en la práctica.
Codificador
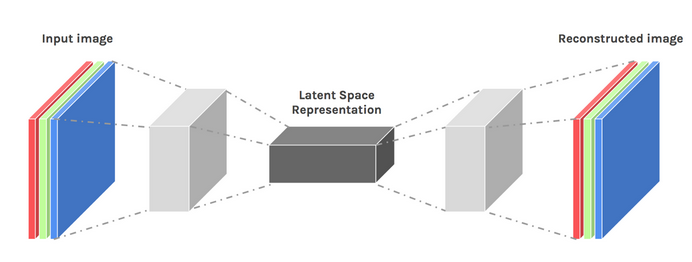
El codificador mapea entradas de alta dimensionalidad (p. ej., imágenes de 28×28 píxeles) a un vector latente compacto. Durante el entrenamiento, optimiza sus pesos para que el vector latente capture información esencial, permitiendo al decodificador reconstruir la entrada con pérdida mínima.
Cuello de Botella (Vector Latente)
El tamaño del vector latente es un compromiso: demasiado pequeño y pierdes detalle crítico; demasiado grande y socavas la compresión e inflas la computación. Seleccionar una dimensionalidad apropiada es crucial para el rendimiento del modelo.
Decodificador
El decodificador es un espejo del codificador, transformando el vector latente de vuelta al espacio de datos original. Típicamente usa convoluciones transpuestas o capas de upsampling para recuperar resolución espacial.
Entrenando Autoencoders
Los autoencoders se entrenan end-to-end usando optimizadores basados en gradiente como Adam. El objetivo es minimizar una pérdida de reconstrucción que cuantifica la discrepancia entre la entrada y su reconstrucción.
Funciones de Pérdida
Opciones comunes incluyen L1, L2 y error cuadrático medio (MSE). Cada una mide qué tan cerca está la salida de la entrada, haciéndolas adecuadas para tareas de reconstrucción generativa.
Variantes de Red
Si bien perceptrones multicapa (MLP) pueden servir como codificadores/decodificadores, las redes neuronales convolucionales (CNN) son preferidas para datos de imagen debido a su conciencia espacial. Las redes recurrentes destacan con datos secuenciales como texto.
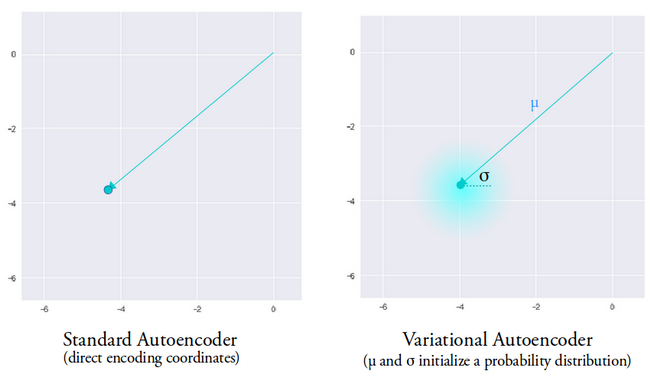
Los autoencoders estándar carecen de creatividad —solo pueden reproducir datos vistos durante el entrenamiento. Introducir estocasticidad vía un marco variacional desbloquea capacidades generativas.
Autoencoders Variacionales (VAEs)
Los VAE modifican la arquitectura estándar de dos maneras:
- El codificador produce un vector de media y un vector de varianza, definiendo una distribución Gaussiana.
- Un término de divergencia Kullback-Leibler (KL) se añade a la pérdida para regularizar la distribución latente hacia una Gaussiana unitaria.
Durante la inferencia, el codificador muestrea un vector latente de la distribución aprendida, permitiendo al decodificador generar reconstrucciones diversas y realistas. Esta estocasticidad mitiga las discontinuidades a menudo observadas en autoencoders deterministas.
Implementación en TensorFlow
A continuación se muestra una implementación concisa, lista para producción, de un VAE convolucional entrenado en MNIST.
Preparación de Datos
(train_images, _), (test_images, _) = tf.keras.datasets.mnist.load_data()
train_images = train_images.reshape(-1, 28, 28, 1).astype('float32')
test_images = test_images.reshape(-1, 28, 28, 1).astype('float32')
train_images /= 255.
test_images /= 255.
train_images[train_images >= .5] = 1.
train_images[train_images < .5] = 0.
test_images[test_images >= .5] = 1.
test_images[test_images < .5] = 0.
TRAIN_BUF = 60000
BATCH_SIZE = 100
TEST_BUF = 10000
train_dataset = tf.data.Dataset.from_tensor_slices(train_images).shuffle(TRAIN_BUF).batch(BATCH_SIZE)
test_dataset = tf.data.Dataset.from_tensor_slices(test_images).shuffle(TEST_BUF).batch(BATCH_SIZE)
Definición del Modelo VAE
class CVAE(tf.keras.Model):
    def __init__(self, latent_dim):
        super(CVAE, self).__init__()
        self.latent_dim = latent_dim
        self.inference_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(28, 28, 1)),
            tf.keras.layers.Conv2D(32, 3, strides=2, activation='relu'),
            tf.keras.layers.Conv2D(64, 3, strides=2, activation='relu'),
            tf.keras.layers.Flatten(),
            tf.keras.layers.Dense(latent_dim + latent_dim), # mean & logvar
        ])
        self.generative_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(latent_dim,)),
            tf.keras.layers.Dense(7*7*32, activation='relu'),
            tf.keras.layers.Reshape((7, 7, 32)),
            tf.keras.layers.Conv2DTranspose(64, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(32, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(1, 3, padding='SAME'), # logits
        ])
    @tf.function
    def sample(self, eps=None):
        if eps is None:
            eps = tf.random.normal(shape=(100, self.latent_dim))
        return self.decode(eps, apply_sigmoid=True)
    def encode(self, x):
        mean, logvar = tf.split(self.inference_net(x), num_or_size_splits=2, axis=1)
        return mean, logvar
    def reparameterize(self, mean, logvar):
        eps = tf.random.normal(shape=mean.shape)
        return eps * tf.exp(logvar * .5) + mean
    def decode(self, z, apply_sigmoid=False):
        logits = self.generative_net(z)
        if apply_sigmoid:
            return tf.sigmoid(logits)
        return logits
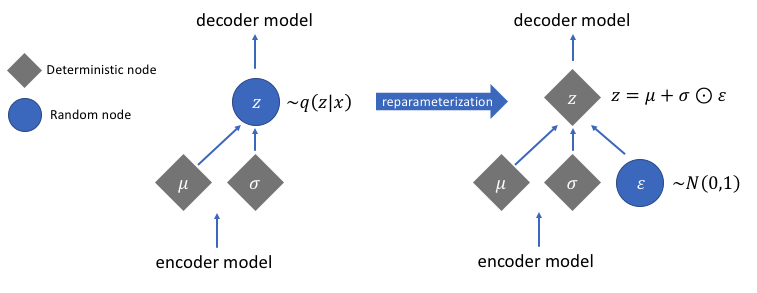
Funciones auxiliares clave —encode, reparameterize y decode— encapsulan el flujo de trabajo del VAE. El método reparameterize implementa el truco de reparametrización, permitiendo flujo de gradiente a través de muestreo estocástico.
Truco de Reparametrización
Muestrear un vector latente directamente de una distribución rompe la diferenciabilidad. Al expresar la muestra como z = mean + std * eps donde eps ~ N(0,1), los gradientes propagan a través de mean y std. El término de divergencia KL alinea además la distribución aprendida con una normal estándar, promoviendo espacios latentes suaves.
Resumen Rápido de Pasos
- Definir arquitecturas de codificador y decodificador.
- Implementar el truco de reparametrización para habilitar retropropagación.
- Entrenar el modelo end-to-end, minimizando pérdida de reconstrucción más divergencia KL.
Para el código completo y scripts de entrenamiento adicionales, visite el tutorial oficial de TensorFlow.
Crédito de imagen: Chiman Kwan (modificado)
Robot industrial
- Hoja de ruta impulsada por IA: Guía estratégica para empresas de cadena de suministro
- Aprovechando minería de datos e IA: La hoja de ruta de marcas industriales para prosperar en el comercio electrónico
- Optimizando la Vida de la Herramienta con Datos de Máquina: Una Guía Moderna
- Reduciendo Desperdicios y Costes Energéticos con Robots Autónomos
- Automatice el cuidado de máquinas CNC con cobots: Aumente la eficiencia y la precisión
- Cómo las Impresoras 3D Fabrican Piezas Metálicas: Del Polvo a la Precisión
- Asegurando tecnología cloud: Mejores prácticas para protección de datos y mitigación de riesgos
- Aprovechar los datos en el Internet de la Fiabilidad: estrategias para una gestión efectiva
- Aprovechando IoT para Big Data en HVAC: optimizando energía, confort y calidad de aire — Parte 2
- Dando Vida a IoT con IBM y Tech Data – Parte 2
- Convirtiendo IoT en Realidad: Insights de Tech Data e IBM – Parte 1