



Elegiendo el Número Correcto de Capas Ocultas y Nodos en una Red Neuronal
Este artículo ofrece guías basadas en evidencia para configurar la porción oculta de un Perceptrón Multicapa.
En publicaciones previas de esta serie cubrimos redes Perceptrón, arquitecturas multicapa e implementaciones prácticas en Python. Antes de decidir la profundidad y amplitud de sus capas ocultas, puede querer revisar los artículos fundamentales listados abajo.
- Cómo Realizar Clasificación Usando una Red Neuronal: ¿Qué es el Perceptrón?
- Cómo Usar un Ejemplo Simple de Red Neuronal Perceptrón para Clasificar Datos
- Cómo Entrenar un Perceptrón Neuronal Básico
- Entendiendo el Entrenamiento Simple de Redes Neuronales
- Introducción a la Teoría de Entrenamiento para Redes Neuronales
- Entendiendo la Tasa de Aprendizaje en Redes Neuronales
- Aprendizaje Automático Avanzado con el Perceptrón Multicapa
- La Función de Activación Sigmoide: Activación en Redes Neuronales Perceptrón Multicapa
- Cómo Entrenar un Perceptrón Multicapa Neuronal
- Entendiendo Fórmulas de Entrenamiento y Retropropagación para Perceptrones Multicapa
- Arquitectura de Red Neuronal para una Implementación en Python
- Cómo Crear una Red Neuronal Perceptrón Multicapa en Python
- Procesamiento de Señales Usando Redes Neuronales: Validación en Diseño de Redes Neuronales
- Conjuntos de Datos de Entrenamiento para Redes Neuronales: Cómo Entrenar y Validar una Red Neuronal Python
- Elegiendo el Número Correcto de Capas Ocultas y Nodos en una Red Neuronal
Repaso de Capas Ocultas
Repasemos puntos clave sobre nodos ocultos:
- Perceptrones de capa única —redes que contienen solo nodos de entrada y salida— están limitados a problemas linealmente separables. No pueden modelar relaciones complejas como la función booleana XOR.
- Introducir una capa oculta transforma el Perceptrón en un aproximador universal, permitiéndole aprender virtualmente cualquier mapeo continuo entre espacios de entrada y salida finitos.
- Los pesos oculto-salida influyen en el error final indirectamente, haciendo el entrenamiento más intrincado.
- La retropropagación es el método de entrenamiento estándar: el error se propaga hacia atrás a través de la red, permitiéndonos actualizar todos los pesos no de salida, sin importar el número de capas ocultas.
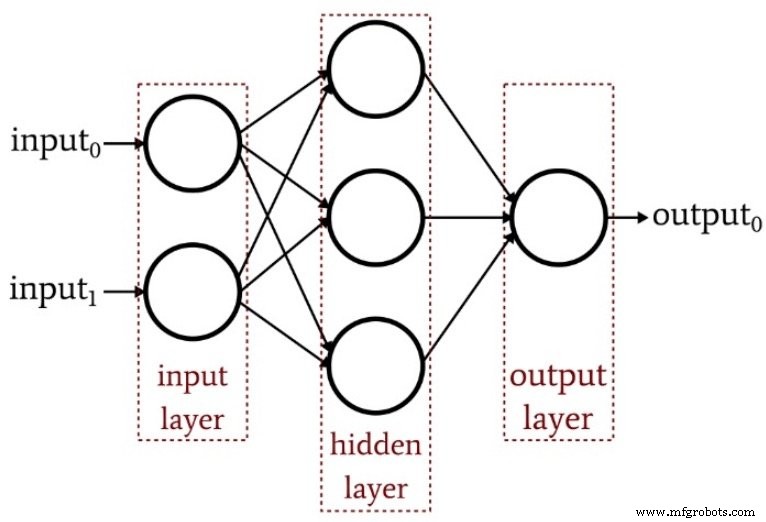
El diagrama abajo ilustra la estructura básica de un Perceptrón Multicapa.
¿Cuántas Capas Ocultas?
No hay una respuesta única para todos. Sin embargo, una sola capa oculta ya dota a una red de notable poder expresivo. Si el rendimiento es insatisfactorio, considere ajustar la tasa de aprendizaje, extender épocas de entrenamiento o enriquecer el conjunto de entrenamiento antes de añadir profundidad.
Añadir una segunda capa oculta aumenta complejidad de código y tiempo de inferencia, y puede exacerbar el sobreajuste —especialmente cuando los datos de entrenamiento son limitados.
El sobreajuste ocurre cuando la red memoriza idiosincrasias del conjunto de entrenamiento en lugar de aprender un mapeo generalizable. El siguiente diagrama visualiza este fenómeno.
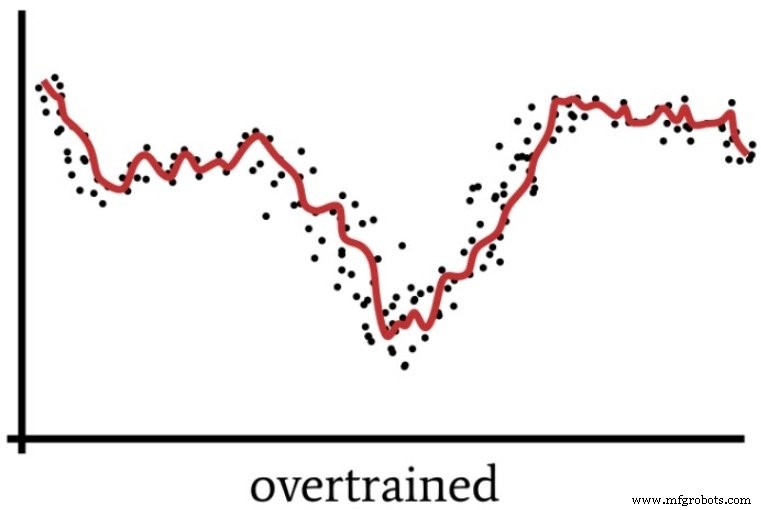
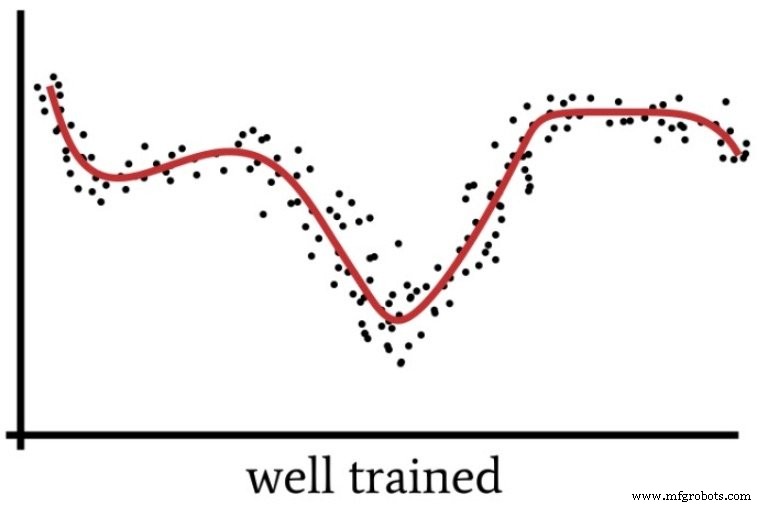
Una red altamente parametrizada puede "sobrepensar" un problema, produciendo una solución que funciona bien en datos de entrenamiento pero mal en muestras no vistas. La figura subsiguiente muestra cómo la capacidad excesiva puede obstaculizar la generalización.
¿Cuándo está justificada una capa oculta extra? El Dr. Jeff Heaton, en su libro exhaustivo sobre entrenamiento de redes neuronales, señala que una sola capa oculta puede aproximar cualquier función continua entre espacios finitos. Añadir una segunda capa permite a la red representar fronteras de decisión con precisión arbitraria, pero solo cuando la complejidad del problema realmente lo justifica.
¿Cuántos Nodos Ocultos?
Elegir el número correcto de nodos por capa oculta es un balance entre expresividad y riesgo de sobreajuste. Si bien la experimentación es esencial, el Dr. Heaton proporciona tres heurísticas prácticas (p. 159) que sirven como punto de partida sólido. Basado en experiencia en procesamiento de señales, sugiero las siguientes guías:
- Si la red tiene un solo nodo de salida y el mapeo es relativamente simple, establezca la dimensionalidad oculta a dos-tercios de la dimensionalidad de entrada.
- Si hay múltiples salidas o la relación es compleja, use un tamaño oculto igual a la suma de dimensiones de entrada y salida —manteniéndolo por debajo del doble del tamaño de entrada.
- Para mapeos extremadamente intrincados, establezca el tamaño oculto a uno menos que el doble de la dimensionalidad de entrada.
Conclusión
Siguiendo estos principios, puede configurar y refinar sistemáticamente las capas ocultas de un Perceptrón Multicapa para lograr rendimiento robusto. En nuestro próximo artículo demostraremos cómo estas reglas se traducen en código Python concreto y evaluaremos su impacto en datasets reales.
Robot industrial
- Agregando Nodos de Sesgo a un Perceptrón Multicapa en Python
- Optimizando Tamaño de Capa Oculta para Impulsar Precisión de Red Neuronal
- Entrenando Redes Neuronales con Excel: Construyendo y Validando un Perceptrón Multicapa en Python
- Construyendo una Red Neuronal Perceptrón Multicapa en Python: Guía Práctica
- Dominando Actualizaciones de Pesos y Retropropagación en Perceptrones Multicapa
- ¿Qué es una prensa de palanca? Cómo funciona y por qué importa
- Cómo Operan las Prensas de Cremallera y Piñón: Guía Práctica
- Moldeo por Transferencia Explicado: Proceso, Ventajas y Variantes
- Comprendiendo las Transmisiones de Vehículos: Tipos, Funciones y Cómo Operan
- Comprendiendo los Embragues Industriales: Definición, Funcionamiento y Aplicaciones
- Cómo Determinar la Potencia Necesaria para su Bomba Hidráulica