



Construyendo una Red Neuronal Perceptrón Multicapa en Python: Guía Práctica
Este artículo lo guía a través de un programa Python que entrena una red neuronal para clasificación avanzada.
Esta es la 12ª entrada en la serie de desarrollo de redes neuronales de AAC. Vea qué más ofrece la serie abajo:
- Cómo Realizar Clasificación Usando una Red Neuronal: ¿Qué es el Perceptrón?
- Cómo Usar un Ejemplo Simple de Red Neuronal Perceptrón para Clasificar Datos
- Cómo Entrenar un Perceptrón Neuronal Básico
- Entendiendo el Entrenamiento Simple de Redes Neuronales
- Introducción a la Teoría de Entrenamiento para Redes Neuronales
- Entendiendo la Tasa de Aprendizaje en Redes Neuronales
- Aprendizaje Automático Avanzado con el Perceptrón Multicapa
- La Función de Activación Sigmoide: Activación en Redes Neuronales Perceptrón Multicapa
- Cómo Entrenar un Perceptrón Multicapa Neuronal
- Entendiendo Fórmulas de Entrenamiento y Retropropagación para Perceptrones Multicapa
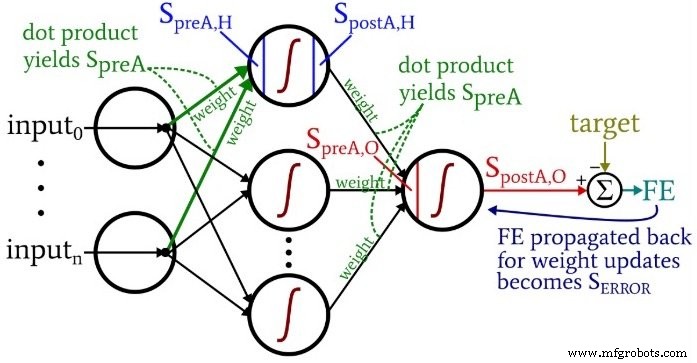
- Arquitectura de Red Neuronal para una Implementación en Python
- Cómo Crear una Red Neuronal Perceptrón Multicapa en Python
- Procesamiento de Señales Usando Redes Neuronales: Validación en Diseño de Redes Neuronales
- Conjuntos de Datos de Entrenamiento para Redes Neuronales: Cómo Entrenar y Validar una Red Neuronal Python
En este artículo, construiremos sobre nuestro trabajo con redes perceptrón simples y lo extendemos a un perceptrón multicapa (MLP) completamente funcional implementado en Python.
Desarrollando Código Python Comprensible para Redes Neuronales
Después de revisar numerosos recursos en línea, encontré que muchas implementaciones son o demasiado complejas o carecen de claridad. Mi objetivo era crear un programa que sea tanto educativo como intuitivo, permitiendo a lectores ver cómo la teoría se traduce en código.
Si bien este script prioriza legibilidad sobre rendimiento bruto, sigue siendo una base sólida para experimentación. Aplicaciones del mundo real a menudo demandan código optimizado para manejar grandes datasets, pero para aprendizaje y proyectos de pequeña escala, la claridad es más valiosa.
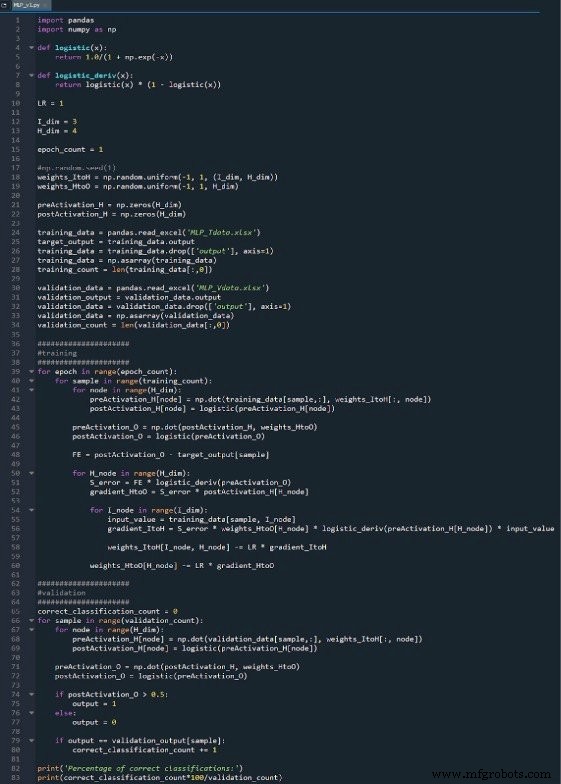
El código fuente completo está disponible como imagen abajo y puede descargarse como MLP_v1.py. El código realiza entrenamiento y validación, con el foco de esta publicación en el proceso de entrenamiento.
Preparando Funciones y Variables
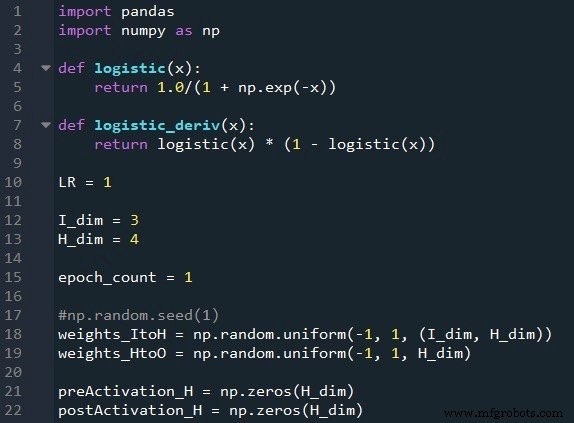
La librería NumPy maneja todas las operaciones numéricas, mientras que Pandas facilita importación fácil de datos de entrenamiento desde Excel. Usamos la función sigmoide logística para activación y su derivada para retropropagación. La tasa de aprendizaje, dimensionalidad de entrada, tamaño de capa oculta y cuenta de épocas se establecen aquí. Pesos iniciales aleatorios se generan con np.random.uniform(-1, 1), y una semilla fija asegura reproducibilidad. Arrays vacíos para valores de pre-activación y post-activación ocultos también se inicializan.
Importando Datos de Entrenamiento
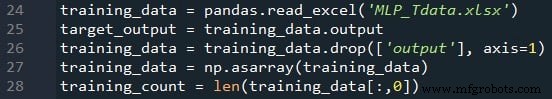
Siguiendo el procedimiento de la Parte 4, leemos el dataset desde Excel, separamos la columna objetivo, la removemos de la matriz de características, convertimos los datos restantes a array NumPy y almacenamos la cuenta de muestras en training_count.
Procesamiento Feedforward
La fase feedforward computa la salida de la red propagando entradas a través de la capa oculta al nodo de salida. El código abajo demuestra el bucle multi-época, cálculos por muestra, pre-activación y activación de capa oculta, y cómputo final de salida.
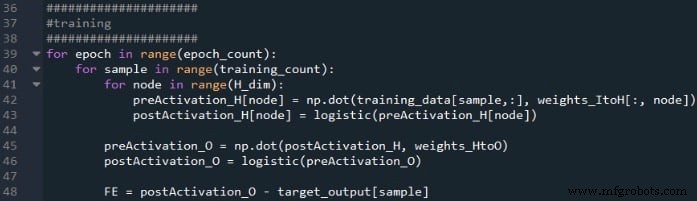
Dentro de cada época, iteramos sobre todas las muestras. Para cada muestra, computamos las activaciones de nodos ocultos vía productos punto, aplicamos la sigmoide, luego computamos la pre-activación y post-activación del nodo de salida. El error es la diferencia entre el objetivo y la salida.
Retropropagación
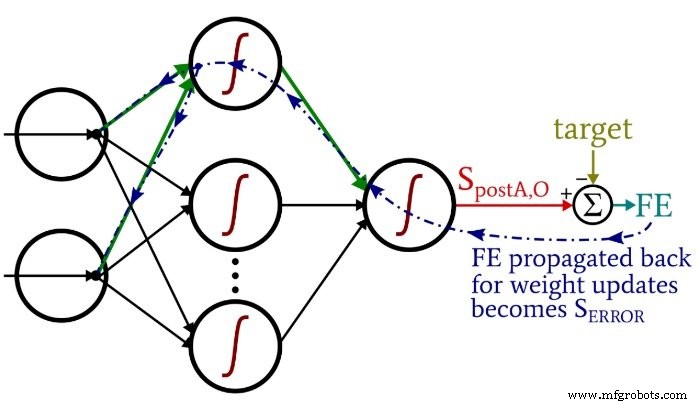
Después del feedforward, la retropropagación ajusta pesos en orden inverso, propagando señales de error desde la salida de vuelta a través de la capa oculta. La siguiente imagen ilustra los bucles anidados y actualizaciones de pesos.
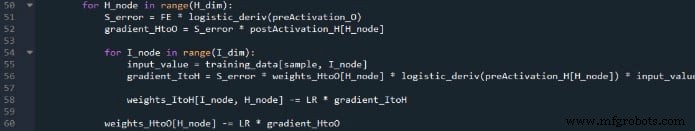
Primero computamos el término de error de salida S_ERROR, luego actualizamos los pesos oculto-a-salida. Subsecuentemente, para cada nodo oculto, calculamos su contribución a las actualizaciones de pesos entrada-a-oculto usando el peso actual oculto-a-salida. Este orden preserva los cálculos de gradiente correctos.
Conclusión
Este script conciso encapsula los principios centrales de un MLP: ingesta de datos, propagación hacia adelante, cómputo de error y ajuste de pesos vía retropropagación. Espero que sirva como puente claro entre teoría de redes neuronales e implementación práctica.
Abajo está el código completo para referencia:
Descargar Código
Robot industrial
- Creación de experiencias de usuario sin fricción: una guía de diseño UX
- Mínimos Locales en Entrenamiento de Redes Neuronales: ¿Mito o Realidad?
- Agregando Nodos de Sesgo a un Perceptrón Multicapa en Python
- Construya su primera plantilla AWS CloudFormation – Guía práctica
- Construyendo un Cloud Center of Excellence: estrategias para migración exitosa y customer success
- Creación de listas de cadenas en VHDL: Buenas prácticas y ejemplo
- Cómo construir un testbench de auto-comprobación en VHDL: Guía práctica
- Construya un temporizador fiable en VHDL: Contar ciclos de reloj hasta horas
- Construcción de un proceso activado por reloj en VHDL: Guía práctica
- Programación de Redes en Python: Sockets y Protocolos Avanzados
- Crear un array de objetos en Java: Guía paso a paso