



Entrenando un Perceptrón Neuronal Básico con Python: Guía Paso a Paso
Entrenando un Perceptrón Neuronal Básico con Python
Esta guía lo guía a través de una implementación Python completamente comentada que aprende automáticamente los pesos para un perceptrón de capa simple. El código está listo para copiar-pegar, ejecutar y adaptar a sus propios datos.
Explore la Serie Perceptrón de AAC
Para contexto más profundo o para saltar a temas avanzados, consulte el resto de nuestros artículos:
- Cómo Realizar Clasificación Usando una Red Neuronal: ¿Qué es el Perceptrón?
- Cómo Usar un Ejemplo Simple de Red Neuronal Perceptrón para Clasificar Datos
- Cómo Entrenar un Perceptrón Neuronal Básico
- Entendiendo el Entrenamiento Simple de Redes Neuronales
- Introducción a la Teoría de Entrenamiento para Redes Neuronales
- Entendiendo la Tasa de Aprendizaje en Redes Neuronales
- Aprendizaje Automático Avanzado con el Perceptrón Multicapa
- La Función de Activación Sigmoide: Activación en Redes Neuronales Perceptrón Multicapa
- Cómo Entrenar un Perceptrón Multicapa Neuronal
- Entendiendo Fórmulas de Entrenamiento y Retropropagación para Perceptrones Multicapa
- Arquitectura de Red Neuronal para una Implementación en Python
- Cómo Crear una Red Neuronal Perceptrón Multicapa en Python
- Procesamiento de Señales Usando Redes Neuronales: Validación en Diseño de Redes Neuronales
- Conjuntos de Datos de Entrenamiento para Redes Neuronales: Cómo Entrenar y Validar una Red Neuronal Python
Clasificación con un Perceptrón de Capa Simple
Comenzamos con un problema clásico de clasificación binaria en espacio 3-D. La arquitectura de la red es una sola capa oculta con tres nodos de entrada y un nodo de salida que usa una función de activación escalón unitario.
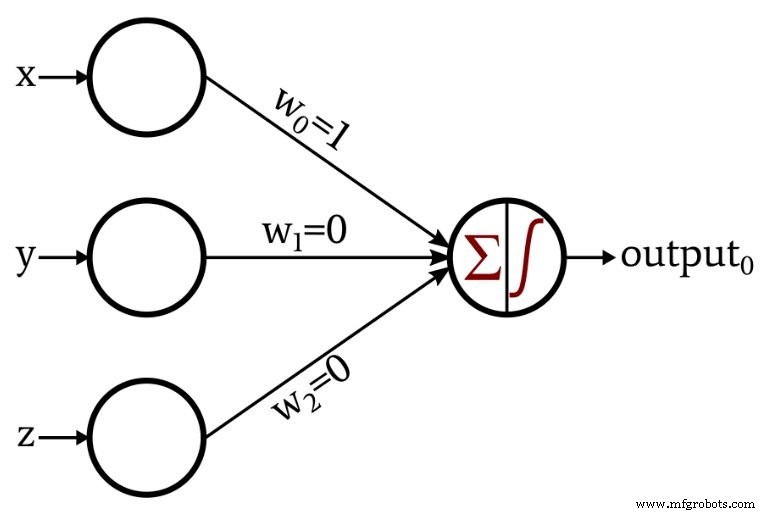
El nodo de salida aplica la siguiente función escalón unitario:
\[f(x)=\begin{cases}0 & x < 0\\1 & x \ge 0\end{cases}\]
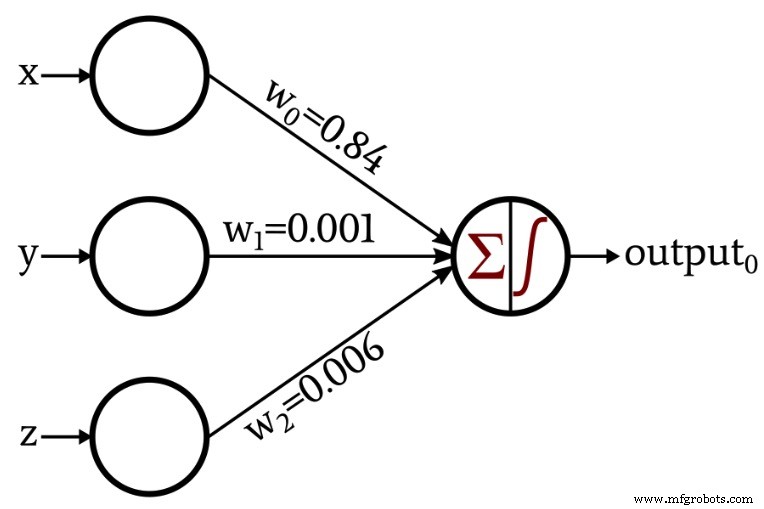
Para ilustrar el aprendizaje, extendemos la arquitectura para ajustar automáticamente sus pesos vía un bucle de entrenamiento simple:
Una Implementación en Python
El siguiente script lee datos de entrenamiento desde un archivo Excel, inicializa pesos aleatoriamente y los actualiza iterativamente usando la regla de aprendizaje del perceptrón.
 import pandas
import numpy as np
# Dimensionalidad del espacio de entrada (x, y, z)
input_dim = 3
# Tasa de aprendizaje controla magnitud de ajuste de pesos
learning_rate = 0.01
# Pesos iniciales aleatorios; puede establecer valores fijos para reproducibilidad
Weights = np.random.rand(input_dim)
# Weights = np.array([0.5, 0.5, 0.5])
# Cargar dataset: hoja con columnas para cada característica y una columna 'output'
Training_Data = pandas.read_excel("3D_data.xlsx")
# Separar salidas esperadas de la matriz de características
Expected_Output = Training_Data.output
Training_Data = Training_Data.drop(["output"], axis=1)
# Convertir a array NumPy para operaciones vectorizadas
Training_Data = np.asarray(Training_Data)
training_count = len(Training_Data[:, 0])
# Entrenar sobre múltiples épocas
for epoch in range(5):
    for datum in range(training_count):
        # Suma ponderada de entradas
        Output_Sum = np.sum(np.multiply(Training_Data[datum, :], Weights))
        # Aplicar activación escalón unitario
        Output_Value = 0 if Output_Sum < 0 else 1
        # Calcular error entre esperado y actual
        error = Expected_Output[datum] - Output_Value
        # Actualizar cada peso según la regla de aprendizaje
        for n in range(input_dim):
            Weights[n] += learning_rate * error * Training_Data[datum, n]
print(f"w_0 = {Weights[0]:.3f}")
print(f"w_1 = {Weights[1]:.3f}")
print(f"w_2 = {Weights[2]:.3f}")
Conceptos Clave Explicados
Configurando la Red y Organizando Datos
La red tiene tres nodos de entrada para igualar las coordenadas 3-D. La tasa de aprendizaje de 0.01 es un punto de partida estándar; puede ajustarla tras experimentación. Los pesos se inicializan aleatoriamente para evitar simetría, pero puede fijarlos a un valor si quiere comportamiento determinista.
Los datos de entrenamiento se leen desde un archivo Excel, se separan en entradas y salidas esperadas, y luego se convierten a array NumPy para cómputo eficiente.
Calculando Valores de Salida
Cada época itera sobre todas las muestras de entrenamiento. Para cada muestra, se computa la suma ponderada de las entradas. La función escalón unitario entonces mapea esta suma a una salida binaria: 0 si la suma es negativa, 1 en caso contrario.
Actualizando Pesos
Cuando la salida predicha difiere de la esperada, la regla de aprendizaje del perceptrón ajusta cada peso proporcionalmente al valor de entrada, el error y la tasa de aprendizaje:
\[w_{new} = w + (\alpha \times \delta \times input)\]
donde \(\delta = \text{output}_{expected} - \text{output}_{calculated}\) y \(\alpha\) es la tasa de aprendizaje.
Conclusión
Ha visto ahora una implementación completa, anotada, de un perceptrón de capa simple en Python. El código es una base sólida para experimentar con diferentes datasets, tasas de aprendizaje, o incluso extender la red a múltiples salidas en proyectos futuros.
Incrustado
- Raspberry Pi y HDC2010: Guía completa de configuración I2C para sensor de temperatura y humedad
- Descubra su clave de seguridad de red: pasos fáciles para encontrar y proteger su Wi‑Fi
- 5 Estrategias Esenciales de Seguridad de Red para Pequeñas Empresas
- Evaluando la Seguridad de la Red de Planta: ¿Está Preparado?
- Preparar la fuerza laboral del mañana para la Industria 4.0: estrategias de formación para la fábrica digital
- Mínimos Locales en Entrenamiento de Redes Neuronales: ¿Mito o Realidad?
- Cómo convertirse en electricista automotriz: formación, funciones y perspectivas laborales
- Construya un modelo de IA sin conexión que detecte etapas de retinopatía diabética con Edge Impulse
- CEVA presenta NeuPro‑S: Procesador IA next‑gen para inferencia deep neural network en el edge
- Sistemas de Detección de Intrusión: Protegiendo tu Red con Alertas Inteligentes
- Endureciendo Dispositivos IoT Industriales para Prevenir Ciberataques