



Mejore la Fiabilidad y Disponibilidad de Activos con FMEA y Curvas P-F
Para organizaciones que sufren fallos inesperados y tiempo de inactividad no planificado, el Análisis de Modos de Fallo y Efectos (AMFE) puede ayudar a lograr alta fiabilidad y disponibilidad de activos.
Logra la fiabilidad y disponibilidad correctas, y estás a un largo camino hacia la rentabilidad.
Pero aquí hay una sorpresa.
Muchas organizaciones y fabricantes nunca hacen este viaje y continúan felizmente (si el producto usable llega al cliente a tiempo) en una espiral descendente.
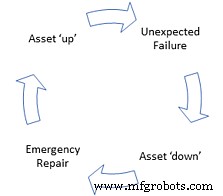
"¡Pero ese viaje del que hablas es MCC!" gritan. "¡Demasiado caro para nosotros!"
Los mismos fabricantes siempre parecen tener tiempo (y dinero) para desechar producto desperdiciado, comprar nuevos rodamientos, limpiar derrames de aceite, arreglar máquinas, llamar a OEM (Fabricante de Equipo Original), y mantener a la gente trabajando horas extra. Y una vez al año —con mucho fanfarria y ceremonia— entregan un premio a los "héroes" del mantenimiento reactivo.
Hmmm.
Está pensando: "¿La gente sale en el boletín de la empresa, un apretón de manos del VP por mantener la planta en mantenimiento reactivo?".
Sí, lo hacen. Pero vayamos más allá.
Llegar a una buena fiabilidad de activos y alta disponibilidad no necesita un estudio completo de MCC. Pero sí requiere un buen AMFE (Análisis de Modos de Fallo y Efectos) con buenos resultados, y la aplicación de curvas P-F (Falla Potencial a Falla Funcional) para asegurar que las técnicas de monitoreo de condición se centren en los modos de fallo correctos a la frecuencia de inspección adecuada.
Análisis de Modos de Fallo y Efectos: llegando al fondo (o la cima) de las cosas
Un AMFE es una herramienta de análisis común que ayuda a diseñadores, técnicos e ingenieros a entender cómo un activo o componente crítico puede fallar, el efecto que tiene en el sistema general, y qué pueden hacer para mitigar los efectos.
La esencia de un AMFE es entender los modos de fallo, qué tan probables son de ocurrir, y mitigarlos con acciones de mantenimiento específicas, rediseños, o incluso "no hacer nada" (si el riesgo es lo suficientemente bajo).
Los AMFE vienen en dos tipos básicos.
De abajo hacia arriba — este AMFE comienza listando cada componente en un asset y listando todas las formas posibles en que puede fallar. A menudo se conoce como el "enfoque de hardware". Este tipo de AMFE es más laborioso pero a menudo se usa en sectores de alta seguridad y consecuencias ambientales como aviación y nuclear.
Los fallos inesperados de activos no pueden tolerarse en estos sectores.
De arriba hacia abajo — este tipo de AMFE (también conocido como "enfoque funcional") es más común y —sí, lo adivinó— considera primero las funciones del activo. Cuando se conocen las funciones, preguntamos "¿cómo puede fallar funcionalmente?" Esto nos lleva a los modos de fallo y la búsqueda de efectos y acciones mitigadoras.
Un AMFE de arriba hacia abajo aborda directamente solo los contribuyentes más importantes a problemas potenciales en lugar de cada componente individual.
También existen AMFEC (C por criticidad) que añaden un factor de riesgo numérico.
Eche un vistazo a este ejemplo que abarca un AMFE y un AMFEC.
Lo mantendremos simple y consideraremos los limpiaparabrisas de un auto. Asumimos que no hacemos comprobaciones inicialmente y simplemente los dejamos fallar mientras conducimos.
Función |
Falla Funcional |
Modo de Falla |
Impacto Potencial |
Severidad |
Causas Potenciales |
Ocurrencia |
Modo de Detección |
Detección |
RPN |
¿Cuál es la función del activo o componente? |
¿Cómo falla al cumplir su función? |
¿Qué puede causar una falla funcional? |
¿Cuál es el impacto? es decir, los efectos |
¿Qué tan severo es el efecto? |
¿Qué causa el modo de falla? |
¿Con qué frecuencia es probable que ocurra? |
¿Cuáles son los controles existentes para prevención o detección? |
¿Qué tan fácil es detectar con métodos actuales? |
Número de prioridad de riesgo = Sev x Occ x Det. |
Limpiar lluvia y niebla del parabrisas frontal (bajo demanda). |
No arranca. |
Fusible fundido. |
El auto no puede limpiar el parabrisas en lluvia fuerte. |
10 |
Escombros bloqueando los limpiaparabrisas (causa sobrecorriente y fusible fundido) |
2 |
Encontrar al fallar (mientras conduce) |
7 |
140 |
Acciones Recomendadas |
Responsabilidad |
Fecha Objetivo |
Acción Tomada |
SEV |
OCC |
DET |
RPN |
¿Cómo reducimos la ocurrencia de la causa o mejoramos la detección? |
¿Quién es responsable de la acción? |
¿Cuál es la fecha objetivo para la acción? |
Recalcule el RPN para ver si la acción redujo el riesgo. |
|
|
|
Nuevo RPN después de acciones. |
1. Inspeccionar los limpiaparabrisas para obstrucciones antes de cada viaje. 2. Llevar fusible de repuesto. |
Propietario del auto |
Con efecto inmediato |
Lista de verificación llevada en el auto como recordatorio. Y fusibles de repuesto. |
10 |
2 |
2 |
40 |
Como puede ver, después de implementar acciones, su Número de Prioridad de Riesgo debería reducirse.
Una vez que realiza un AMFE o AMFEC en su planta, entonces tiene una estrategia de mantenimiento.
Estrategia de mantenimiento: le ayuda a mantener la fiabilidad inherente.
Así que la salida clave de un AMFE es una estrategia de mantenimiento, principalmente en términos de qué necesita hacer. Esto puede ser reemplazos basados en tiempo, monitoreo de condición, rediseños de equipos, tareas de búsqueda de fallos, inspecciones, o revisiones mayores, entre otros.
Para refinar aún más —e implementar luego— su estrategia de mantenimiento, necesitará decidir quién va a hacer el trabajo, cuándo, y qué repuestos se requerirán.
Aquí está la clave para recordar:
Haciendo el mantenimiento correcto en el momento correcto, puede mantener la fiabilidad inherente del activo en un nivel alto. El mantenimiento correcto y adecuado por sí solo nunca puede mejorar la fiabilidad inherente más allá de su capacidad inicial —porque es una característica innata.
Pero una buena estrategia de mantenimiento puede mantener la fiabilidad inherente alta donde pertenece.
Monitoreo de Condición y Mantenimiento Basado en Condición: la disponibilidad es el Rey.
Concentrémonos en las tácticas de monitoreo de condición (también conocido como Mantenimiento Predictivo) por un momento. Esto vale la pena porque sus sensores, datos e información nos permiten entender la salud del activo. Son la fuerza impulsora detrás del internet industrial de las cosas (IIoT) e industria 4.0.
Si entendemos la salud del activo en cualquier momento, entonces podemos realizar esa forma más rentable de todo mantenimiento: mantenimiento basado en condición (CBM).
Aquí está la clave para recordar:
El Mantenimiento Basado en Condición no mejora y no mejorará la fiabilidad del activo, inherente o no. Lo que le dará y que es igual de importante para sus objetivos organizacionales es la disponibilidad del activo. Al reducir solo el tiempo de inactividad no planificado, aumenta la disponibilidad.
El CBM está realizando una tarea de reparación o reemplazo basada únicamente en la salud medida de un activo. Nos da una señal de advertencia temprana de falla potencial o inminente de un activo o componente.
Pero si usamos técnicas de monitoreo de condición, ¿con qué frecuencia deberíamos medir datos?
Curva P-F e Intervalos
Primero, ¿qué es esta curva P-F de la que hablamos? Es una curva que indica cómo se deteriora la salud de un activo con el tiempo una vez que un modo de fallo se pone en marcha.
El diagrama aquí ilustra el concepto.
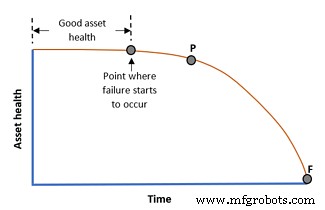
La porción horizontal de la curva es buena salud del activo. Esta porción puede alargarse con mejores prácticas de mantenimiento en:
- Instalación del activo
- Cimientos y estructuras de soporte
- Lubricación del activo
- Alineación y balanceo del activo
- Operación adecuada dentro de la capacidad del activo
Pero luego, cuando un modo de fallo se presenta, tenemos un punto donde ha comenzado el fallo. Pero sigue siendo invisible durante la recopilación de datos.
Luego, el tiempo (o ciclos de estrés del activo) avanza al punto P.
El punto P significa Falla Potencial. Aquí es donde nuestras técnicas de monitoreo de condición pueden empezar a detectar una falla potencial. Luego, la salud del activo se degradará gradual (o rápidamente) hasta llegar al punto F, la Falla Funcional.
Eso significa buenas noches y adiós para su activo.
El juego ha terminado y necesita llamar a los "héroes" del mantenimiento reactivo.
La diferencia de tiempo entre P y F se conoce como el intervalo P-F. Puede ser de segundos a décadas. Todo depende del modo de fallo y del activo en cuestión.
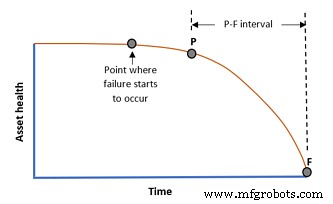
Le irá bien recordar que el intervalo P-F para un modo de fallo específico es siempre un número promedio —estas cosas siempre tendrán variación estadística.
Pero si tenemos una buena idea de cuál es —de fallos pasados, RCAs (Análisis de Causa Raíz), datos OEM, etc.— entonces podemos establecer el intervalo en el que realizamos inspecciones de monitoreo de condición. Una buena regla general para un intervalo de inspección es usualmente al menos la mitad del intervalo P-F esperado.
Imagine que sabe que cuando el rodamiento del extremo de accionamiento de su bomba crítica vibra a 8 mm/s probablemente le queden solo 3 meses de vida útil antes de que se gripe. Como mínimo, ¿con qué frecuencia debería medir la vibración?
Intervalo de inspección/medición 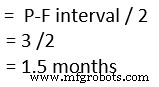
Esto asegura que capturará ese defecto particular dentro del intervalo P-F esperado (aunque la mayoría de estrategas aquí recomendarían conservadora y genéricamente intervalos de inspección de 1 mes — ¿recuerda la variación estadística?).
Es ampliamente aceptado que diferentes técnicas de monitoreo de condición pueden proporcionar niveles diferentes de advertencia temprana durante el intervalo P-F. Eche un vistazo al diagrama de abajo para una guía aproximada. Ninguna técnica es una solución universal para todos los modos de fallo.
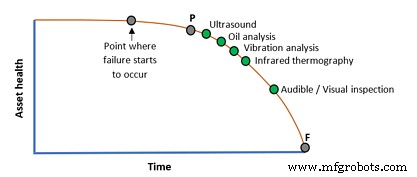
Las mejores estrategias utilizan una combinación de tecnologías de monitoreo de condición.
El viaje hacia el mantenimiento prescriptivo
Como nota final, considerando el progreso del IIoT e industria 4.0, deberíamos considerar el viaje hacia el mantenimiento prescriptivo.
El mantenimiento prescriptivo (Rx) es único en que, en lugar de solo predecir fallas inminentes como lo hace el mantenimiento predictivo (PdM), se esfuerza por producir recomendaciones enfocadas en resultados para operaciones y mantenimiento desde la analítica Rx. Aunque el RxM aún está en su infancia, muchos líderes de opinión están considerando su potencial para convertirse en el próximo nivel de mejores prácticas de fiabilidad y mantenimiento.
|
"¿Pero qué es eso?" oímos preguntar.
Así que la próxima frontera más allá del mantenimiento predictivo será el mantenimiento prescriptivo.
¿Puede imaginar eso?
Sensores, redes, algoritmos, aprendizaje automático e IA combinándose para informar a su equipo de mantenimiento qué necesitan hacer y cuándo necesitan hacerlo para mantener la fiabilidad y aumentar la disponibilidad. O incluso cómo gestionar el activo (velocidades y cargas) para extender la vida útil restante una vez que se detecta una falla potencial.
Las estrategias de mantenimiento del futuro serán fluidas, cambiantes e inteligentemente informadas por tecnología y AMFE construidos por humanos, intervalos P-F, y guías de solución de problemas OEM.
Aún no estamos allí, pero viene...
Lea a continuación: Guía completa sobre IIoT en Mantenimiento
Tecnología de Internet de las cosas
- Invertir en mantenimiento: Una estrategia de ROI probada para fiabilidad y crecimiento de capacidad
- Cómo la señalización y etiquetado impulsan la fiabilidad: Estrategias prácticas para mantenimiento y seguridad
- Domine el envío internacional: Guía práctica para minoristas y fabricantes
- Identificando causas clave de fallo de máquina y estrategias para evitar tiempo de inactividad
- Dominar la disponibilidad de máquinas: Cálculo y estrategias de mejora
- Guía para principiantes: Programación de robots Yaskawa Motoman: Aumente velocidad y precisión
- Impulsa Fiabilidad y Reduce Downtime: Machine Learning Transforma Mantenimiento
- Cómo IoT empodera a niños con TEA para aprender, jugar y prosperar
- Dando Vida a IoT con IBM y Tech Data – Parte 2
- Convirtiendo IoT en Realidad: Insights de Tech Data e IBM – Parte 1
- Obtener la Fecha y Hora Actual en Python: Guía Práctica