



Cómo el procesamiento de señal avanzado permite interacción fluida con asistentes de voz
Altavoces inteligentes y dispositivos controlados por voz están expandiendo rápidamente su alcance, con asistentes como Alexa de Amazon y Google Assistant mejorando en descifrar nuestros comandos hablados con cada actualización.
Uno de los mayores atractivos de esta interfaz es su naturaleza sin esfuerzo —sin curva de aprendizaje, solo conversación natural. Detrás de esa experiencia fluida yace una cadena sofisticada de pasos de procesamiento de señal que transforman audio crudo en una petición clara y accionable.
En este artículo examinamos la arquitectura que potencia soluciones controladas por voz, revelando las capas ocultas de hardware y software que les dan vida.
Flujo de señal y arquitectura
Aunque los detalles varían entre productos, el flujo fundamental es consistente. Usando un altavoz inteligente como Amazon Echo como ejemplo, los subsistemas clave se ilustran en la Figura 1.
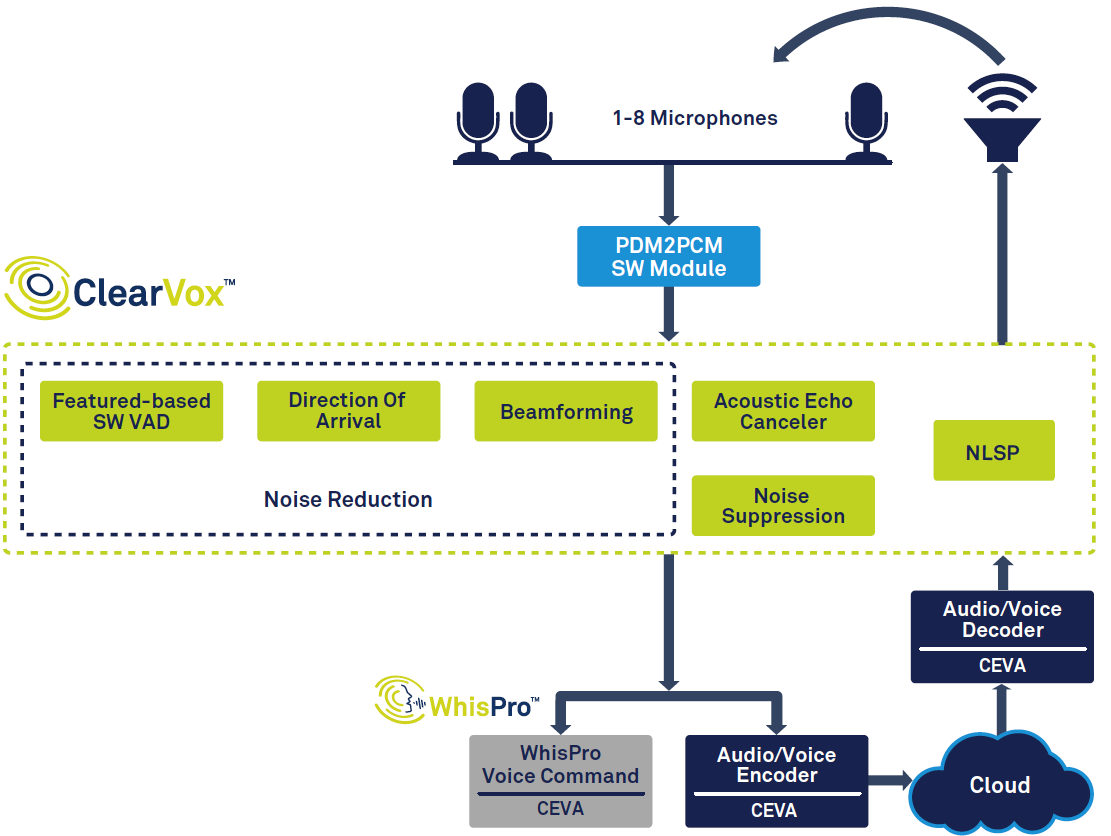
La cadena comienza con detección de actividad de voz (VAD), que aísla segmentos hablados. El audio capturado se digitaliza y somete a una serie de algoritmos front-end que mejoran claridad enfocando en la dirección de llegada del usuario. La señal procesada se envía luego a procesamiento de voz back-end, que puede correr parcialmente en el dispositivo (edge) y parcialmente en la nube. Finalmente, una respuesta —texto o voz— se sintetiza, decodifica y renderiza a través del camino digital-a-analógico del altavoz.
Diferentes casos de uso introducen variaciones. Por ejemplo, interfaces de voz en vehículo deben lidiar con ruido de carretera, mientras wearables emergentes demandan ultra-bajo consumo y coste mínimo.
Procesamiento de señal front-end
Tras VAD y digitalización, el dispositivo debe suprimir sonidos no deseados. La cancelación de eco acústico (AEC) elimina reflexiones causadas por la propia reproducción del dispositivo, permitiendo «barge-in» fluido incluso mientras suena música. La supresión de ruido luego limpia el ruido de fondo residual.
Dispositivos controlados por voz caen en dos categorías: near-field (headsets, auriculares) y far-field (altavoces inteligentes, TVs). Unidades near-field típicamente usan uno o dos micrófonos, mientras unidades far-field despliegan tres a ocho mics. Estas últimas enfrentan un entorno acústico más duro —las voces se desvanecen con la distancia, el ruido de fondo se mantiene constante y la reverberación complica la extracción de señal.
Unidades far-field emplean beamforming, una técnica que calcula la dirección de la fuente desde diferencias de tiempo entre micrófonos. Esto permite al sistema enfocarse en el usuario, ignorar reflexiones, rastrear movimiento y aislar un solo hablante cuando hay múltiples voces presentes.
La detección de palabra de activación (ej. «Alexa») es una característica crítica. La escucha continua plantea preocupaciones de privacidad; por tanto, muchos sistemas realizan reconocimiento de wake-word localmente, enviando audio a la nube solo tras detectar un comando completo.
La muestra de voz limpiada se codifica antes de transmisión al backend cloud para análisis más profundo.
Soluciones especializadas
El procesamiento front-end debe ser rápido, preciso y eficiente en energía —especialmente para wearables a batería. DSPs de propósito general o CPUs luchan para cumplir estas demandas en términos de coste, tamaño y consumo energético. La solución es un DSP específico de aplicación diseñado para tareas de audio.
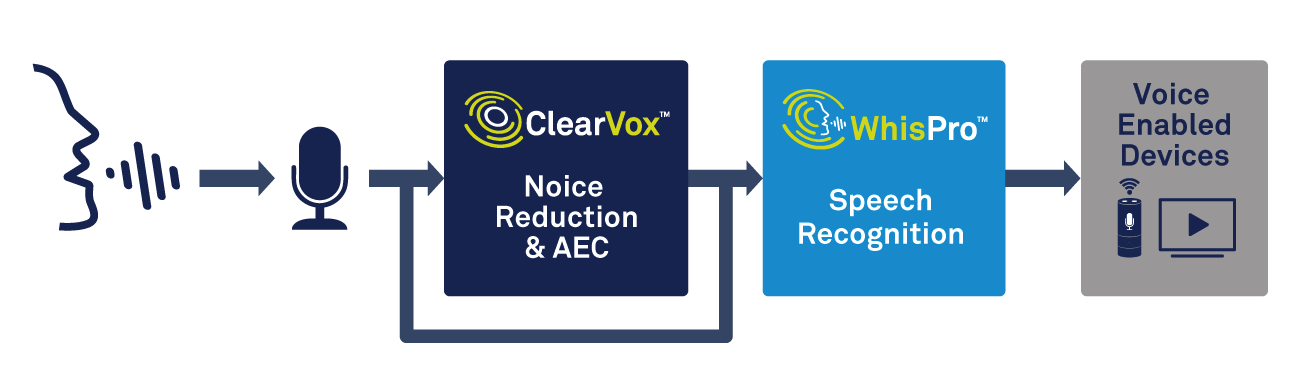
ClearVox de CEVA es una suite de software que maneja beamforming multi-mic, estimación de dirección de llegada, supresión de ruido y AEC a través de diversos escenarios acústicos. Optimizado para DSPs de sonido CEVA, ClearVox entrega un camino de bajo coste y bajo consumo a captura de voz de alta calidad.
La detección de palabra de activación es manejada por WhisPro de CEVA, un reconocedor basado en red neuronal exclusivo para DSPs CEVA. WhisPro mantiene el procesador principal dormido hasta que se detecta una wake-word, reduciendo drásticamente la potencia total del sistema mientras mantiene una tasa de reconocimiento >95%. Soporta múltiples frases de activación y palabras personalizadas, un factor crítico para satisfacción del consumidor.
Reconocimiento de voz: local o cloud
Una vez que el audio está limpio y digitalizado, el siguiente paso es reconocimiento automático de voz (ASR). El espectro va desde simple keyword spotting hasta procesamiento de lenguaje natural (NLP) a gran escala. La detección de palabras clave es ideal para dispositivos de alcance estrecho (ej. un termostato inteligente), permitiendo respuestas offline instantáneas.
Por el contrario, muchas aplicaciones requieren comprensión contextual. Una petición como «Muéstrame un hotel buena relación calidad-precio cerca del centro» debe parsearse para intención, entidades y contexto de seguimiento —un trabajo que típicamente demanda inferencia de red neuronal mucho más allá de la capacidad de chips edge de baja potencia.
El procesamiento cloud ofrece la potencia computacional para entregar NLP sofisticado, a costa de latencia y conexión a Internet. Las soluciones edge están mejorando, sin embargo; los procesadores AI NeuPro de CEVA llevan inferencia de red neuronal on-device al edge, permitiendo respuestas locales más inteligentes y rápidas mientras mantienen fallback a la nube cuando es necesario.
Elegir entre edge y cloud implica trade-offs. El procesamiento local destaca en velocidad y privacidad pero lucha con consultas complejas. El procesamiento cloud escala a NLP complejo pero introduce latencia y dependencia de conectividad.
Conclusiones
Las interfaces de voz se están convirtiendo rápidamente en piedra angular de la tecnología cotidiana. Avances continuos en procesamiento de señal, ASR e IA —acoplados con hardware especializado— están impulsando mayor precisión, menor potencia y costes reducidos.
OEMs que adopten soluciones purpose-built como ClearVox, WhisPro y NeuPro pueden cumplir objetivos estrictos de rendimiento, coste y potencia mientras acortan time-to-market.
A medida que la tecnología de voz madura, podemos esperar interacción aún más natural y horizontes de aplicación más amplios —un viaje emocionante que remodelará cómo nos relacionamos con dispositivos.
Incrustado
- Estrategias Comprobadas para que su Programa Integral de Seguridad Funcione
- Construye una Brújula Digital en Tiempo Real con Arduino y Processing
- Cómo operan los sistemas SCADA: monitorización y control de procesos industriales
- Optimice su Cadena de Suministro para Resiliencia y Eficiencia Hoy
- Construye un Prototipo Ganador: Guía Paso a Paso para Desarrollo Rápido de Productos
- Cómo funcionan las ruedas giratorias: De los diseños iniciales a la innovación omnidireccional
- Cómo Funcionan los Secadores de Aire: Manteniendo el Aire Comprimido Limpio y Eficiente
- Comprender los Frenos Eléctricos: Cómo Funcionan y Por Qué Importan
- Cómo la IA en el edge y los avances en micrófonos aceleran la adopción de asistentes de voz
- Grafeno Impreso por Inyección de Tinta: El Futuro de la Electrónica Impresa en 3D
- La guía completa de producción de fibra de vidrio