



Entendiendo Hadoop: Guía para el Procesamiento de Big Data
La evolución del Big Data ha producido nuevos desafíos que requerían nuevas soluciones. Como nunca antes en la historia, los servidores necesitan procesar, ordenar y almacenar cantidades masivas de datos en tiempo real.
Este desafío ha llevado a la aparición de nuevas plataformas, como Apache Hadoop, que pueden manejar grandes conjuntos de datos con facilidad.
En este artículo aprenderás qué es Hadoop, cuáles son sus componentes principales y cómo Apache Hadoop ayuda en el procesamiento de Big Data.
¿Qué es Hadoop?
La biblioteca de software Apache Hadoop es un marco de trabajo (framework) de código abierto que permite gestionar y procesar Big Data de manera eficiente en un entorno de computación distribuida.
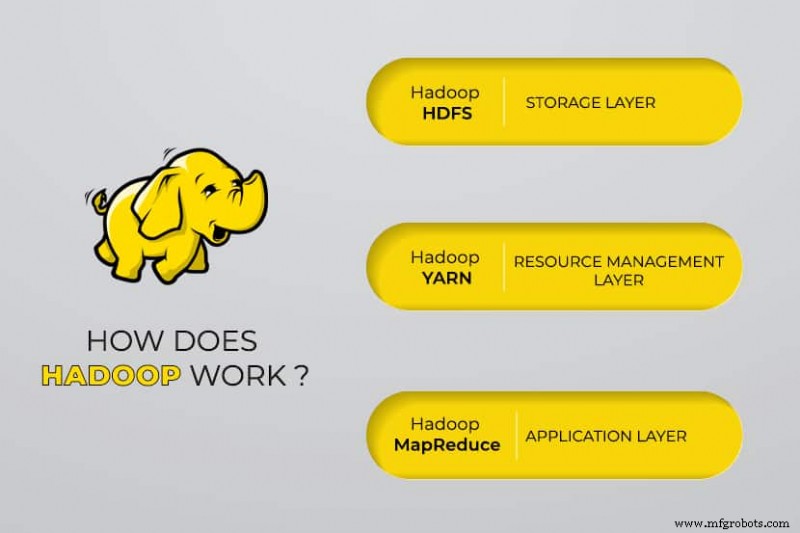
Apache Hadoop consta de cuatro módulos principales:
Sistema de Archivos Distribuido de Hadoop (HDFS)
Los datos residen en el Sistema de Archivos Distribuido de Hadoop, que es similar al de un sistema de archivos local en un ordenador típico. HDFS proporciona un mejor rendimiento de datos (throughput) en comparación con los sistemas de archivos tradicionales.
Además, HDFS ofrece una excelente escalabilidad. Puedes escalar desde una sola máquina a miles con facilidad y en hardware commodity (estándar).
Yet Another Resource Negotiator (YARN)
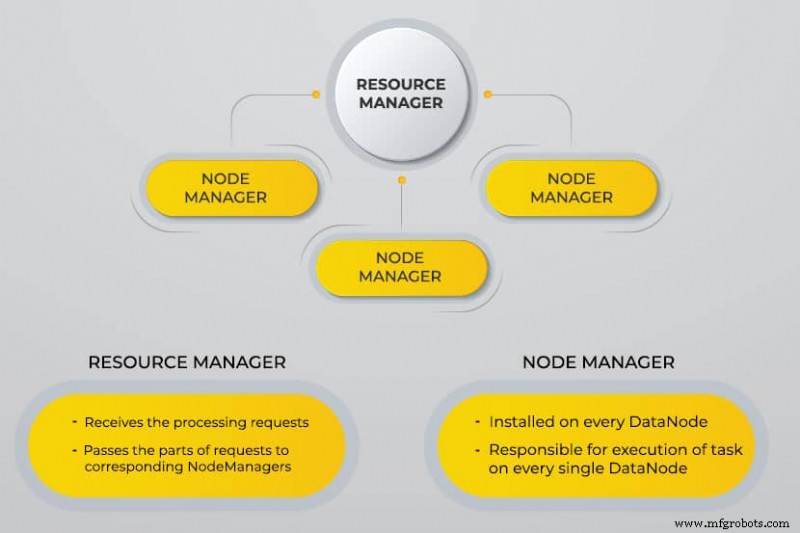
YARN facilita la programación de tareas, gestionando y monitoreando nodos de clúster y otros recursos.
MapReduce
El módulo Hadoop MapReduce ayuda a los programas a realizar computación paralela de datos. La tarea Map de MapReduce convierte los datos de entrada en pares clave-valor. Las tareas Reduce consumen la entrada, la agregan y producen el resultado.
Hadoop Common
Hadoop Common utiliza bibliotecas Java estándar en todos los módulos.
¿Por qué se desarrolló Hadoop?
La World Wide Web creció exponencialmente durante la última década, y ahora consiste en miles de millones de páginas. Buscar información online se volvió difícil debido a su cantidad significativa. Estos datos se convirtieron en Big Data, y consisten en dos problemas principales:
- Dificultad para almacenar todos estos datos de manera eficiente y fácil de recuperar
- Dificultad para procesar los datos almacenados
Los desarrolladores trabajaron en muchos proyectos de código abierto para devolver resultados de búsqueda web más rápido y eficientemente abordando los problemas anteriores. Su solución fue distribuir datos y cálculos a través de un clúster de servidores para lograr procesamiento simultáneo.
Eventualmente, Hadoop llegó a ser una solución a estos problemas y trajo muchos otros beneficios, incluida la reducción de costes de despliegue de servidores.
¿Cómo funciona el procesamiento Big Data con Hadoop?
Usando Hadoop, utilizamos la capacidad de almacenamiento y procesamiento de clústeres e implementamos procesamiento distribuido para Big Data. Esencialmente, Hadoop proporciona una base sobre la que construyes otras aplicaciones para procesar Big Data.
Las aplicaciones que recopilan datos en diferentes formatos los almacenan en el clúster Hadoop a través de la API de Hadoop, que se conecta al NameNode. El NameNode captura la estructura del directorio de archivos y la ubicación de "chunks" (bloques) para cada archivo creado. Hadoop replica estos chunks en DataNodes para procesamiento paralelo.
MapReduce realiza la consulta de datos. Mapea todos los DataNodes y reduce las tareas relacionadas con los datos en HDFS. El nombre "MapReduce" describe lo que hace: las tareas Map se ejecutan en cada nodo para los archivos de entrada suministrados, mientras que los reducers se ejecutan para vincular los datos y organizar la salida final.
Herramientas Big Data del Ecosistema Hadoop
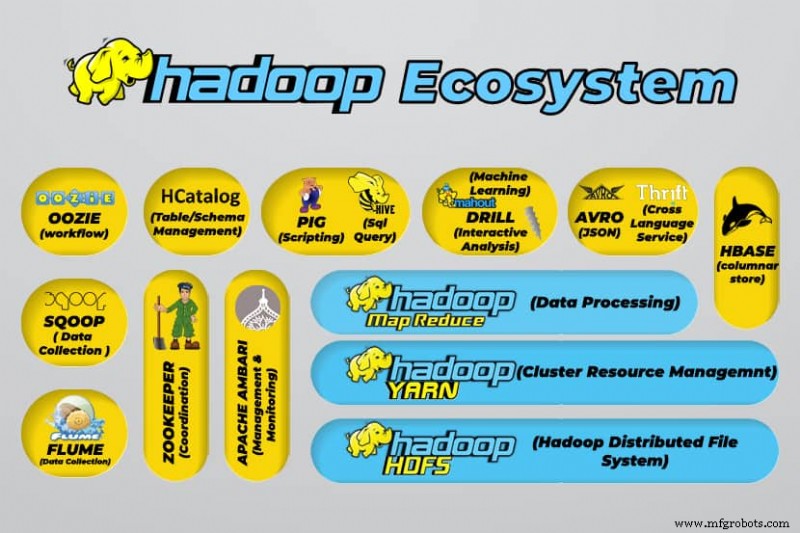
El ecosistema de Hadoop soporta una variedad de herramientas de Big Data de código abierto. Estas herramientas complementan los componentes principales de Hadoop y mejoran su capacidad para procesar Big Data.
Las herramientas más útiles para el procesamiento de Big Data incluyen:
- Apache Hive
Apache Hive es un almacén de datos (data warehouse) para procesar grandes conjuntos de datos almacenados en el sistema de archivos de Hadoop. - Apache Zookeeper
Apache Zookeeper automatiza failovers y reduce el impacto de un NameNode fallido. - Apache HBase
Apache HBase es una base de datos no relacional de código abierto para Hadoop. - Apache Flume
Apache Flume es un servicio distribuido para streaming de grandes cantidades de datos de logs. - Apache Sqoop
Apache Sqoop es una herramienta de línea de comandos para migrar datos entre Hadoop y bases de datos relacionales. - Apache Pig
Apache Pig es la plataforma de desarrollo de Apache para desarrollar jobs que se ejecutan en Hadoop. El lenguaje de software usado es Pig Latin. - Apache Oozie
Apache Oozie es un sistema de planificación que facilita la gestión de jobs de Hadoop. - Apache HCatalog
Apache HCatalog es una herramienta de gestión de almacenamiento y tablas para ordenar datos de diferentes herramientas de procesamiento.
Ventajas de Hadoop
Hadoop es una solución robusta para el procesamiento de Big Data y una herramienta esencial para empresas que manejan grandes volúmenes de datos.
Las principales características y ventajas de Hadoop se detallan a continuación:
- Almacenamiento y procesamiento más rápido de grandes cantidades de datos
La cantidad de datos a almacenar aumentó dramáticamente con la llegada de redes sociales e Internet de las Cosas (IoT). El almacenamiento y procesamiento de estos conjuntos de datos son críticos para las empresas que los poseen. - Flexibilidad
La flexibilidad de Hadoop permite guardar tipos de datos no estructurados como texto, símbolos, imágenes y videos. En bases de datos relacionales tradicionales como RDBMS, necesitas procesar los datos antes de almacenarlos. Sin embargo, con Hadoop, el preprocesamiento no es necesario ya que puedes almacenar los datos tal como son y decidir cómo procesarlos después. En otras palabras, se comporta como una base de datos NoSQL. - Potencia de procesamiento
Hadoop procesa Big Data a través de un modelo de computación distribuida. Su uso eficiente de la potencia de procesamiento lo hace rápido y eficiente. - Coste reducido
Muchos equipos abandonaron sus proyectos antes de la llegada de frameworks como Hadoop, debido a los altos costes que incurrían. Hadoop es un framework de código abierto, es gratuito y usa hardware commodity barato para almacenar datos. - Escalabilidad
Hadoop te permite escalar rápidamente tu sistema sin mucha administración, simplemente cambiando el número de nodos en un clúster. - Tolerancia a fallos
Una de las muchas ventajas de usar un modelo de datos distribuido es su capacidad para tolerar fallos. Hadoop no depende del hardware para mantener la disponibilidad. Si un dispositivo falla, el sistema redirige automáticamente la tarea a otro dispositivo. La tolerancia a fallos es posible porque se mantienen datos redundantes guardando múltiples copias a través del clúster. En otras palabras, la alta disponibilidad se mantiene en la capa de software.
Los Tres Principales Casos de Uso
Procesamiento de Big Data
Recomendamos Hadoop para cantidades masivas de datos, usualmente en el rango de petabytes o más. Es más adecuado para cantidades masivas de datos que requieren enorme potencia de procesamiento. Hadoop puede no ser la mejor opción para una organización que procesa cantidades menores de datos en el rango de varios cientos de gigabytes.
Almacenamiento de un conjunto diverso de datos
Una de las muchas ventajas de usar Hadoop es que es flexible y soporta varios tipos de datos. Independientemente de si los datos consisten en texto, imágenes o video, Hadoop puede almacenarlos eficientemente. Las organizaciones pueden elegir cómo procesar los datos según sus requerimientos. Hadoop tiene características de un data lake ya que proporciona flexibilidad sobre los datos almacenados.
Procesamiento paralelo de datos
El algoritmo MapReduce usado en Hadoop orquesta el procesamiento paralelo de datos almacenados, lo que significa que puedes ejecutar varias tareas simultáneamente. Sin embargo, las operaciones conjuntas no están permitidas ya que confunden la metodología estándar en Hadoop. Incorpora paralelismo mientras los datos sean independientes entre sí.
¿Para qué se usa Hadoop en el mundo real?
Empresas de todo el mundo usan sistemas de procesamiento Big Data con Hadoop. A continuación se enumeran algunos de los muchos usos prácticos de Hadoop:
- Entender los requisitos del cliente
Hoy en día, Hadoop ha demostrado ser muy útil para entender los requisitos del cliente. Las grandes empresas en la industria financiera y redes sociales usan esta tecnología para analizar Big Data sobre su actividad. Las empresas usan esos datos para ofrecer ofertas personalizadas a los clientes. Es posible que hayas experimentado esto a través de anuncios mostrados en redes sociales y sitios de eCommerce basados en nuestros intereses y actividad en internet. - Optimizar procesos empresariales
Hadoop ayuda a optimizar el rendimiento de los negocios analizando mejor sus datos de transacciones y clientes. El análisis de tendencias y predictivo puede ayudar a las empresas a personalizar sus productos y stocks para aumentar ventas. Tal análisis facilitará una mejor toma de decisiones y conducirá a mayores beneficios. Además, las empresas usan Hadoop para mejorar su entorno laboral monitoreando el comportamiento de los empleados recopilando datos sobre sus interacciones. - Mejorar servicios de salud
Las instituciones de la industria médica pueden usar Hadoop para monitorear la gran cantidad de datos sobre problemas de salud y resultados de tratamientos. Los investigadores pueden analizar estos datos para identificar problemas de salud, predecir medicación y decidir planes de tratamiento. Estas mejoras permitirán a los países mejorar sus servicios de salud rápidamente. - Trading financiero
Hadoop posee un algoritmo sofisticado para escanear datos de mercado con configuraciones predefinidas para identificar oportunidades de trading y tendencias estacionales. Las empresas financieras pueden automatizar la mayoría de estas operaciones a través de las robustas capacidades de Hadoop. - Uso de Hadoop para IoT
Los dispositivos IoT dependen de la disponibilidad de datos para funcionar eficientemente. Fabricantes e inventores usan Hadoop como almacén de datos para miles de millones de transacciones. Como IoT es un concepto de streaming de datos, Hadoop es una solución adecuada y práctica para gestionar las vastas cantidades de datos que abarca. Hadoop se actualiza continuamente, permitiéndonos mejorar las instrucciones usadas con plataformas IoT.
Otros usos prácticos de Hadoop incluyen mejorar el rendimiento de dispositivos, mejorar la cuantificación personal y optimización del rendimiento, mejorar la investigación deportiva y científica.
¿Cuáles son los desafíos de usar Hadoop?
Toda aplicación viene con ventajas y desafíos. Hadoop también introduce varios desafíos:
- El algoritmo MapReduce no es siempre la solución
El algoritmo MapReduce no soporta todos los escenarios. Es adecuado para peticiones de información simples y problemas que pueden dividirse en unidades independientes, pero no para tareas iterativas. MapReduce es ineficiente para computación analítica avanzada ya que los algoritmos iterativos requieren intensa intercomunicación y crea múltiples archivos en la fase MapReduce. - Gestión de datos no completamente desarrollada
Hadoop no proporciona herramientas completas para gestión de datos, metadatos y gobernanza de datos. Además, carece de herramientas requeridas para estandarización de datos y determinación de calidad. - Brecha de talento
Debido a la curva de aprendizaje pronunciada de Hadoop, puede ser difícil encontrar programadores junior con habilidades en Java suficientes para ser productivos con MapReduce. Esta intensidad es la razón principal por la que los proveedores están interesados en poner tecnología de bases de datos relacionales (SQL) sobre Hadoop, porque es mucho más fácil encontrar programadores con buen conocimiento de SQL que habilidades en MapReduce. La administración de Hadoop es tanto un arte como una ciencia, requiriendo conocimiento de bajo nivel de sistemas operativos, hardware y configuraciones del kernel de Hadoop. - Seguridad de datos
El protocolo de autenticación Kerberos es un paso significativo hacia la seguridad de entornos Hadoop. La seguridad de datos es crítica para proteger sistemas Big Data de problemas fragmentados de seguridad de datos.
Conclusión
Hadoop es altamente efectivo abordando el procesamiento de Big Data cuando se implementa eficazmente con los pasos requeridos para superar sus desafíos. Es una herramienta versátil para empresas que manejan cantidades extensas de datos.
Una de sus principales ventajas es que puede ejecutarse en cualquier hardware y un clúster Hadoop puede distribuirse entre miles de servidores. Tal flexibilidad es particularmente significativa en entornos de infrastructure-as-code.
Computación en la nube
- RAM DDR5 explicada: características, beneficios y disponibilidad
- Internet Industrial de las Cosas (IIoT): Definición, alcance e impacto industrial
- Big Data vs IA: La sinergia detrás de la transformación digital
- Big Data Impulsa Innovación y Eficiencia en Utilities
- Transformando pequeños datos en grandes insights para fabricación
- Aprovechando Big Data con computación cloud: ventaja estratégica
- Entendiendo la seguridad cloud: por qué su negocio la necesita
- Big Data y Cloud Computing: cómo trabajan juntos
- Aprovechando Big Data y Cloud Computing para impulsar el crecimiento empresarial
- Tendencias Emergentes en Plataformas IoT para 2018: Edge Computing, Blockchain y Más
- Mantenimiento predictivo: Eficiencia y reducción de riesgos con insights basados en datos