



Fog Computing explicado: Conectando nube y edge para datos más rápidos e inteligentes
Antes de explicar el fog computing, necesitamos asegurarnos de tener un entendimiento sólido del cloud computing, un concepto que se ha vuelto un término común en nuestro léxico.
Cloud computing se refiere al acceso a recursos de computación «bajo demanda», potencia de computación y almacenamiento de datos sin necesidad de hardware on-premise ni gestión activa por el usuario. La Figura 1 abajo muestra una representación de arquitectura muy genérica de cómo empresas multi-sitio despliegan una solución industrial en la nube.
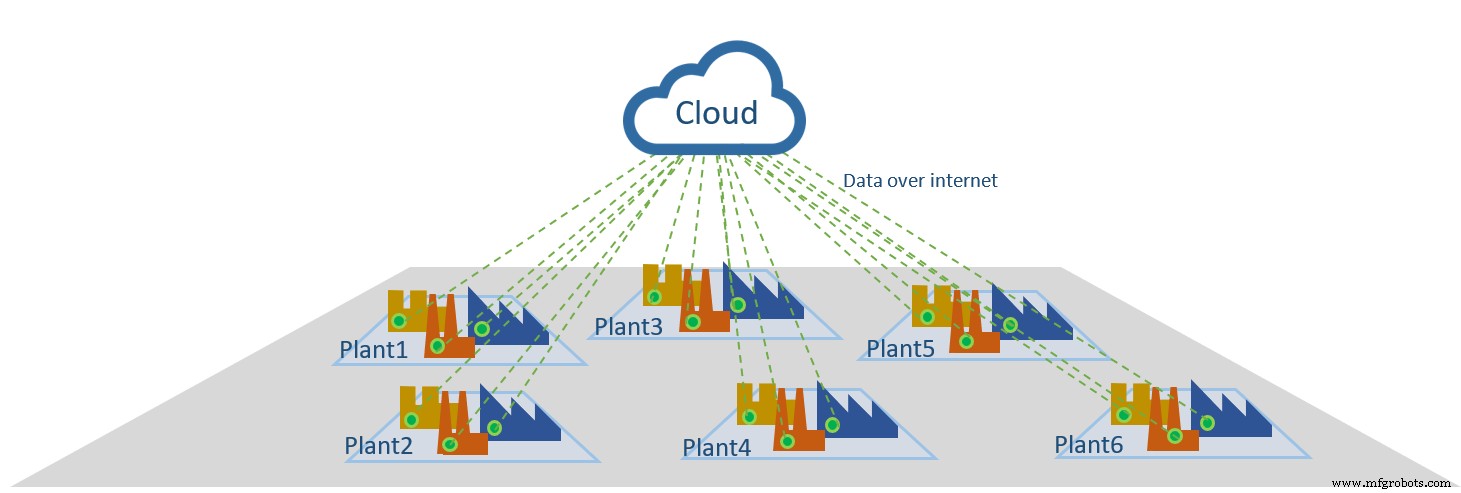 Figura 1: arquitectura de cloud computing. Cortesía del autor.
Dentro de una arquitectura cloud, varios modelos de adopción se han vuelto muy populares —los más notables siendo infraestructura-como-servicio (IaaS), plataforma-como-servicio (PaaS) y software-como-servicio (SaaS). La forma en que quieras aprovechar la nube para tu organización te guiará sobre qué modelo será el mejor ajuste.
IEEE 1934 define el fog computing como «una arquitectura horizontal a nivel de sistema que distribuye recursos y servicios de computación, almacenamiento, control y redes en cualquier punto a lo largo del continuo nube-a-cosas. Soporta verticales industriales y dominios de aplicación, permite que servicios y aplicaciones se distribuyan más cerca de las fuentes productoras de datos, y se extiende desde las cosas, sobre los bordes de la red, a través de la nube y a través de múltiples capas de protocolo».
En resumen, esto significa que el fog computing se enfoca en desplazar ciertos recursos de cloud computing lejos de la nube y más cerca de los dispositivos individuales. Con fog computing, se coloca un ordenador adicional en cada planta, típicamente a nivel de LAN, para concentrar (o agregar) datos localmente. Regula qué información debe procesarse localmente y cuál puede descargarse a la nube, actuando como mediador entre dispositivos locales y servidores remotos. Esto generalmente ayuda con dos cosas:
- Reducción en el número de conexiones a la nube necesarias
- Procesamiento local más rápido —como se muestra en la Figura 2, el ordenador fog envía datos consolidados y significativos a la nube, donde la información de cada planta se analiza en combinación con otras plantas
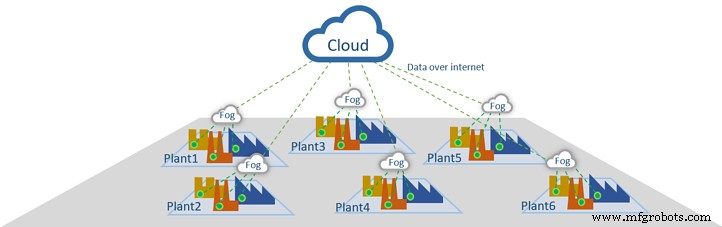 Figura 2: arquitectura de fog computing. Cortesía del autor.
¿Cuáles son las diferencias entre Fog Computing y Edge Computing?
Además del fog computing, puede que hayas oído otro término: edge computing. ¿Son lo mismo? Si no, ¿cuál es la diferencia?
Dependiendo de a quién preguntes, o con qué empresa trabajes, la respuesta puede ser muy diferente. Algunos argumentan que fog y edge computing son lo mismo, mientras que otros argumentan que son bastante diferentes.
El fog y el edge computing, al menos en aplicaciones industriales y de fabricación, son sistemas que intentan recopilar y procesar datos de activos/dispositivos locales más eficientemente que arquitecturas cloud tradicionales. La diferencia clave entre estas ideas reside en dónde ocurre finalmente el procesamiento y la «inteligencia».
Por ejemplo, si un sensor puede almacenar sus valores medidos en bruto una vez por minuto localmente durante 30 días, puede solo transmitir datos de resumen a un recurso de computación (servidor) en la red local una vez por hora, y una fracción de esos datos del sensor podría reenviarse a computadoras en la nube para procesamiento. Esto reduce enormemente la transmisión de datos, y permite recopilar un historial detallado si el sensor captura algo de interés.
Tu definición de edge versus fog depende de dónde trazas el límite alrededor de la recopilación de datos en bruto, el almacenamiento de datos y el uso de recursos computacionales.
Beneficios del Fog Computing
Considera el ejemplo anterior. ¿Te has imaginado la cantidad de potencia de computación requerida para agregar, analizar y calcular la salida deseada de 100 sensores? ¿Qué tal 10,000 sensores? El almacenamiento requerido, tráfico de datos y ancho de banda de red crecen exponencialmente cuantas más fuentes de datos se añaden.
El fog computing te ayuda a:
- Reducir latencia de red y tráfico de datos
- Aumentar el ancho de banda efectivo de red
- Aislar verticalmente la red
- Escalar el despliegue fácil y eficientemente
- Controlar privacidad y seguridad de datos
Adaptando tecnologías de fog computing, puedes construir y desplegar soluciones IIoT «inteligentes» y eficientes en pasos más pequeños. Sin embargo, en lugar de pensar en «nube vs. fog vs. edge», deberías reformular tu pensamiento alrededor de la pregunta: «¿Qué combinación es la más adecuada para mis necesidades particulares?» De esta forma, no se ve como una decisión de «uno u otro», sino como una adaptación colaborativa de diferentes tecnologías y arquitecturas.
Tecnología Industrial
- ¿Qué es la Computación Cuántica? Guía para Principiantes
- Diseño de Medidores: De Galvanómetros Clásicos a Pantallas Digitales Modernas
- Comprender Circuitos Filtro: De Audio a Acondicionamiento de Potencia
- Comprender la Impedancia de Traza: Por Qué Importa en el Diseño de PCB
- Entendiendo la Eficiencia de Línea: Métricas Clave para Producción de PCB
- Comprender las leyendas de PCB: propósito, ubicación y beneficios
- Internet Industrial de las Cosas (IIoT): Definición, alcance e impacto industrial
- Entendiendo las Interfaces Hombre-Máquina (HMI) en la industria moderna
- Top cursos cloud computing 2026: desde fundamentos AWS hasta MicroMasters de Maryland
- Computación en la Niebla Explicada: Transformando el Flujo de Datos IoT y Reduciendo la Carga en la Nube
- ¿Qué es el acero A2? Un grado de acero para herramientas versátil y rentable para aplicaciones industriales y de carpintería