



Comprendiendo la Computación Serverless: Simplifique la Gestión de Infraestructura
La gestión de infraestructura añade una capa adicional de complejidad al flujo de trabajo moderno de desarrollo de software. Mantener servidores en funcionamiento, encargarse de actualizaciones de seguridad y escalar recursos consume tiempo valioso de los equipos DevOps. Con la computación serverless (sin servidor), todas las operaciones de infraestructura son manejadas por el proveedor del servicio. Como tal, serverless permite a los equipos de desarrollo centrarse en escribir código en lugar de dedicar demasiado tiempo a la gestión de infraestructura.
Este artículo explica qué es la computación serverless y cómo se compara con diferentes modelos de implementación en la nube. También exploraremos los pros y contras de serverless y hablaremos sobre algunos casos de uso comunes.
¿Qué es la Computación Serverless?
La computación serverless es un método para implementar y ejecutar código en la nube sin lidiar con el aprovisionamiento de servidores y la gestión de infraestructura. A pesar de su nombre, serverless aún depende de servidores en la nube o físicos para la ejecución de código. Sin embargo, los desarrolladores no se preocupan por la infraestructura subyacente. Esto se deja al proveedor serverless que asigna dinámicamente los recursos de cómputo necesarios y los gestiona en nombre del usuario.
Para los desarrolladores, esto significa cero tiempo dedicado a la administración de servidores, mantenimiento, escalado de recursos o planificación de capacidad. Simplemente suben su código y dejan que el proveedor ejecute la lógica del lado del servidor basada en diferentes eventos o solicitudes. En contraste con los modelos de facturación de nube familiares, los servicios serverless se cobran en función del número de veces que se ejecuta el código o cuando se activa un cierto evento.
¿Cómo Funciona la Computación Serverless?
En un entorno serverless, el código se activa por eventos y se ejecuta como una función. Por eso serverless a menudo se asocia con "Functions-as-a-Service" o FaaS, que es un concepto similar. FaaS es un modelo de nube impulsado por eventos que maneja la lógica del lado del servidor para la ejecución de código sin ninguna intervención del usuario. Estos eventos pueden ser cualquier cosa, desde una simple solicitud HTTP, llamada a API, hasta una consulta a base de datos o carga de archivo.
Las funciones se ejecutan en contenedores sin estado (stateless). Esto significa que los recursos de cómputo para ejecutar una función se aprovisionan solo cuando se invoca. No se persisten datos en la RAM ni se escriben en el disco. Una vez que se ha cumplido la solicitud, el estado de la aplicación se reinicia y no hay memoria de la transacción. Hacer una nueva solicitud requiere que los recursos se aprovisionen desde cero y el código se ejecute sin ninguna referencia a la invocación anterior.
Para acomodar este estado sin estado, las aplicaciones necesitan ser arquitecturadas como funciones que puedan ejecutarse en contenedores sin estado. Esto generalmente se logra a través de microservicios. Las grandes aplicaciones monolíticas se dividen en segmentos más pequeños e interconectados a través de una API. Las aplicaciones monolíticas aún pueden ejecutarse como funciones únicas, pero esta no es una práctica común. Teniendo en cuenta que un nuevo contenedor de cómputo se aprovisiona en cada solicitud, las funciones grandes afectarán negativamente la velocidad y duración de la ejecución.
Las funciones FaaS no se ejecutan infinitamente. Se terminan después de un cierto tiempo tras ser llamadas. En la mayoría de los casos, las funciones agotan el tiempo de espera (timeout) después de unos cinco minutos. Esto significa que las aplicaciones que ejecutan tareas de larga duración necesitan ser rediseñadas para tener en cuenta los límites de terminación.
El aprovisionamiento e inicialización de contenedores para la ejecución de funciones también lleva tiempo. Esto generalmente se mide en milisegundos. Sin embargo, las funciones complejas pueden tardar varios segundos en inicializarse, causando mayor latencia.
Hay dos métodos comunes para inicializar una función: inicio en caliente (warm start) e inicio en frío (cold start). Un inicio en caliente reutiliza recursos de un evento anterior, mientras que un inicio en frío implementa un nuevo contenedor. El tiempo que tarda en inicializarse y ejecutarse una función dependerá de la cantidad de código, el lenguaje de programación, el número de bibliotecas que usa el script, así como muchos otros factores. En términos de latencia, un inicio en frío lleva más tiempo para iniciar una función.
¿Cómo se Compara la Computación Serverless con BaaS, PaaS e IaaS?
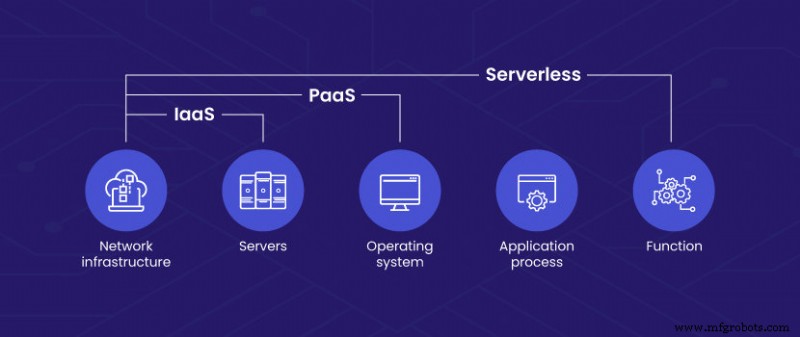
Al igual que con cualquier tendencia de software, no hay una definición oficial que describa qué es serverless y qué no lo es. Por eso la computación serverless a menudo se confunde con otros servicios en la nube y modelos de implementación. El concepto de computación serverless gira en torno a dos áreas similares:
Backend-as-a-Service (BaaS) — BaaS permite a los desarrolladores centrarse en escribir interfaces frontend mientras descargan todas las operaciones de backend a un proveedor de servicios. Estas tareas entre bastidores suelen involucrar autenticación de usuarios lista para usar, almacenamiento, gestión de bases de datos y servicios de alojamiento. Además, los desarrolladores no tienen que gestionar servidores que ejecutan su backend, lo que permite implementaciones de aplicaciones más rápidas.
Functions-as-a-Service (FaaS) — Este modelo de servicio en la nube serverless elimina la gestión de infraestructura. El proveedor de servicios tiene la tarea de implementar recursos de cómputo bajo demanda para ejecutar el código de los usuarios. Esto ocurre cada vez que se activa un evento o solicitud. Las funciones serverless se ejecutan en contenedores sin estado, lo que significa que los recursos de cómputo se implementan solo cuando se invoca la función.
El principal punto de confusión está entre Backend-as-a-Service y Platform-as-a-Service (PaaS). El primero es una técnica de computación serverless, mientras que el segundo es un modelo de implementación en la nube. Aunque comparten algunas características básicas, PaaS no está alineado con los requisitos de serverless.
Platform-as-a-Service (PaaS) — Con PaaS, los usuarios alquilan el hardware y las soluciones de software necesarias para cargas de trabajo de desarrollo a un proveedor de servicios por una tarifa de suscripción. Permite a los desarrolladores dedicar más tiempo a codificar sin preocuparse por la gestión de infraestructura. Por otro lado, BaaS ofrece características adicionales como autenticación de usuarios lista para usar, bases de datos gestionadas, notificaciones por correo electrónico, etc. BaaS también permite a los desarrolladores centrarse únicamente en construir el frontend mientras integran varios servicios de backend bajo demanda.
Infrastructure-as-a-Service (IaaS) — IaaS se refiere a una solución de nube de autoservicio donde el proveedor aloja la infraestructura en nombre del usuario. Todas las operaciones de aprovisionamiento y gestión de servidores, incluida la instalación de software, son manejadas por el usuario. Algunos proveedores de IaaS también ofrecen soluciones serverless pero como productos claramente diferentes.
Casos de Uso Comunes de la Computación Serverless
Como se mencionó anteriormente, serverless no es para todos. Pero si sus necesidades se alinean con algunos de estos casos de uso, podría beneficiarse de serverless.
Construcción de APIs
Sin servidores que gestionar, construir APIs altamente escalables y responsivas es uno de los casos de uso más populares para serverless. La función de autoescalado de serverless garantiza que las APIs estarán siempre disponibles incluso bajo tráfico intenso. Además, el usuario no paga por recursos inactivos cuando no hay llamadas a la API.
Sitios Web y Aplicaciones
Implementar sitios web y aplicaciones basadas en web en una plataforma serverless no requiere ninguna configuración de infraestructura previa. Esto reduce significativamente el tiempo que lleva lanzar una aplicación web totalmente funcional. La función de autoescalado también juega un papel importante aquí porque el usuario no necesita preocuparse por aprovisionar más servidores para soportar aumentos en la demanda. Como resultado, es mucho más fácil mantener un 100% de tiempo de actividad.
Aplicaciones Multi-Idioma
Con serverless, una sola aplicación puede escribirse en varios lenguajes. Serverless permite a los desarrolladores dividir una aplicación monolítica en partes más pequeñas y ejecutarlas como microservicios. Esos microservicios luego se comunican entre sí a través de una API. Cada segmento de una aplicación puede escribirse usando un lenguaje de programación diferente.
Pipelines CI/CD
La automatización es clave para ejecutar pipelines exitosos de desarrollo, pruebas e integración. Serverless permite a los desarrolladores probar código automáticamente y corregir errores más rápido. Dado que serverless se basa en eventos, los usuarios pueden configurar eventos para activar pruebas automatizadas sin ninguna intervención manual.
¿Cuáles son las Ventajas de la Computación Serverless?
Comparada con la computación en la nube tradicional orientada a servidores, la computación serverless abstrae las operaciones de infraestructura. Todo funciona out-of-the-box, lo que a su vez garantiza lanzamientos de código más rápidos y escalabilidad automatizada a un precio más bajo.
Estos son los tres beneficios más comunes de serverless:
Autoescalado (Auto-Scaling)
El proveedor serverless escala los recursos de infraestructura basándose en la demanda. Las operaciones de escalado se realizan de forma dinámica y automática sin ninguna intervención de los desarrolladores.
Tiempo de Llegada al Mercado Más Rápido (Faster Time to Market)
Sin necesidad de aprovisionar clústeres de servidores complejos, los desarrolladores pueden centrarse más en lograr una mayor velocidad de lanzamiento. Esto acelera el tiempo que lleva lanzar código a producción o implementar cambios de código incrementales, resultando en una entrega más rápida de aplicaciones a los clientes.
Costos Optimizados (Optimized Costs)
Dado que todo se aprovisiona bajo demanda, las organizaciones nunca tienen que pagar por espacio de almacenamiento no utilizado, tiempo de cómputo o redes. El consumo de servicios serverless se mide típicamente en milisegundos y se factura en consecuencia.
¿Cuáles son los Inconvenientes de la Computación Serverless?
Al igual que con cualquier solución de software, serverless también viene con algunos aspectos negativos. Pero dependiendo de la aplicación que esté construyendo, es posible que no le preocupen algunos de estos inconvenientes de serverless.
Latencia
Al ejecutar una función, los proveedores serverless implementan automáticamente los recursos necesarios en cada invocación. Dependiendo del tamaño de la carga de trabajo, los contenedores se aprovisionan típicamente en milisegundos, pero pueden tardar varios segundos. La latencia puede reducirse mediante "inicios en caliente" (warm starts) que reutilizan instancias de una ejecución anterior.
Duración de la Ejecución
El tiempo de ejecución de una función serverless es limitado y se aborta después de un cierto período. Esto suele ser alrededor de cinco minutos después de la invocación, pero varía entre proveedores. Los límites de ejecución son un inconveniente importante para aplicaciones que inician procesos de larga duración. Mitigar este problema es posible segmentando el código en trozos más pequeños y ejecutándolos como microservicios.
Vendor Lock-in (Bloqueo de Proveedor)
Los proveedores suelen usar tecnologías propietarias para habilitar sus servicios serverless. Esto puede causar problemas para los usuarios que quieren migrar sus cargas de trabajo a otra plataforma. Al moverse a otro proveedor, los cambios en el código y la arquitectura de la aplicación son inevitables.
Seguridad
Los usuarios tienen poco control sobre la configuración de la instancia que ejecuta su código. Esto está oculto para el usuario y cae en el ámbito del proveedor de servicios. Como tal, las operaciones de seguridad también caen en manos del proveedor. El usuario es impotente si ocurre un ataque, dependiendo únicamente del proveedor para mitigar el daño y recuperar el sistema. Las aplicaciones que tienen múltiples puntos de entrada en un entorno serverless son más propensas a vulnerabilidades debido a una mayor superficie de ataque.
¿Qué Futuro le Espera a la Computación Serverless?
La computación serverless sigue siendo una tecnología relativamente nueva. Su futuro depende de la capacidad de los proveedores de servicios para resolver algunos de los inconvenientes enumerados anteriormente — lo más importante, los inicios en frío (cold starts). Los proveedores necesitan reducir el tiempo que lleva ejecutar una función después de haber estado en estado inactivo por un tiempo. Resolver este problema disminuirá la latencia y garantizará una experiencia de usuario fluida.
Serverless actualmente depende de contenedores sin estado para la ejecución de funciones. El futuro de serverless se dirige hacia permitir que aplicaciones con estado (stateful) aprovechen los beneficios de serverless. Esto permitirá a los desarrolladores construir aplicaciones con estado sin preocuparse por la gestión de datos de backend.
En términos de DevOps, serverless conducirá a la expansión de NoOps. Esta tendencia llevará a que los proveedores serverless manejen todas las operaciones de infraestructura en nombre del cliente. En tal escenario, no hay necesidad de que las empresas tengan equipos de operaciones internos.
En los próximos años, se espera que Kubernetes se convierta en la base de serverless. Con soporte para redes, autoescalado ágil e implementaciones multi-nube, la portabilidad de Kubernetes mejora la computación serverless de más de una manera. Ejecutar ciertas clases de aplicaciones en serverless es impráctico ya que los proveedores de servicios a veces limitan su comportamiento. Con Kubernetes, los desarrolladores podrán superar esas limitaciones y construir plataformas serverless basadas en sus necesidades específicas.
Conclusión
Aunque el nombre sugiere la ausencia de servidores, la computación serverless aún depende de servidores en la nube o físicos. Es un modelo de computación que elimina las operaciones de infraestructura, permitiendo a los desarrolladores centrarse en escribir e implementar aplicaciones. El modelo serverless gira en torno a dos áreas clave: Backend-as-a-Service y Functions-as-a-Service.
El primero proporciona a los usuarios una arquitectura de backend lista para usar, mientras que el segundo permite ejecutar aplicaciones en contenedores sin estado. Estos contenedores se aprovisionan automáticamente basándose en eventos o disparadores. Como tal, serverless no es una solución milagro para todos los problemas de desarrollo actuales. Está mayormente orientado hacia aplicaciones no monolíticas que emplean una arquitectura basada en microservicios.
Computación en la nube
- ¿Qué es la Computación Cuántica? Guía para Principiantes
- Código HS para Bomba Hidráulica: Clasificación y Uso
- ¿Qué es Programar? Guía Práctica de Lenguajes, Flujos de Trabajo y Desafíos Comunes
- Computación sin servidor: la próxima generación de innovación «as a Service»
- Top cursos cloud computing 2026: desde fundamentos AWS hasta MicroMasters de Maryland
- Entendiendo la computación cloud: cómo funciona y por qué importa
- Big Data y Cloud Computing: cómo trabajan juntos
- Principales retos que limitan la adopción Serverless — Lo que necesita saber
- Cloud Computing vs. On-Premise: ¿Qué infraestructura se adapta mejor a tu negocio?
- Edge Computing Explicado: Por Qué Importa para el Negocio Moderno
- ¿Qué es el acero A2? Un grado de acero para herramientas versátil y rentable para aplicaciones industriales y de carpintería