



Red de predicción basada en aprendizaje profundo para diseño de metamateriales con resonadores de anillo dividido
Resumen
La introducción de "metamateriales" ha tenido un impacto profundo en varios campos, incluyendo electromagnetismo. Diseñar la estructura de un metamaterial a demanda, sin embargo, sigue siendo un proceso extremadamente lento. Como método eficiente de aprendizaje automático, el aprendizaje profundo se ha usado ampliamente para clasificación y regresión de datos en años recientes y de hecho ha mostrado buen rendimiento de generalización. Hemos construido una red neuronal profunda para diseño a demanda. Con la reflectancia requerida como entrada, los parámetros de la estructura se calculan automáticamente y luego se emiten para lograr el propósito de diseño a demanda. Nuestra red ha logrado bajos errores cuadráticos medios (MSE), con MSE de 0,005 en ambos conjuntos de entrenamiento y prueba. Los resultados indican que usando aprendizaje profundo para entrenar los datos, el modelo entrenado puede guiar más precisamente el diseño de la estructura, acelerando así el proceso de diseño. Comparado con el proceso de diseño tradicional, usar aprendizaje profundo para guiar el diseño de metamateriales puede lograr propósitos más rápidos, precisos y convenientes.
Introducción
La nano-óptica es una materia interdisciplinaria de nanotecnología y óptica. En años recientes, al diseñar constantemente estructuras con tamaños sub-longitud de onda diferentes para lograr interacciones especiales con luz incidente, científicos han logrado manipular ciertas características de transmisión de luz [1,2,3]. Desde que se propusieron los metamateriales, han atraído la atención de muchos estudiosos en este campo, y concurrentemente su estudio teórico relacionado [4, 5], proceso [6, 7], y investigación aplicada [8] avanzan a la misma velocidad. Muchas funciones peculiares se han realizado, incluyendo imagen holográfica, absorción perfecta [9], y lentes planas [10]. Debido al rápido desarrollo de tecnología terahercio y sus características únicas, también se ha convertido en tema popular de investigación en el campo de metamateriales en años recientes [11,12,13].
Aunque la aplicación de metamateriales es muy amplia, el método de diseño tradicional requiere que el diseñador realice repetidamente cálculos numéricos complejos en la estructura diseñada. Este proceso consume enorme tiempo y recursos computacionales. Por tanto, es urgente encontrar nuevas formas de simplificar o incluso reemplazar métodos de diseño tradicionales.
Como campo interdisciplinario, el aprendizaje automático cubre muchas disciplinas incluyendo ciencias de la vida, ciencias de la computación y psicología, ha estado trabajando para usar computadoras para imitar e implementar procesos de aprendizaje humano para adquirir nuevo conocimiento o habilidades. El principio básico del aprendizaje automático puede describirse simplemente como el uso de algoritmos computacionales para obtener correlación entre gran cantidad de datos o predecir reglas entre datos similares y finalmente lograr propósito de clasificación o regresión. Hasta ahora, muchos algoritmos de aprendizaje automático se han aplicado a la designación de metamateriales y han logrado resultados significativos, incluyendo algoritmos genéticos [14], algoritmos de regresión lineal [15], y redes neuronales someras. A medida que la estructura se vuelve más compleja y los cambios en la estructura se vuelven más diversos, los problemas requerirán más tiempo para resolver. Al mismo tiempo, la naturaleza altamente no lineal de los problemas hace difícil que algoritmos simples de aprendizaje automático obtengan predicciones precisas. Además, diseñar una estructura de metamaterial coincidente para un efecto electromagnético específico requiere que los diseñadores intenten y realicen cálculos numéricos complejos en la estructura. Estos procesos consumirán tremenda cantidad de tiempo y recursos computacionales.
Como uno de los algoritmos más destacados en el campo del aprendizaje automático, el aprendizaje profundo ha logrado logros mundialmente renombrados en varios campos relacionados como visión por computadora [16], extracción de características [17], y procesamiento de lenguaje natural [18]. Al mismo tiempo, éxitos en otros campos no relacionados con computación son numerosos, incluyendo muchas disciplinas básicas como ciencias de la vida, química [19], y física [20] [21]. Por tanto, aplicar aprendizaje profundo al diseño de metamateriales también es una dirección de investigación caliente actual, y han aparecido muchos trabajos destacados [22,23,24].
Inspirado por aprendizaje profundo, este artículo reporta un estudio usando algoritmo de aprendizaje automático basado en red neuronal profunda para predecir la estructura del resonador de anillo dividido (SRR) para lograr el propósito de diseño a demanda. Además, la red directa y la red inversa se entrenan innovadoramente por separado, lo que no solo puede mejorar la precisión de la red, sino también lograr diferentes funciones mediante combinación flexible. Los resultados muestran que el método puede lograr MSE de 0,0058 y 0,0055 en conjunto de entrenamiento y validación, respectivamente, y muestra buena robustez y generalización. Con el modelo entrenado guiando el diseño de estructuras de metamateriales, el ciclo de diseño puede acortarse a días o incluso horas, y la mejora en eficiencia es obvia. Además, este método también tiene buena escalabilidad y solo necesita cambiar los datos de conjunto de entrenamiento para diseñar diferentes entradas o diferentes estructuras a demanda.
Teoría y método
Construcción de modelo COMSOL
Para mostrar que el aprendizaje profundo puede aplicarse al diseño inverso de estructuras de metamateriales, modelamos una estructura SRR de tres capas consistente en anillo de oro, base de sílice y base de oro para observar su respuesta electromagnética bajo acción de luz incidente. Como se muestra en Fig. 1, el ángulo de apertura θ del anillo de oro, el radio interno r del anillo, y el ancho de línea d del anillo se seleccionan como variables independientes de esta estructura. Cuando un haz de luz polarizada linealmente entra en los metamateriales normalmente, se obtienen curvas longitud de onda-reflectancia bajo diferentes estructuras cambiando las variables estructurales. El espesor del anillo Au es 30 nm, de la base de SiO2 es 100 nm, y de la base de Au es 50 nm, y el tamaño de los meta-átomos es 200 nm por 200 nm.
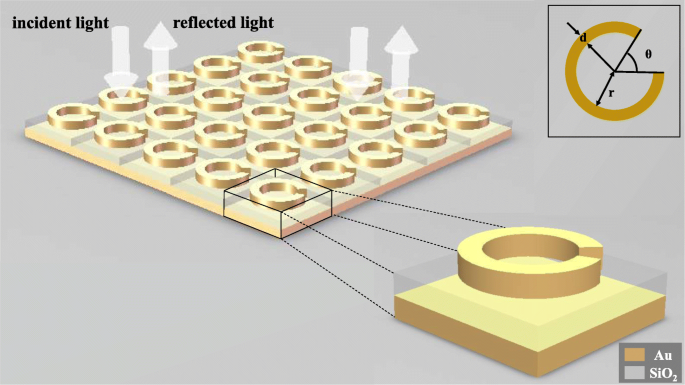
Usar COMSOL Multiphysics 5.4 [25] para modelar, elegir dimensión espacial tridimensional, elegir óptica ≥ óptica de ondas ≥ dominio de frecuencia de onda electromagnética (ewfd) para campo físico y seleccionar dominio de longitud de onda para investigación. Crear el modelo anterior en geometría. El material de cada parte y su índice de refracción se definen en orden en el material, y puertos y condiciones periódicas se añaden en el dominio de frecuencia de onda electromagnética.
Construcción de modelo de red neuronal de aprendizaje profundo
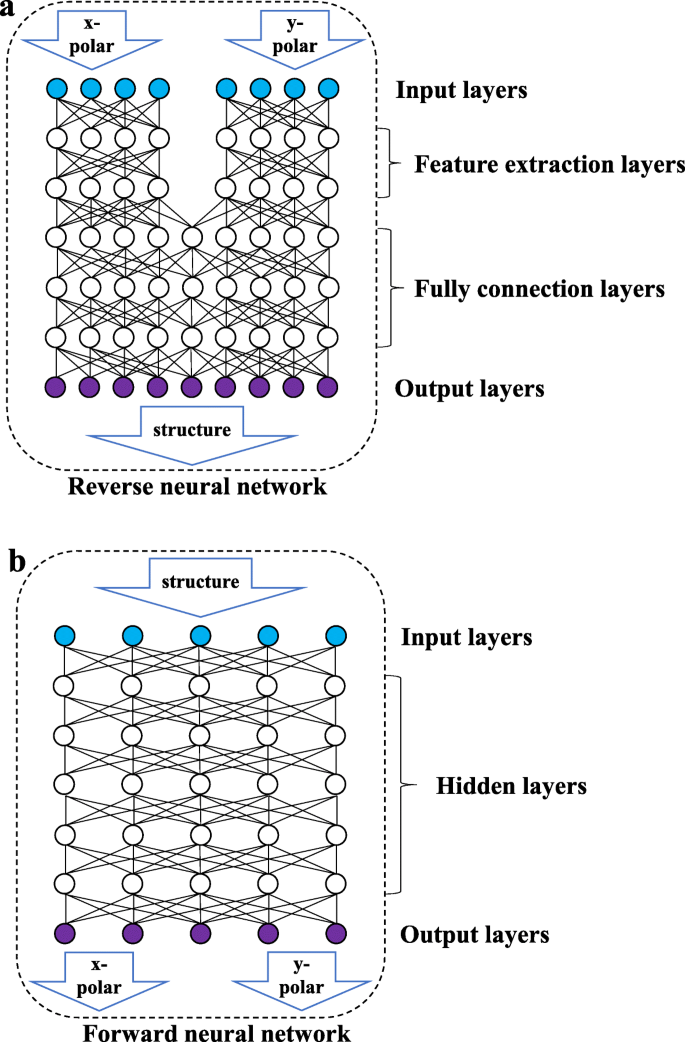
Hemos construido una red inversa y una red directa para la estructura de metamaterial. La red inversa puede predecir los parámetros estructurales del SRR a partir de las dos curvas de longitud de onda-reflectancia dadas con diferentes direcciones de polarización. La red directa puede predecir las curvas de longitud de onda-reflectancia en dos direcciones de polarización por los parámetros estructurales dados. La función de la red inversa es el cuerpo principal de la función de predicción. El papel de la red directa es verificar los resultados de predicción de la red inversa para observar si los resultados de predicción cumplen la respuesta electromagnética requerida.
Usar eclipse 2019 como plataforma de desarrollo, python3.7 como lenguaje de programación, y TensorFlow 1.12.0 como marco de desarrollo.
Las dos redes se entrenan por separado para mantener los resultados de entrenamiento de cada red sin ser afectados por el error de la otra red, asegurando así la precisión respectiva de las dos redes.
Como se muestra en Fig. 2, otra ventaja de entrenar las dos redes por separado es que pueden usarse para diferentes propósitos a través de diferentes secuencias de conexión: (a) red inversa + red directa, que puede usar la curva de longitud de onda-reflectancia dada para calcular parámetros estructurales, hacer predicciones y verificar si los resultados de predicción cumplen las necesidades, y (b) usar la red directa sola puede simplificar el proceso de cálculo del método de cálculo numérico y reducir el tiempo de cálculo.
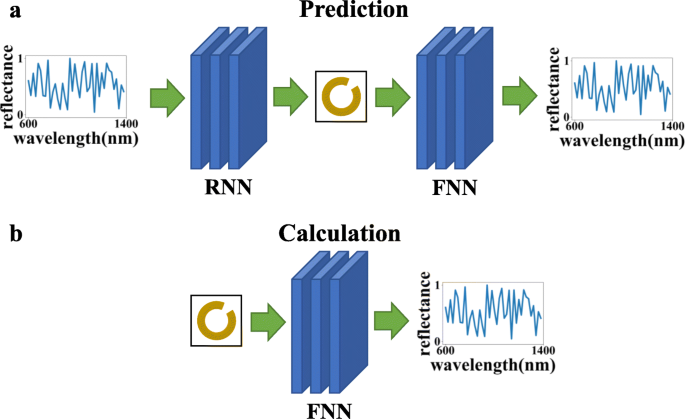
Vale notar que el proceso de entrada y obtención de resultados del modelo entrenado usando el método de aprendizaje profundo toma tiempo extremadamente corto. Y cuando se obtienen nuevos datos mediante simulación o experimento, el modelo puede usarse para entrenamiento adicional. Estudios han mostrado que con el aumento continuo de datos de entrenamiento, la precisión del modelo será cada vez mayor y el rendimiento de generalización mejor y mejor [26].
Los parámetros de la estructura son múltiples conjuntos de autovalores continuos, que pertenecen al problema de regresión. En años recientes, redes completamente conectadas han sido el foco de redes de aprendizaje profundo en problemas de regresión y han mostrado características de alta fiabilidad, gran throughput de datos y baja latencia. Hacer algunos ajustes en una red completamente conectada permitirá que la red prediga mejor la estructura.
Como se muestra en Fig. 3b, la red directa es una red completamente conectada en la que todos los nodos de dos capas adyacentes están conectados entre sí. Los datos de entrada son el parámetro estructural, y la salida es la curva de longitud de onda-reflectancia de las dos direcciones de polarización. Como se muestra en Fig. 3a, la red inversa consiste en una capa de extracción de características (capa FE) y una capa completamente conectada (capa FC). La capa FE incluye dos conjuntos de redes completamente conectadas que no están conectadas entre sí y procesan las curvas de longitud de onda-reflectancia de luz polarizada linealmente en dos direcciones para extraer algunas características de los datos de entrada. La capa FC aprenderá las características extraídas y emitirá los parámetros estructurales. Debido a las características de alta cohesión y bajo acoplamiento entre curvas de longitud de onda-reflectancia en diferentes estados de polarización, separar las entradas de dos conjuntos de datos de luz polarizada en diferentes direcciones puede prevenir que la red sea perturbada por estandarización de datos durante el proceso de extracción de datos. La red directa no involucra múltiples conjuntos de entradas y no necesita considerar interferencia mutua entre datos, por lo que no tiene capa de extracción de características.
Para determinar la estructura de red óptima, se entrenan redes en diferentes estructuras usando el mismo conjunto de datos. Como se muestra en Fig. 4, después de que los datos hayan experimentado 50 épocas (cuando todos los datos han sufrido un entrenamiento completo, se llama una época), el MSE alcanzado por la red directa de diferentes estructuras. Como se ve en la imagen izquierda de Fig. 4, cuando la red directa contiene 5 capas ocultas, cada capa conteniendo 100 nodos, el MSE más bajo alcanzado es aproximadamente 0,0174, por lo que se seleccionará la red directa de esta estructura.
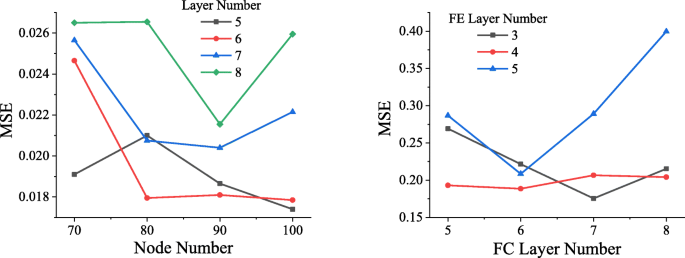
Similarmente, se entrenaron diferentes redes de redes inversas, y el volumen de entrenamiento se mantuvo en 50 épocas. El resultado se muestra en la figura derecha de Fig. 4. Cuando el número de capas FC es 7 y el número de capas FE es 3, la red alcanza el MSE más bajo, que es aproximadamente 0,1756.
Encontramos que un número mayor de capas de red producirá fenómeno de explosión de gradiente, lo que causará que la red no converja y la pérdida sea infinita, por lo que no se lista en la figura.
Preprocesamiento de datos
Para entrenar una red directa más confiable, los datos de reflectancia se re-dividen y se unen con la refractividad de Au y SiO2 correspondiente a cada frecuencia. Los datos recopilados se normalizan luego y se introducen en la red directa, lo que puede mejorar grandemente la precisión de la red directa.
Para asegurar que datos con valores mayores no tengan mayor impacto en la red que datos con valores menores, los datos de entrada necesitan normalizarse para que cada columna de datos se ajuste a la distribución normal estándar (valor medio 0, varianza 1), y entonces los datos procesados x pueden expresarse como sigue:
x = (x0 − μ) / σ
En la expresión, x0 son los datos originales de la muestra, μ la media de la muestra, y σ la desviación estándar de la muestra. Si los datos de entrada no se re-dividen, la reflectancia se distorsionará tras normalización, reduciendo la precisión de la red. Los datos re-divididos no afectarán su distribución debido a la normalización.
Método de red neuronal
El principio de la red neuronal es construir muchas neuronas (nodos) imitando la forma en que el cerebro humano funciona y aprende [27]. Las neuronas están conectadas entre sí, y la salida se ajusta ajustando el peso de conexión. La salida del nodo j-ésimo de una capa puede expresarse como sigue:
yj = Σi=1n f(wixi + bj) / n
f es la función de activación, wi es el peso de conexión del nodo i-ésimo de la capa anterior conectado al nodo j-ésimo, xi es la salida del nodo i-ésimo de la capa anterior, bj es el término de sesgo de este nodo, y n es el número de nodos en la capa anterior conectados al nodo j-ésimo.
Elección de función de activación
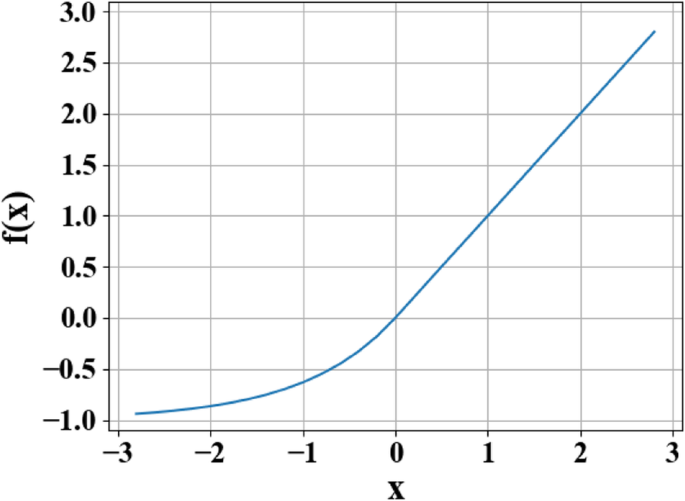
Para satisfacer la alta no linealidad del problema inverso, la función ELU [28] se usa como función de activación de cada capa de neuronas [28]. La salida f(x) de la función ELU puede expresarse en forma por tramos como sigue:
f(x) = { x si x ≥ 0; α(ex − 1) si x < 0 }
En esta función, x es la entrada original, y el valor del parámetro α varía de 0 a 1.
La razón para usar la función de activación es que la función de activación cambia la capacidad de expresión no lineal de cada capa de la red, mejorando así la capacidad general de ajuste no lineal de la red. Como se muestra en Fig. 5, la función ELU combina las ventajas de funciones de activación Sigmoid y unidad lineal rectificada (ReLU). Cuando x < 0, tiene mejor saturación suave, lo que hace la red más robusta a cambios de entrada y ruido. Cuando x > 0, no hay saturación, lo que ayuda a aliviar la desaparición del gradiente de la red. La característica de que el valor medio de ELU está cerca de 1 puede hacer la red más fácil de ajustar. El resultado prueba que usar ELU como función de activación del aprendizaje profundo, red neuronal mejora la robustez de la red significativamente.
Esquema de inicialización de pesos
El método de inicialización del peso de red de cada capa determina la velocidad de ajuste de la red e incluso determina si la red puede ajustarse o no. La inicialización de escalado de varianza se basa en la cantidad de datos de entrada en cada capa y extrae pesos de una distribución normal truncada centrada en 0, para que la varianza pueda reducirse a cierto rango, entonces los datos pueden propagarse más profundo a través de la red [29]. En esta estructura de red, usar inicialización de escalado de varianza puede hacer la velocidad de convergencia de la red significativamente más rápida.
Solución de sobreajuste
Debido a datos insuficientes, la red producirá algo de sobreajuste. Con sobreajuste reducido, la red puede tener buen rendimiento de generalización en datos fuera del conjunto de entrenamiento. La regularización L2 (también llamada decaimiento de peso en problemas de regresión) se usa para procesar el peso w. La salida regularizada L puede expresarse como sigue:
L = L0 + (λ / 2n) Σ w2
En Ec. (4), L0 representa la función de pérdida original, y un término de regularización (λ / 2n) Σ w2 se añade sobre esta base, donde λ representa el coeficiente de regularización, n el throughput de datos, y w el peso. Tras añadir el término de regularización, el valor del peso w tiende a disminuir overall, y se puede evitar la ocurrencia de valores excesivos, por lo que w también se llama atenuación de peso. La regularización L2 puede reducir el peso para evitar gran pendiente de la curva ajustada, aliviando efectivamente el fenómeno de sobreajuste de la red y ayudando a converger.
Sobre esta base, el método dropout también se usa. Este método puede considerarse visualmente como "ocultar" cierta escala de nodos de red para cada entrenamiento, y ocultar diferentes nodos durante cada entrenamiento, para lograr el objetivo de entrenar múltiples "redes parciales". Y a través del entrenamiento, la mayoría de las "redes parciales" pueden representar precisamente los objetivos, y los resultados de todas las "redes parciales" pueden ordenarse para obtener la solución de los objetivos.
Usar los métodos de regularización L2 y dropout mencionados puede no solo aliviar efectivamente la baja generalización causada por datos insuficientes, sino también reducir el impacto de pequeña cantidad de datos erróneos en el conjunto de datos en los resultados de entrenamiento.
En esta estructura de red y conjunto de datos, con dropout = 0,2 y coeficiente de regularización L2 λ = 0,0001, la red puede obtener precisión similar en conjunto de entrenamiento y prueba, logrando así alto rendimiento de generalización.
Resultado y discusión
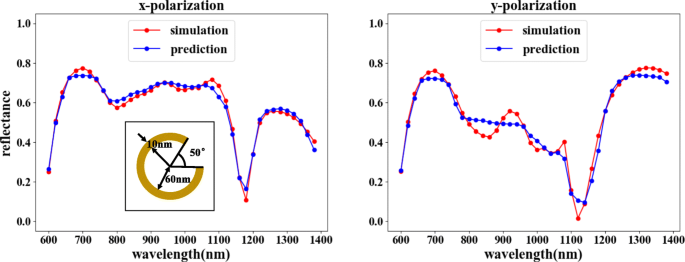
Tras entrenamiento, nuestra red directa puede lograr alto grado de ajuste, con MSE de 0,0015, lo que muestra que la salida es muy similar a resultados de simulación, como se muestra en Fig. 6. Esto también asegura que al entrenar la red inversa, los resultados de la red inversa pueden verificarse confiablemente.
Finalmente, generaremos dos modelos de la red aprendida y conectaremos los dos modelos para lograr la función de predicción.
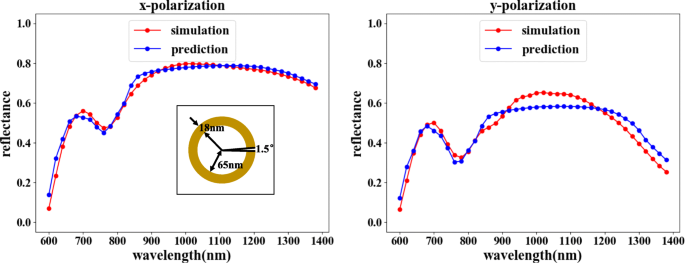
La función de predicción puede elegir la combinación mostrada en Fig. 2a. La red inversa predice la estructura correspondiente según la curva de longitud de onda-reflectancia requerida, y la red directa verifica la respuesta óptica de la estructura. Como se muestra en Fig. 7, al comparar la reflectancia verificada con la reflectancia de entrada, las características de reflectancia de luz incidente en dos direcciones de polarización son básicamente consistentes. Aunque desajuste menor de reflectancia es observable para ciertos valores de longitud de onda, la tendencia de coincidencia general es claramente irrefutable, ya que los errores están bien dentro de rango aceptable.
Conclusión
En este artículo, presentamos nuestra red de aprendizaje profundo diseñada, capaz de crear varios efectos mediante combinaciones flexibles de configuraciones de red. Nuestra red inversa diseñada puede predecir la estructura requerida usando la curva de longitud de onda-refractiva de entrada, lo que puede reducir grandemente el tiempo requerido en resolver el problema inverso y satisfacer diferentes necesidades mediante combinaciones flexibles. Los resultados indican que la red ha logrado mayor precisión en predicciones, lo que implica además que el diseño a demanda puede resolverse mediante nuestro método. Usar aprendizaje profundo para guiar el diseño de metamateriales puede obtener automáticamente estructuras de metamateriales más precisas, resultado inalcanzable por métodos de diseño tradicionales.
Disponibilidad de datos y materiales
La fecha del manuscrito proviene de nuestra red de simulación, y no podemos compartirla por razones personales.
Abreviaturas
- ELU:
- Unidades lineales exponenciales
- Capa FC:
- Capa completamente conectada
- Capa FE:
- Capa de extracción de características
- FNN:
- Red neuronal directa
- MSE:
- Errores cuadráticos medios
- ReLU:
- Unidad lineal rectificada
- RNN:
- Red neuronal inversa
- SRR:
- Resonador de anillo dividido
Nanomateriales
- Construye un Reconocedor de Dígitos con Raspberry Pi, TensorFlow y OpenCV
- Robot móvil que evita obstáculos basado en visión en Raspberry Pi
- TI presenta primer SoC automotriz con acelerador IA dedicado
- Predicción Precisa de Vida Útil de Baterías con IA – Estudio DOE Argonne
- Acelerando Deep Learning con FPGAs: Velocidad, Flexibilidad y Eficiencia Energética
- Eleve la confiabilidad de activos: Aproveche Machine Learning para rendimiento proactivo de activos
- Wireless Network Devices y Sigfox Despliegan Red IoT Nacional en Reino Unido
- Dominando el método split() de Java: Guía práctica con ejemplos de código
- Neuronas artificiales de cambio de fase de IBM imitan picos cerebrales para computación ultra-densa y bajo consumo
- Mejora Eléctrica Sinérgica en Compuestos Epóxicos con Nanotubos Carbono y Nanoestructuras Grafito
- Nanoesferas de carbono monodispersas con porosidad jerárquica ofrecen rendimiento superior en supercondensadores