



Acelerando Deep Learning con FPGAs: Velocidad, Flexibilidad y Eficiencia Energética
Acelerando Deep Learning con FPGAs: Velocidad, Flexibilidad y Eficiencia Energética
Recientemente asistí al 2018 Xilinx Development Forum en Silicon Valley, donde descubrí Mipsology, una startup que afirma haber resuelto los desafíos relacionados con IA de desplegar redes neuronales en field-programmable gate arrays (FPGAs). Fundada con una visión audaz, Mipsology demuestra cómo FPGAs pueden acelerar cualquier red neuronal al máximo rendimiento posible, sin las restricciones de despliegue tradicionales.
Usando las nuevas tarjetas Alveo de Xilinx, Mipsology logró más de 20.000 imágenes por segundo a través de una suite de redes populares, incluyendo ResNet-50, Inception-V3 y VGG-19.
¿Qué Son Redes Neuronales y Deep Learning?
Las redes neuronales, inspiradas en la red de neuronas del cerebro humano, forman la columna vertebral del deep learning (DL). DL es un marco matemático que aprende a realizar tareas autónomamente exponiendo la red a grandes volúmenes de datos. El proceso de entrenar una red neuronal —presentándole millones de muestras etiquetadas— es seguido por inferencia, donde el modelo entrenado predice resultados para nuevos datos.
Por ejemplo, una red de reconocimiento de voz podría entrenarse en miles de grabaciones de voz y luego desplegarse para transcribir palabras habladas en tiempo real.
Por Qué la Inferencia Demanda Rendimiento Extremo
La inferencia requiere billones o trillones de adiciones y multiplicaciones por segundo —mucho más que el entrenamiento, que ocurre solo una vez. Consecuentemente, la inferencia es el principal impulsor de demanda computacional en sistemas IA de producción.
Cuatro Opciones de Hardware para Inferencia Deep-Learning
Los ingenieros han confiado tradicionalmente en cuatro categorías de procesadores, ordenados de más a menos hambrientos de potencia y menos flexibles: CPUs → GPUs → FPGAs → ASICs. La tabla abajo resume diferencias clave.
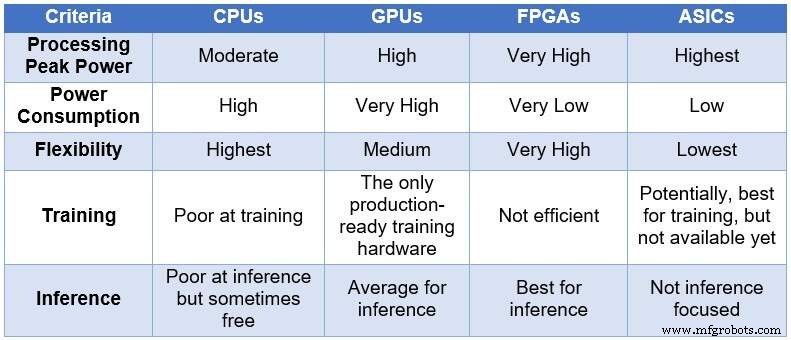
Comparación de CPUs, GPUs, FPGAs y ASICs para cómputo DL (Fuente: Lauro Rizzatti)
- CPUs ofrecen máxima flexibilidad pero sufren alta latencia y bajo throughput para cargas DL.
- GPUs entregan masivo paralelismo pero consumen potencia significativa y requieren refrigeración robusta.
- ASICs pueden ser extremadamente eficientes para una tarea estrecha, yet su largo ciclo de desarrollo y arquitectura fija los hace mal adaptados para modelos que evolucionan rápido.
- FPGAs combinan alto throughput, bajo consumo de potencia y reconfigurabilidad, haciéndolos ideales para cargas de inferencia dinámicas.
Por Qué FPGAs Sobresalen en Inferencia
FPGAs modernos contienen millones de elementos lógicos, miles de bloques DSP y memoria embebida y núcleos ARM —todos operando en paralelo. Un solo ciclo de reloj puede disparar millones de operaciones concurrentes, permitiendo trillones de cálculos por segundo que mapean naturalmente a cargas DL.
Ventajas clave de FPGAs sobre CPUs y GPUs incluyen:
- Soporte para precisión de datos arbitraria, permitiendo aritmética de baja precisión que impulsa throughput.
- Envolventes de potencia cinco a diez veces menores que soluciones CPU o GPU comparables para cargas de trabajo idénticas.
- Reconfigurabilidad: el mismo dispositivo puede actualizarse para soportar nuevos modelos sin fabricar nuevo silicio.
- Escalabilidad de dispositivo: desde tarjetas data-center high-end a módulos edge compactos, FPGAs encajan una amplia gama de escenarios de despliegue.
Desafíos y Trade-offs
A pesar de sus fortalezas, FPGAs presentan una curva de aprendizaje empinada. Desarrollar diseños de alto rendimiento requiere lenguajes de descripción de hardware especializados y profunda comprensión de paralelismo, lo que puede ser barrera para equipos acostumbrados a workflows software-centric.
No obstante, para organizaciones que demandan la combinación de velocidad, flexibilidad y eficiencia energética, FPGAs representan la plataforma más convincente para inferencia deep-learning hoy.
Tecnología de Internet de las cosas
- Deep Learning: Transformando Industrias con Automatización Inteligente
- Aprendizaje Profundo: Revolucionando la Automatización de Inspección en Ciencias de la Vida
- IA, Aprendizaje Automático y Aprendizaje Profundo: Diferencias Clave y Funcionamiento
- Apple e IBM Watson unen fuerzas para impulsar machine learning móvil empresarial
- Logre Estabilidad Inigualable en Taladrado de Agujeros Profundos
- CEVA presenta NeuPro‑S: Procesador IA next‑gen para inferencia deep neural network en el edge
- Chips neuromórficos: La próxima frontera para rendimiento IA
- ICP Mustang-F100: Acelerador FPGA para Inferencia Deep Learning Tiempo Real
- ETSI Revela el Primer Blueprint de Estándar de Seguridad para IA
- Externalización de IA y Deep Learning en Salud: Protegiendo la Privacidad de los Datos
- El papel de la IA en el crecimiento exponencial del sector High-Tech