



Data Lake vs Big Data: Elegir el Enfoque Correcto para Aplicaciones Industriales
Data lake y big data son dos términos modernos a menudo malinterpretados y usados incorrectamente. Debido a los grandes volúmenes de datos implícitos, a veces se usan indistintamente. Sin embargo, data lake y big data son diferentes, aunque sus definiciones actuales aún no estén completamente establecidas.
Figura 1. Los datos modernos pueden venir de muchas fuentes y ser de diferentes tipos. Imagen cortesía de Analytics Vidhya.
Veamos primero un breve contexto histórico. A finales de los 2000, con el crecimiento explosivo de plataformas de redes sociales como Facebook y Twitter, muchos científicos de datos comenzaron a darse cuenta del potencial de estas plataformas para generar grandes cantidades de datos personales valiosos. En consecuencia, se desarrollaron nuevas aplicaciones de software para facilitar el procesamiento y análisis de datos. Un ejemplo prominente es Apache Hadoop, esencialmente un kit de herramientas de aplicaciones de código abierto que pueden procesar información a nivel de big data.
En la siguiente década, el Internet de las Cosas (IoT) entró en escena. Esto abrió las puertas a millones de fuentes de datos más que podían proporcionar insights sobre preferencias y patrones de una persona, mientras enviaban información sobre el producto mismo.
Simultáneamente, el machine learning hacía avances importantes y encontraba más aplicaciones prácticas en el panorama industrial. Esto resultó en una mayor necesidad de manejar grandes volúmenes de datos en las industrias, particularmente en procesos automatizados.
Todas las proyecciones indican que la cantidad total de datos disponibles en el mundo seguirá expandiéndose a ritmos acelerados en los próximos años. Como referencia, en 2016 el mundo pasó el hito de 1 Zettabyte de tráfico de internet anual generado. Un Zettabyte equivale a 1 billón de Gigabytes.
Se espera que el tráfico anual de internet supere los 3 Zettabytes en 2021. Estas proyecciones, junto con las capacidades expandidas de computación en la nube, indican que el valor y usos del big data (y data lakes) quizás apenas estén comenzando.
¿Qué es Big Data?
Mirándolo simplemente desde la perspectiva del volumen, la definición de big data es un objetivo móvil. A medida que la cantidad de datos y espacio de almacenamiento sigue creciendo, también lo hace el referente de lo que se considera grandes cantidades de información.
Hoy, un repositorio de datos de 100 Terabytes o más se considera generalmente en el rango de big data. Grandes repositorios como los de plataformas de redes sociales pueden estar en el rango de varios Petabytes.
Otra referencia para definir big data es cuando la cantidad de información no puede ser manejada por herramientas informáticas tradicionales, como SQL. Por ejemplo, hoy no es raro que las bases de datos alcancen 1 Terabyte anual. Pero, con aplicaciones SQL volviéndose más potentes, esta magnitud aún puede gestionarse; por tanto, no se consideran típicamente big data.
El Modelo 4V del Big Data
Hasta ahora hemos mirado la definición desde la perspectiva del volumen. Hay tres factores más importantes: velocidad, variedad y veracidad. Estos, junto con el volumen, forman el modelo 4V.
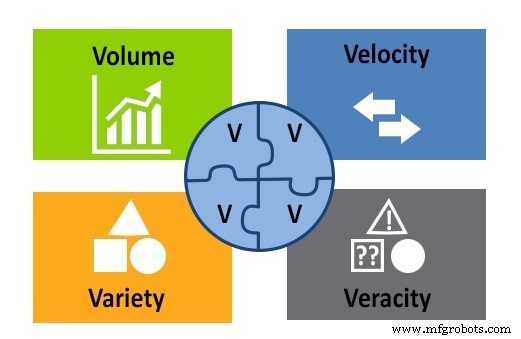
Figura 2. El modelo 4V del big data: Volumen, velocidad, variedad y veracidad. Imagen cortesía de APSense.
Variedad se refiere a todos los diferentes tipos de datos almacenados en un repositorio big data: texto, imágenes, sonido, vídeo, etc. También se refiere a que los datos pueden venir de múltiples fuentes.
Velocidad es una consideración importante en big data porque la información fluye constantemente. La velocidad se refiere a la rapidez con que los datos se recopilan, generan y distribuyen.
Veracidad mide la exactitud y calidad de los datos para evaluar si un científico de datos puede usarlos para análisis y llegar a conclusiones.
Ahora que entendemos big data, revisemos data lakes antes de ver cómo usar estos en un sistema de control.
¿Qué es un Data Lake?
Los data lakes son repositorios centralizados de grandes cantidades de datos en bruto, que es información que puede o no ser valiosa en el futuro y cuyo propósito no se conoce al 100% aún. Los data lakes pueden almacenar bases de datos relacionales y no relacionales, junto con otros tipos de archivos y entidades.
Aunque la información en un data lake no está procesada ni organizada, se estructura para que todas las entradas y salidas se consideren para crear una buena arquitectura.
Data Lake vs Big Data
Un data lake es una instancia de una aplicación de big data. Siguen los criterios del modelo 4V, con algunas particularidades añadidas. En términos de volumen, los data lakes están, en promedio, cerca del extremo inferior de lo que se considera big data.
La información en data lakes tiene variedad, pero con la condición de que sean solo datos en bruto sin procesar. Las velocidades de entrada y salida son tan relevantes como en cualquier sistema moderno y las evaluaciones de calidad de datos se realizan en un data lake bien diseñado.
Aplicaciones Industriales para los Datos
La automatización avanzada impulsa un rápido aumento en la cantidad de información manejada en la planta. Gracias a esto, los procesos de fabricación e industriales están entrando en el ámbito del big data, con varias actividades de negocio empleando herramientas como data lakes.
Un ejemplo prominente es el mantenimiento predictivo. La capacidad de predecir un fallo mecánico o eléctrico es muy valiosa y puede proporcionar ahorros sustanciales en costes de reparación. Los data lakes son herramientas útiles que pueden compilar información proveniente de archivos de log, múltiples sensores y dispositivos de entrada, que pueden usarse para entender tendencias y predecir problemas.
El machine learning es un concepto en el que se proporciona a los robots información que les ayuda a adaptarse a condiciones externas cambiantes. La captura de información es similar al mantenimiento predictivo, con el paso adicional de que evaluaciones y cambios al proceso se alimentan automáticamente al controlador del sistema. Los datos de machine learning pueden almacenarse en un data lake estructurado.
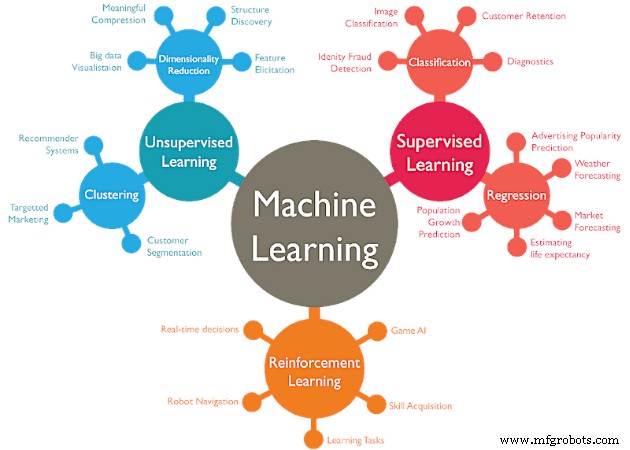
Figura 3. El machine learning tiene varias estrategias que cada una requiere grandes cantidades de datos. Imagen cortesía de WordStream.
Para concluir, un data lake es una instancia de una aplicación de big data. Estas dos formas de ver los datos pueden trabajar juntas. Utilizando tanto big data como data lake, un ingeniero de control puede predecir fallos, crear rutinas de mantenimiento, impulsar la transformación digital de la instalación y mucho más.
¿Para qué usas big data y data lakes en tu trabajo?
Tecnología de Internet de las cosas
- GE lanza Predix Cloud: Plataforma dedicada para datos industriales y analítica
- Las 7 Principales Aplicaciones de IIoT Industrial que Impulsan el Crecimiento del Mercado
- Guía Cervoz: Seleccionar almacenamiento flash fiable para aplicaciones industriales
- Cómo sensores conectados y procesadores inteligentes impulsan la Industria 4.0
- Perspectiva Futura: Avanzando Industrial IoT para Excelencia en Producción
- Los 4 Principales Retos que Enfrenta el Internet Industrial de las Cosas (IIoT)
- Seis principios clave para construir aplicaciones IoT impulsadas por sensores de alto impacto
- Aprovechando RTUs para obtener insights de Big Data en operaciones industriales
- Construyendo cimientos para el éxito de la ciencia de datos industrial
- IoT Industrial: De la Captura de Datos a la Toma de Decisiones en Tiempo Real
- ¿Pueden los Big Data Revolucionar los Presupuestos de Salud? Insights de Lux Research