



Dominando el Ciclo de Vida de la Ciencia de Datos: Una Guía Completa
Desde la llegada de los macrodatos (big data), la informática moderna ha alcanzado nuevas capacidades y referentes de potencia de procesamiento. Hoy no es raro encontrar aplicaciones que generan conjuntos de datos de 100 terabytes o más, lo que se considera big data.
Con semejantes volúmenes de información, es fácil desorganizarse y perder tiempo con contenido inútil. Estas son dos razones por las que es crucial seguir una metodología que aumente la eficacia y eficiencia de un proyecto de big data.
Figura 1. La ciencia de datos moderna trabaja con conjuntos de datos muy grandes, también conocidos como big data.
El ciclo de vida de la ciencia de datos proporciona un marco que ayuda a definir, recopilar, organizar, evaluar e implementar proyectos de big data. Es un proceso iterativo que consiste en una serie de pasos dispuestos en secuencia lógica, facilitando la retroalimentación y los cambios de dirección.
¿Qué aspecto tiene la secuencia del ciclo de vida? La respuesta es que no existe un modelo universal único que todos sigan. Muchas empresas que emprenden proyectos de big data adaptan el ciclo a sus procesos de negocio, incluyendo típicamente más pasos. A pesar de esto, todos los modelos y flujos tienen denominadores comunes. Este artículo usará el modelo CRISP-DM, uno de los primeros y más populares modelos de ciclo de vida de ciencia de datos.
El Modelo CRISP-DM
CRISP-DM significa Cross Industry Standard Process for Data Mining (Proceso Estándar Interindustrial para Minería de Datos). Se publicó por primera vez en 1999 por ESPRIT, un programa europeo para impulsar la investigación en tecnología de la información (TI). El modelo CRISP-DM consta de seis pasos o fases que guían el proyecto de big data. Alienta a las partes interesadas a pensar en el negocio planteando y respondiendo preguntas importantes sobre el problema.
Revisemos en detalle las seis fases del modelo CRISP-DM.
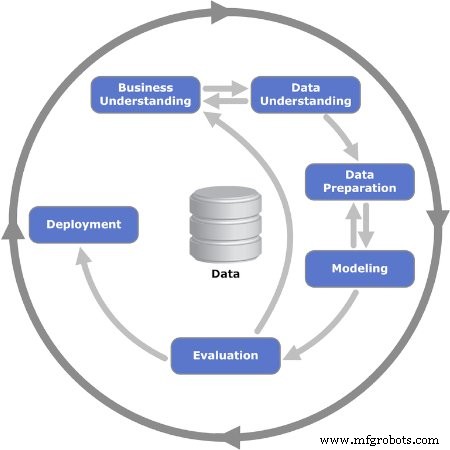
Figura 2. Las seis fases iterativas del modelo CRISP-DM. Imagen cortesía de Kenneth Jensen.
Fase 1: Comprensión del Negocio
La primera fase consiste en varias tareas que definen el problema y establecen los objetivos. Es cuando se fijan los objetivos del proyecto con foco en el negocio —o, en otras palabras, en el cliente. Normalmente, el equipo reunido para un proyecto de big data debe entregar una solución al cliente, que puede ser otra área o departamento de la empresa.
Una vez establecida la necesidad o problema del negocio, el siguiente paso es definir los criterios de éxito. Estos pueden ser indicadores clave de rendimiento (KPI) o acuerdos de nivel de servicio (SLA), que proporcionan medios objetivos para evaluar el progreso y la finalización.
Luego, la situación del negocio debe analizarse para identificar riesgos, planes de retroceso, medidas de contingencia y, más importante, disponibilidad de recursos. Se elabora un plan de proyecto, incluyendo hitos y recursos.
Fase 2: Comprensión de los Datos
Una vez establecidos los fundamentos en la fase anterior, es hora de centrarse en los datos. Esta fase comienza con una definición inicial de qué datos se cree necesarios, y luego documenta especificaciones: dónde encontrarlos, tipo de dato, formato, relaciones entre diferentes campos, etc.
Con la primera documentación lista, el siguiente paso es ejecutar la primera recopilación de datos. Esto proporciona una instantánea útil de cómo se está formando la estructura. Esta instantánea se evalúa luego en cuanto a calidad.
Fase 3: Preparación de los Datos
La tercera fase refuerza la anterior y prepara el conjunto de datos para el modelado. Los campos de datos de la primera recopilación se curan más, y cualquier información considerada innecesaria se elimina: esto se llama limpieza de datos.
Además, una información específica puede necesitar derivarse de otra disponible; otras veces, debe combinarse. En otras palabras, los datos deben procesarse para producir un formato final.
Fase 4: Modelado
La tarea más importante en esta fase es seleccionar un algoritmo para procesar los datos recopilados. En este contexto, un algoritmo es un conjunto de pasos secuenciales y reglas programadas en software diseñado para proyectos de big data.
Se pueden usar muchos algoritmos: regresiones lineales, árboles de decisión, máquinas de vectores de soporte son algunos ejemplos. Elegir el algoritmo correcto para resolver el problema requiere habilidades que tienen los científicos de datos experimentados.
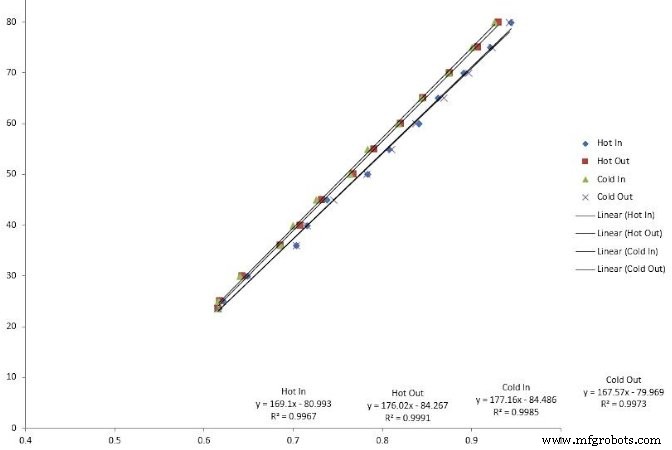
Figura 3. La regresión lineal es un tipo de algoritmo usado en modelado de big data.
El siguiente paso es codificar el algoritmo en la aplicación de software. También es cuando se planifica la fase de prueba, que consiste en asignar conjuntos de datos específicos para prueba y validación.
Fase 5: Evaluación
A veces es difícil elegir un algoritmo desde el inicio. Cuando esto ocurre, los científicos ejecutan varios algoritmos y analizan los resultados para tomar una decisión final. Una vez completada la fase de prueba, los resultados se revisan por completitud y precisión.
Más importante aún, es una oportunidad para evaluar si los resultados conducen hacia una solución. En el modelo iterativo, esta es una intersección crucial donde pueden lanzarse secuencias de iteración mayores, o tomarse la decisión de avanzar hacia la fase final.
Fase 6: Despliegue
Es cuando el proyecto pasa de un entorno de prueba a uno de producción en vivo. Planificar el calendario y la estrategia de despliegue es muy importante para reducir riesgos y posible tiempo de inactividad del sistema.
Aunque el diagrama del modelo sugiere que esto es el final del proyecto, aún quedan numerosos pasos de seguimiento: monitorización y mantenimiento. La monitorización es un período de observación cercana, también conocido como hipercuidado, inmediatamente después del lanzamiento. El mantenimiento es un proceso semi-permanente para mantener y actualizar la solución implementada.
El big data se llama así por una razón: hay una cantidad masiva de datos que analizar. Implementar uno de los modelos de ciclo de vida de ciencia de datos ayuda a decidir qué información vale la pena conservar y usar para procesos como mantenimiento predictivo.
Tecnología de Internet de las cosas
- Aprovechando el Sonido: Transformando Transmisión de Datos Más Allá de Smartphones
- Externalización de IA y Deep Learning en Salud: Protegiendo la Privacidad de los Datos
- Mantenimiento Predictivo: Aprovechar Industria 4.0 para Producción Ininterrumpida
- Optimizar el Ciclo de Vida de la SIM: Estrategia Digital para CSPs
- Democratizando el Internet de las Cosas: IoT satelital de nueva generación brinda conectividad universal y asequible
- Desbloquear el valor de los datos IoT: Estrategias seguras y basadas en insights
- Empoderando a expertos de dominio con ciencia de datos para insights manufactureros más inteligentes
- Por qué la conectividad directa de dispositivos es el próximo hito en el IoT industrial
- Por qué las mediciones analógicas impulsan el rendimiento de la planta
- Tableau: Transformando datos brutos en insights estratégicos
- Construyendo cimientos para el éxito de la ciencia de datos industrial