



Nuevo chip IA de baja precisión de IBM logra 25,6 TFLOPS entrenamiento y 102,4 TOPS inferencia
En el ISSCC 2024, IBM Research presentó un prototipo de 7 nm que encarna años de trabajo en entrenamiento e inferencia IA de baja precisión. El chip entrega entrenamiento de 16 y 8 bits, así como inferencia de 4 y 2 bits —muy por debajo de la norma industrial de entrenamiento 32 bits / inferencia 8 bits.
Reducir la precisión numérica recorta requisitos de cómputo y potencia, pero IBM también introdujo varias optimizaciones arquitectónicas que mejoran aún más la eficiencia. El reto clave es reducir precisión sin dañar exactitud —un problema que IBM ha abordado desde el nivel algorítmico durante años.
El Centro de Hardware IA de IBM, lanzado en 2019, busca impulsar rendimiento de cómputo IA 2,5× anualmente, apuntando a mejora de 1000× en FLOPS/W para 2029. Tales metas ambiciosas son impulsadas por el crecimiento explosivo de modelos IA —especialmente sistemas NLP de trillones de parámetros— y la creciente huella de carbono de su entrenamiento.
En el prototipo, el chip de 4 núcleos alcanza 25,6 TFLOPS para entrenamiento de 8 bits, mientras entrega 102,4 TOPS para inferencia entera de 4 bits (ambos medidos a 1,6 GHz y 0,75 V). Bajando reloj a 1 GHz y voltaje a 0,55 V mejora eficiencia energética a 3,5 TFLOPS/W (FP8) o 16,5 TOPS/W (INT4).
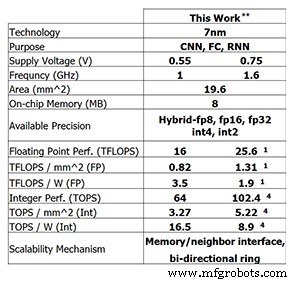
Rendimiento del chip de prueba de IBM Research (Imagen: IBM Research) **Rendimiento reportado en 0% dispersidad. (1) FP8. (4) INT4.
Entrenamiento de baja precisión
Este rendimiento se basa en años de trabajo algorítmico en técnicas de entrenamiento e inferencia de baja precisión. El chip es el primero en soportar el formato híbrido FP8 de IBM, introducido en NeurIPS 2019, que permite entrenamiento de 8 bits reduciendo a la mitad el cómputo de entrenamiento de 16 bits sin comprometer resultados.
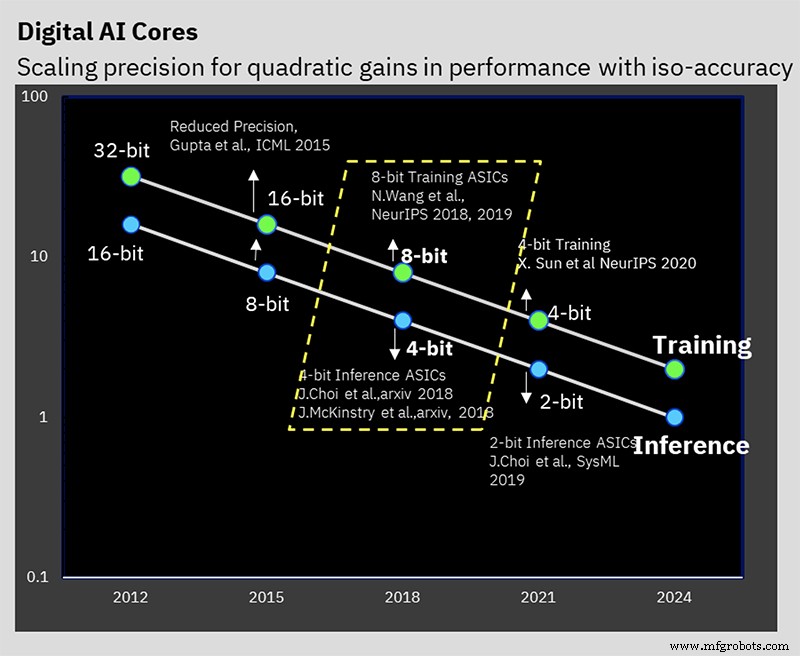
IBM Research ha estado trabajando en resolver el problema de mantener exactitud al reducir precisión (Imagen: IBM)
«El entrenamiento de baja precisión es desafiante, pero el entrenamiento de 8 bits es alcanzable con los formatos numéricos adecuados», dijo Kailash Gopalakrishnan, IBM Fellow y senior manager para arquitecturas de aceleradores y machine learning. «Los formatos numéricos correctos, aplicados a los tensores correctos, son críticos».
FP8 híbrido combina dos formatos: uno para pesos y activaciones en el forward pass, y otro para gradientes en el backward pass. El entrenamiento requiere ambos pases, mientras la inferencia usa solo el formato forward.
«Encontramos que los tensores forward necesitan mayor fidelidad —más precisión en la mantisa— mientras los gradientes demandan rango dinámico más amplio con exponente mayor. Este trade-off llevó a la división 1‑4‑3 (signo-exponente-mantisa) para forward y exponente de 5 bits para backward, dando rango dinámico de 232. Nuestro hardware ahora soporta ambas variantes».
Acumulación jerárquica
La técnica de «acumulación jerárquica» de IBM reduce precisión durante acumulación junto a pesos y activaciones. El entrenamiento FP16 tradicional acumula en aritmética de 32 bits para preservar exactitud, pero el esquema de 8 bits acumula en FP16. Al agrupar acumulaciones largas en trozos menores y sumar esos, el chip minimiza errores de redondeo sin sacrificar beneficios de menor precisión.
«Sumar miles de números secuencialmente puede degradar precisión», explicó Gopalakrishnan. «Fragmentar la acumulación mantiene la suma exacta mientras mantiene el hardware ligero».
Inferencia de baja precisión
Mientras la mayoría de motores de inferencia usan INT8, IBM demostró que aritmética entera de 4 bits puede igualar exactitud state-of-the-art. Tras cuantización, un paso de entrenamiento quantization-aware reduce la pérdida de exactitud a menos del 0,5 %, aceptable para muchas aplicaciones.
Anillo on-chip
El chip incorpora una network-on-chip optimizada para deep learning, permitiendo a los núcleos hacer multicast de datos eficientemente. Esto reduce tráfico de memoria off-chip y demandas de ancho de banda.
«Desacoplamos la frecuencia de operación del anillo de la de los núcleos, permitiendo optimización independiente y mayores velocidades de núcleo sin la latencia de largo cable del anillo», dijo Ankur Agrawal, miembro de investigación en machine learning y arquitecturas de aceleradores.
Gestión de potencia
IBM introdujo un esquema de escalado de frecuencia que mantiene el chip cerca de su envoltura de potencia durante la carga de trabajo. Estableciendo voltaje y frecuencia iniciales agresivamente, el chip mantiene alto rendimiento durante fases compute-intensive y se adapta a menor demanda sin costosos cambios de voltaje.
«Las cargas de trabajo deep learning tienen picos y valles de potencia distintos», anotó Agrawal. «Nuestra estrategia mantiene consumo de potencia estable, convirtiendo valles en ganancias de rendimiento».
Chip de prueba
El diseño de 4 núcleos equilibra complejidad de conectividad con tamaño de núcleo, ofreciendo arquitectura escalable. IBM prevé chips de 1‑2 núcleos para dispositivos edge y chips de 32‑64 núcleos para despliegues en centros de datos, todos capaces de FP16, FP8 híbrido, INT4 e INT2.
«Diferentes dominios de aplicación demandan diferentes trade-offs de precisión y energía», dijo Gopalakrishnan. «Nuestra navaja suiza de formatos nos permite apuntar a cada caso de uso sin comprometer eficiencia».
Complementando el hardware, IBM Research lanzó la pila de compilador «Deep Tools», logrando 60‑90 % utilización en el chip.
Según entrevista previa, chips IA de baja precisión basados en esta arquitectura deberían llegar al mercado dentro de dos años.
>> Este artículo se publicó originalmente en nuestro sitio hermano, EE Times.
Contenidos Relacionados:
- Chips IA mantienen exactitud con reducción de modelo
- Entrenando modelos IA en el edge
- La carrera está en marcha para IA en el edge
- Edge AI desafía tecnología de memoria
- Grupo de ingeniería busca impulsar IA de 1mW al edge
- Aplicación de redes neuronales para tareas de pequeña escala
- Investigación IC IA explora arquitecturas alternativas
Para más Embedded, suscríbete al boletín semanal de Embedded.
Incrustado
- Gestión de Mantenimiento Ante Recortes de Personal: Subcontratación Estratégica y Monitoreo Continuo
- Rockwell Automation se asocia con ATCC para expandir formación en automatización en el centro de Minnesota
- Top 10 componentes de precisión fabricados por máquinas herramienta CNC
- Impulse el ROI de su marketing con precisión de nivel de agencia
- IBM: Mejora de la fiabilidad y seguridad de activos con soluciones EAM proactivas
- Impulse su ROI de marketing con precisión de nivel de agencia
- Mecanizado de Precisión: Construyendo Sistemas Hidráulicos Superiores para Manufactura y Construcción
- Elecciones de diseño Bluetooth Mesh: Módulo vs. Dispositivo discreto
- MIT logra avance: chip ID criptográfico de 1,6 mm² combate contrafeiting con backscatter terahertz
- Investigadores Revelan BrakTooth: 16 Vulnerabilidades en Bluetooth Classic Afectan 1.400+ Dispositivos ESP32
- Cómo IBM Watson Impulsa la Innovación en IA a Través de las Industrias