



Dominando programación y depuración multicore: estrategias para rendimiento y fiabilidad
En este artículo examinamos la evolución de procesadores multicore, su creciente prevalencia y las consideraciones de diseño, rendimiento y depuración que les acompañan.
Rendimiento del sistema
Las ganancias de rendimiento en sistemas embebidos pueden lograrse mediante optimizaciones de compilador sofisticadas, arquitecturas hardware eficientes y, cada vez más, ejecución paralela a través de múltiples núcleos. Aunque algoritmos de compilador inteligentes pueden exprimir velocidad adicional de código single-threaded, la vieja suposición de que las frecuencias de reloj seguirían duplicándose cada pocos años se ha vuelto insostenible. El techo de rendimiento moderno se sitúa en el rango de GHz de un solo dígito bajo, haciendo del paralelismo la vía más viable para escalar.
Paralelismo
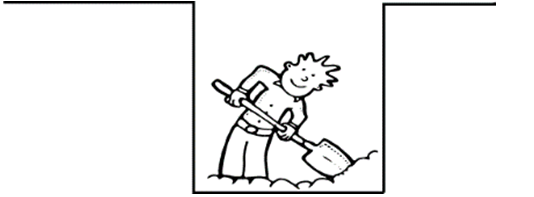
No todas las tareas son igualmente susceptibles de paralelización. Una sola persona debe perforar un pozo profundo, así que añadir más trabajadores a ese pozo no acelera el trabajo; de hecho, puede entorpecer el progreso. Por el contrario, excavar una zanja es altamente paralela: varios trabajadores pueden cavar lado a lado, cada uno cubriendo una fracción del esfuerzo total.
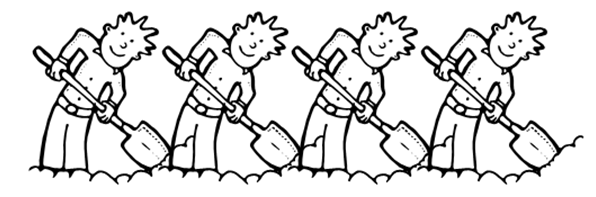
Esa ilustración representa MIMD (Multiple Instruction, Multiple Data), donde cada trabajador (núcleo) puede realizar operaciones distintas. Con cuatro trabajadores independientes, una tarea que tomaría a un núcleo un minuto completo podría terminarse en unos 15 segundos.
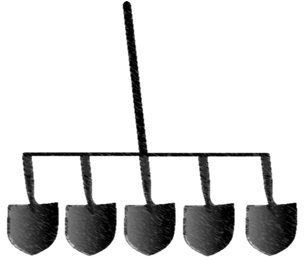
En contraste, SIMD (Single Instruction, Multiple Data) ejecuta la misma instrucción sobre muchos elementos de datos simultáneamente. SIMD es ideal para cargas de trabajo con operaciones regulares y repetidas —como filtrado de imagen o matemáticas vectoriales— pero carece de flexibilidad para computación de propósito general.
Estas consideraciones sustentan el auge de procesadores multicore: al embeber múltiples subsistemas CPU completos en un solo die, los diseñadores pueden escalar rendimiento linealmente, siempre que el software esté escrito para explotar el paralelismo.
Diferentes tipos de procesamiento multicore
Los procesadores pueden combinar núcleos de diversas formas, afectando cómo se distribuyen las cargas de trabajo y cómo se comunican los núcleos.
Multicore homogéneo
Dos o más núcleos idénticos, cada uno con sus propios registros, unidades funcionales y a menudo cachés L1 privadas. La comunicación entre núcleos típicamente ocurre a través de memoria compartida o mecanismos de buzón. Como cada núcleo es del mismo tipo, el mismo binario puede ejecutarse en cualquiera de ellos.
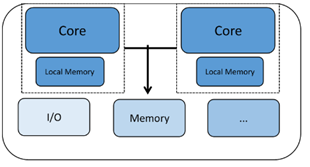
Multicore heterogéneo
Mezcla de diferentes tipos de núcleos, cada uno optimizado para una carga de trabajo particular. Por ejemplo, un controlador Bluetooth podría dedicar un núcleo a manejo de protocolo mientras un segundo gestiona lógica de aplicación de alto nivel. Esta arquitectura es común en SoCs móviles y controladores industriales.
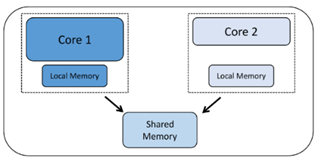
Los patrones de distribución de núcleos distinguen aún más diseños multicore:
Procesamiento multiprocesador simétrico (SMP)
Múltiples núcleos idénticos ejecutan el mismo binario, coordinados por un sistema operativo en tiempo real (RTOS). El planificador distribuye trabajo entre núcleos, y el binario se compila para un solo tipo de núcleo.
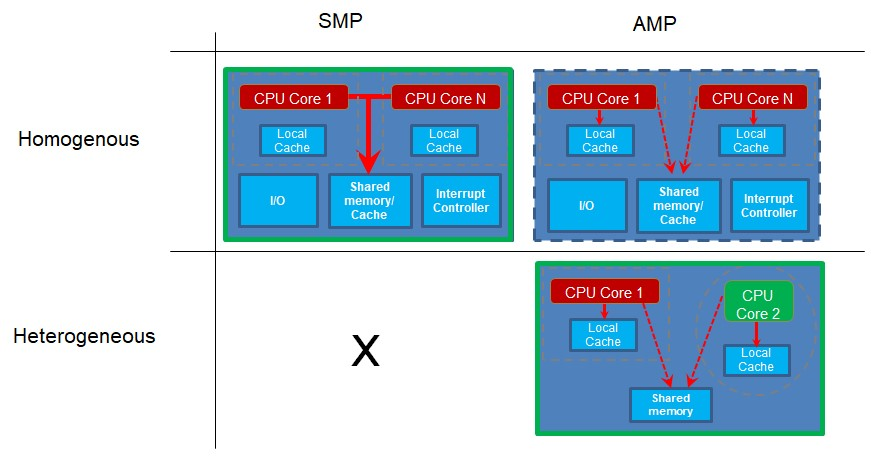
Procesamiento multiprocesador asimétrico (AMP)
Cada núcleo ejecuta su propio binario dedicado. Los núcleos pueden ser homogéneos o heterogéneos. La comunicación es opcional y típicamente gestionada vía memoria compartida o primitivas de mensajería.
Como SMP requiere un solo binario, exige núcleos homogéneos. AMP puede implementarse en sistemas homogéneos o heterogéneos, lo que lo hace ideal para aplicaciones que necesitan cargas de trabajo distintas y especializadas.
Razones para usar multicore
A medida que la ley de Moore se ralentiza, la vía más efectiva a mayor rendimiento es empaquetar más núcleos en un die. Mientras las velocidades de reloj se han estancado en el rango bajo de GHz de un dígito, las densidades de transistores siguen subiendo, permitiendo interconexiones más ricas y cachés on-chip mayores. Los diseños multicore desbloquean todo el potencial de esta densificación.
AMP heterogéneo es especialmente poderoso para cargas de trabajo real-time y centradas en throughput. Al aislar funciones críticas de tiempo en un núcleo dedicado, los diseñadores pueden cumplir garantías estrictas de latencia sin comprometer el throughput general del sistema. Esta separación también simplifica la certificación, porque el componente real-time puede verificarse independientemente de la lógica de aplicación.
Desafíos del uso multicore
Adoptar una arquitectura multicore introduce numerosos retos de software y sistema:
- Granularidad de tarea – Una aplicación monolítica a menudo no puede usar múltiples núcleos eficientemente. Desarrolladores deben refactorizar código en tareas independientes que puedan ejecutarse concurrentemente. Un mal diseño de hilos puede llevar a subutilización o contención.
- Cuellos de botella de sincronización – Estructuras de datos compartidas y dispositivos I/O requieren bloqueos (mutexes, spinlocks, read-write locks, etc.). Bloqueos excesivamente agresivos o alta contención pueden serializar trabajo y anular ganancias paralelas.
- Desequilibrio de carga – Si un núcleo termina su trabajo pronto mientras otros rezagan, el núcleo inactivo representa ciclos de cómputo desperdiciados. Dividir grandes trabajos en trozos más pequeños y均等尺寸 es esencial.
- Restricciones real-time – En sistemas SMP, el planificador RTOS debe equilibrar latencia y throughput. Elegir entre partición de datos (cada hilo procesa un bloque de datos) y partición de función (cada hilo realiza una etapa distinta de un pipeline) depende del perfil de carga de trabajo.
Depuración en entornos multicore
La depuración efectiva depende de visibilidad completa de todos los núcleos:
- Control coordinado – El depurador debe permitir parada, paso a paso y establecimiento de breakpoints simultáneos o independientes entre núcleos.
- Traza multicore – Capturar datos de traza de varios núcleos simultáneamente exige transporte de alto ancho de banda (p.ej., puertos SWD y TPIU de CoreSight) y filtrado inteligente para evitar sobrecarga de datos.
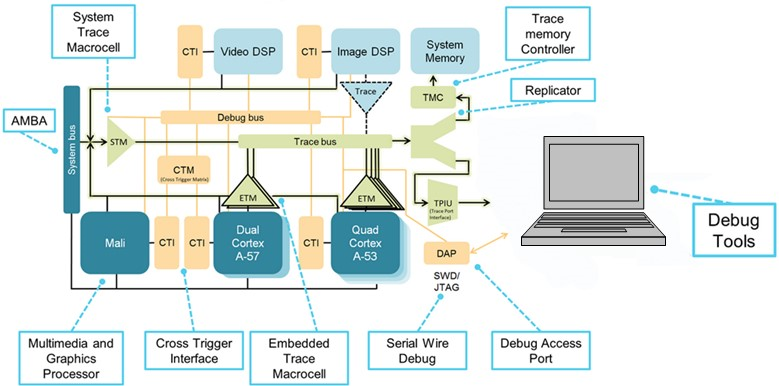
(Fuente: IAR Systems, diagrama cortesía de Arm Ltd.)
La arquitectura de depuración CoreSight de Arm integra interfaces de disparo cruzado (CTI) y matriz de disparo cruzado (CTM), permitiendo al depurador parar o disparar acciones en cualquier núcleo en respuesta a eventos de otro núcleo. Esta capacidad es esencial para diagnosticar race conditions y deadlocks.
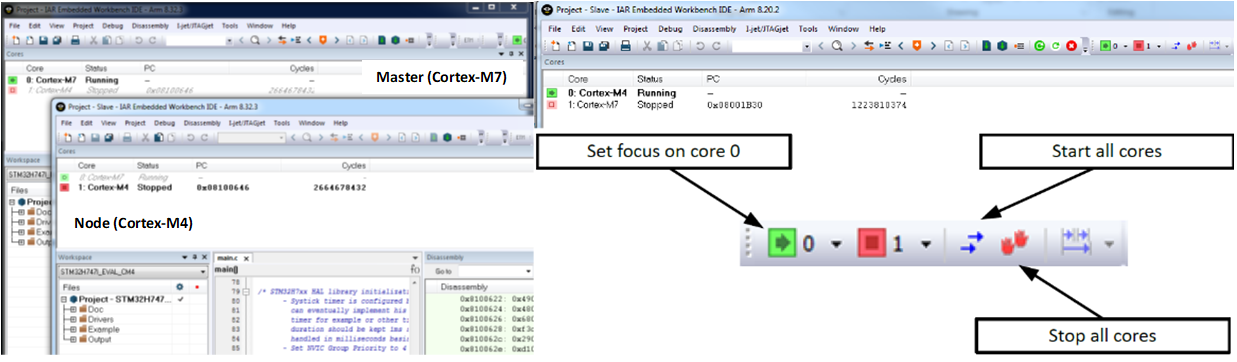
El depurador C‑SPY de IAR Embedded Workbench soporta configuraciones SMP y AMP. Para SMP, el usuario especifica el conteo de núcleos y el depurador conecta automáticamente a cada uno. El soporte AMP requiere dos instancias de IDE (Master y Node) cuando los núcleos ejecutan binarios separados.
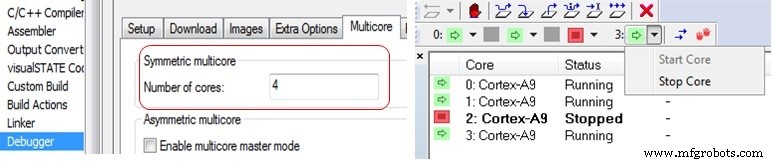
En la vista derecha, se muestra un clúster SMP Cortex‑A9 de 4 núcleos: el núcleo 2 está detenido mientras los otros continúan ejecutando.
Para sistemas heterogéneos como ST STM32H745/755 (Cortex‑M7 + Cortex‑M4), el depurador lanza ventanas IDE separadas para cada núcleo. Cada ventana muestra el estado de su núcleo y, opcionalmente, el del otro, permitiendo a desarrolladores observar interacciones inter-núcleo en tiempo real.
Dos CTIs (nivel sistema, Cortex‑M4, y Cortex‑M7) están conectados por un CTM, dando al depurador control fino sobre breakpoints y disparadores de traza.
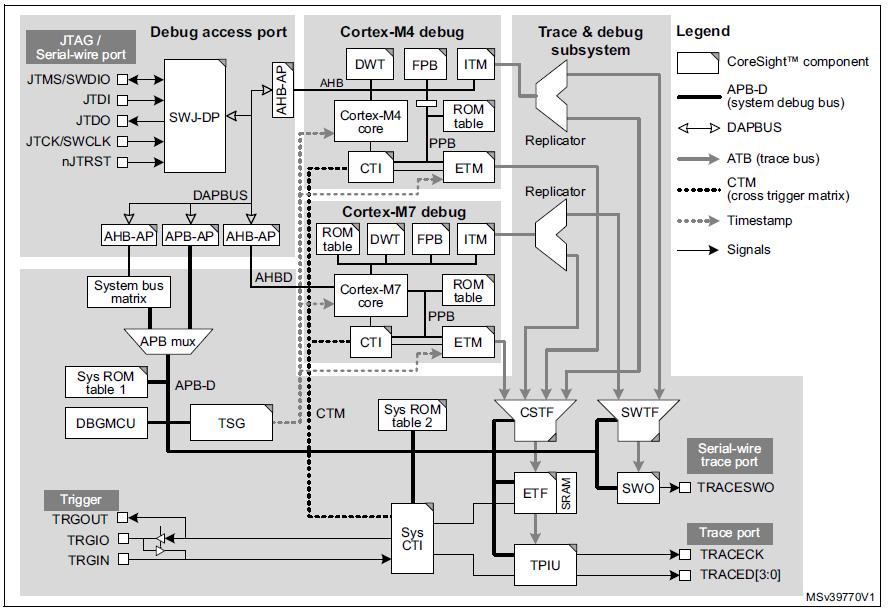
(Fuente: IAR Systems, diagrama cortesía de STMicroelectronics del manual de referencia M0399)
Aplicaciones típicas usan interfaz de memoria compartida y RTOS ligero (p.ej., FreeRTOS) para intercambiar mensajes entre núcleos. Desde la perspectiva de cada núcleo, la comunicación aparece como mensajería de tareas simple, abstraiendo la mecánica subyacente inter-núcleo.
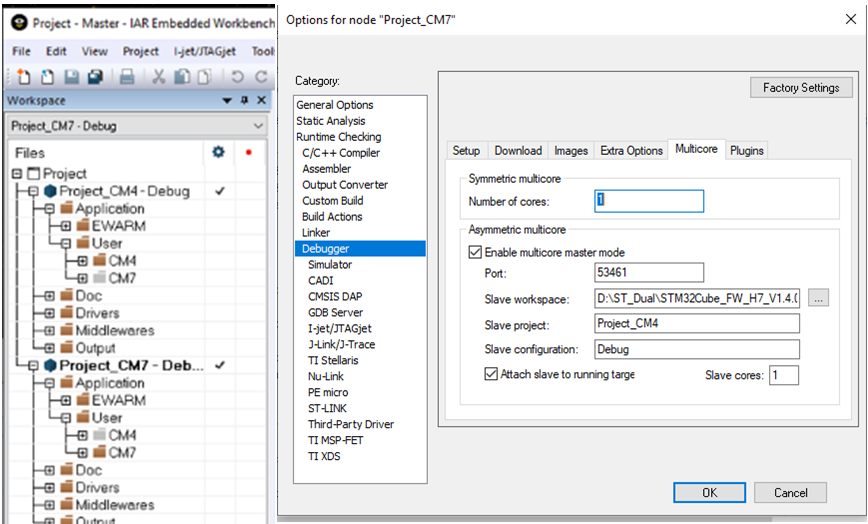
En el explorador de espacio de trabajo, los dos proyectos (Cortex‑M7 y Cortex‑M4) son visibles, y el usuario puede cambiar foco entre ellos. El proyecto master lanza automáticamente la segunda instancia IDE, simplificando depuración AMP.
Resumen
Las arquitecturas multicore entregan el rendimiento necesario mientras la ley de Moore se ralentiza, pero exigen diseño de software disciplinado y herramientas de depuración sofisticadas. Una vez configurado el entorno de depuración, los desarrolladores encuentran que la depuración multicore es sorprendentemente sencilla, especialmente comparada con los retos reportados por quienes solo han trabajado con sistemas mono-core.
El hardware moderno y las herramientas de software integradas ahora hacen práctico aprovechar el rendimiento multicore manteniendo fiabilidad y trazabilidad.
Nota: Las imágenes de figuras son de IAR Systems salvo indicación contraria.
 Aaron Bauch es Senior Field Application Engineer en IAR Systems trabajando con clientes en Este de EE. UU. y Canadá. Aaron ha trabajado con sistemas embebidos y software para empresas incluyendo Intel, Analog Devices y Digital Equipment Corporation. Sus diseños cubren amplio rango de aplicaciones incluyendo instrumentación médica, navegación y sistemas bancarios. Aaron también ha impartido cursos universitarios incluyendo Diseño de Sistemas Embebidos como profesor en Southern NH University. Mr. Bauch tiene Bachelor en Ingeniería Eléctrica de The Cooper Union y Masters en Ingeniería Eléctrica de Columbia University, ambos en New York, NY.
Contenidos Relacionados:
- Garantizando comportamiento de timing de software en sistemas embebidos multicore críticos
- Sistemas multicore, hypervisors y frameworks multicore
- Computación embebida de alto rendimiento – Paralelismo y optimización de compilador
- ¿Crees que tu software funciona? ¡Demuéstralo!
- Trazado de software en dispositivos desplegados en campo
- Compiladores en el mundo alien de seguridad funcional
Para más Embedded, suscríbete al boletín semanal de Embedded.
Incrustado
- Placas Breakout Esenciales para Raspberry Pi: I2C, UART, GPIO y Más – Kits, Headers y Protección
- Automatización Experta de Planta: Diseño, Implementación y Soluciones Llave en Mano
- Navegando los riesgos multifacéticos en aeroespacial y defensa
- 5G e IoT: Impulsando la resiliencia de la cadena de suministro de próxima generación
- Dominando el Torneado en Duro: Superando Desafíos con Herramientas Avanzadas
- Cuatro Desafíos Clave que Moldean la Industria OEM Aeroespacial y de Defensa
- Por qué la documentación actualizada es crítica: Beneficios y desafíos para su negocio
- Manufactura híbrida: beneficios clave, desafíos e impacto industrial
- Dominando monitoreo SaaS y WiFi: Cómo equipos TI superan desafíos cloud
- Los 5 Principales Retos del 5G: Navegar Espectro, Coste, Cobertura, Dispositivos y Seguridad
- Superando Desafíos ETL de Datos IoT para Impulsar ROI