



Acelerando el co-diseño CPU-FPGA: Un flujo práctico para desarrolladores de software
Recientemente, Brian Bailey convocó una mesa redonda que culminó en el artículo en dos partes Supporting CPUs + FPGAs. Expertos debatieron la realidad emergente de sistemas que fusionan FPGAs con CPUs, destacando cómo nuevos flujos de diseño permiten a desarrolladores de software llevar plataformas CPU+FPGA al mercado más rápido.
Introducción
El auge de la inteligencia artificial, la explosión de dispositivos conectados y la aceleración de cargas de trabajo en centros de datos apuntan a un motor común: desarrolladores de software que buscan velocidad. Enlaces de baja latencia entre FPGAs y CPUs, junto con los modestos envolventes de potencia de los FPGAs modernos, hacen de los sistemas híbridos CPU-FPGA una opción natural para alto rendimiento. Sin embargo, la complejidad subyacente de la tecnología FPGA a menudo frena a los desarrolladores.
Las herramientas de Síntesis de Alto Nivel (HLS) han avanzado significativamente, facilitando la traducción de C/C++ a hardware. Aún así, son principalmente centradas en IP y fallan en decisiones a nivel de sistema —equilibrar tareas software vs hardware, elegir entre ejecución en pipeline o paralela, ajustar granularidad de datos, o seleccionar mecanismos óptimos de comunicación.
Lo que necesitan los ingenieros de software es un flujo de diseño unificado que se sienta como un IDE de software estándar pero que proporcione retroalimentación consciente del hardware. Soluciones comerciales recientes han comenzado a cerrar esta brecha abstraiendo detalles de bajo nivel mientras retienen el control que demandan los desarrolladores. Estas herramientas se basan en la filosofía de Diseño a Nivel de Sistema descrita en ESL Models and Their Application.
Entendiendo el Flujo de Diseño a Nivel de Sistema
El Diseño a Nivel de Sistema opera a mayor abstracción, validando, refinando e integrando componentes del sistema antes de la implementación. La mayoría de los diseñadores comienzan en el nivel algorítmico, escribiendo modelos en C/C++/SystemC, MATLAB, Simulink o LabVIEW que capturan el comportamiento completo del sistema.
Nos centramos en un flujo centrado en C/C++ (ver Figura 1). La primera etapa —perfilado de la aplicación— identifica qué funciones o bucles podrían beneficiarse de aceleración por hardware. A continuación, se especifica la plataforma CPU/FPGA objetivo (p. ej., ARM Cortex-A53 + FPGA) y se configuran sus parámetros (reloj, caché, interconexiones). Finalmente, las tareas perfiladas se asignan entre software y hardware, culminando en una arquitectura ejecutable.
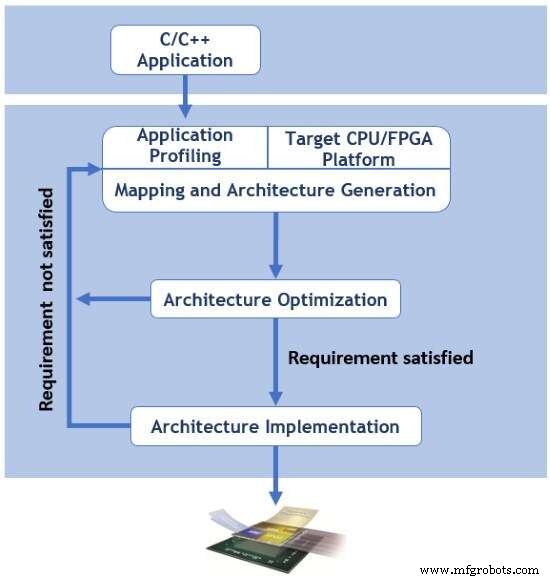
Figura 1. Flujo típico de diseño a nivel de sistema para CPU/FPGA (Fuente: Space Codesign Systems, Inc.)
El segundo bloque de la Figura 1 cubre la optimización de arquitectura —a veces llamada exploración arquitectónica o verificación de rendimiento— mostrada con más detalle en la Figura 2.
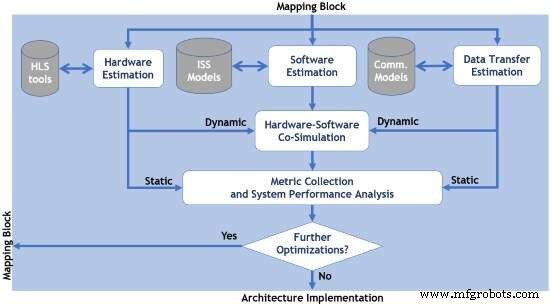
Figura 2. Proceso de optimización de arquitectura (Fuente: Space Codesign Systems, Inc.)
Tres estimadores clave alimentan esta etapa:
- Estimación de hardware evalúa el impacto de mover código C/C++ al FPGA, desglosando uso de recursos, latencia de bucles y potencia. Se basa en salidas de HLS.
- Estimación de software mide métricas del lado CPU —carga del procesador, cambio de tareas, fallos de caché— complementando la vista de hardware.
- Estimación de transferencia de datos modela interfaces (mapeadas en memoria o streaming), capturando latencia de bus, rendimiento, profundidad de cola y huella de memoria.
Los resultados agregados poblan una base de datos, permitiendo a los desarrolladores verificar si se cumplen los objetivos a nivel de sistema. Arquitecturas que satisfacen los criterios avanzan; de lo contrario, se desencadenan más iteraciones de optimización.
El bloque final de la Figura 1 concierne a la implementación de la arquitectura: diseños de alto nivel se traducen en bitstreams FPGA usando herramientas del proveedor como Xilinx Vivado o Intel Quartus Prime, produciendo un sistema totalmente sintetizado y probado listo para despliegue.
Optimización a Nivel de Sistema
La ausencia de herramientas automatizadas de optimización de extremo a extremo ha sido durante mucho tiempo un cuello de botella en la computación basada en FPGA. La complejidad de equilibrar múltiples dimensiones de diseño hace que la exploración manual sea tediosa, incluso para diseñadores experimentados.
La Figura 3 ilustra un flujo de optimización típico para una aplicación de procesamiento de imagen que comprende seis funciones C/C++ desplegadas en una plataforma Zynq-7000. Se consideran ocho arquitecturas candidatas, pero las restricciones de time-to-market exigen una selección rápida del mejor compromiso entre rendimiento, área y potencia.
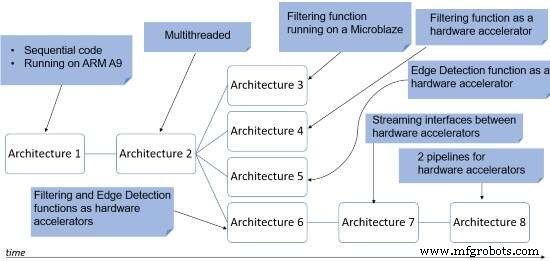
Figura 3. Exploración de arquitectura con decisiones a nivel de sistema destacadas (Fuente: Space Codesign Systems, Inc.)
Soluciones comerciales como Xilinx SDSoC/SDAccel, Merlin Compiler de Falcon Computing y SpaceStudio de Space Codesign ahora proporcionan soporte de extremo a extremo. Reflejan el flujo de las Figuras 1 y 2 mientras inyectan lógica de decisión automatizada:
- SDSoC estima latencias para kernels de hardware y caracteriza la transferencia de datos en la plataforma objetivo, luego compara con una ejecución puramente de software.
- Merlin Compiler aplica transformaciones source-to-source impulsadas por cuatro pragmas, más pasadas implícitas del compilador que mejoran pipeline y paralelismo.
- SpaceStudio construye una plataforma virtual (VP) que simula el sistema completo, integrando latencias generadas por hardware y ofreciendo perfilado no intrusivo de tareas tanto de software como de hardware.
Visión del Ecosistema Comercial
La Figura 4 presenta una vista en capas del ecosistema alrededor del diseño de plataformas CPU/FPGA. La capa superior muestra puntos de entrada algorítmicos; la capa media alberga herramientas que soportan optimizaciones a nivel de sistema desde C/C++; la capa inferior contiene herramientas de síntesis del proveedor que producen bitstreams. Plataformas CPU/FPGA representativas se ilustran en la base.
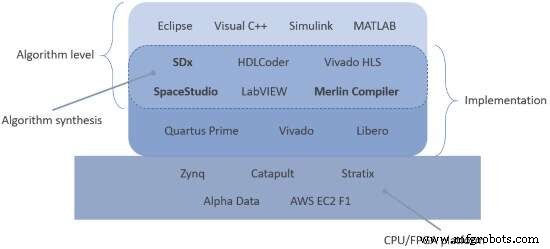
Figura 4. Ecosistema comercial para plataformas CPU/FPGA (Fuente: Space Codesign Systems, Inc.)
La Tabla 1 lista herramientas clave de automatización comercial empleadas en el diseño de plataformas CPU/FPGA.
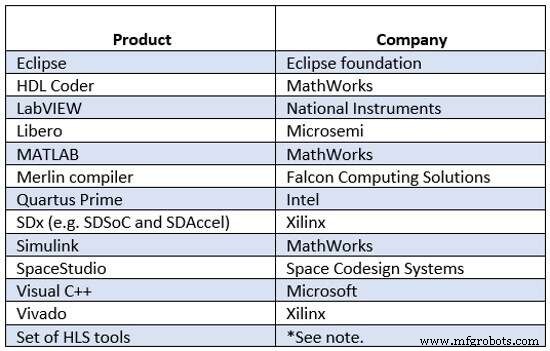
Tabla 1. Herramientas de automatización comercial (*Nota: Se propone una lista en esta revisión)
Conclusión
Democratizar el desarrollo CPU+FPGA es el objetivo final, permitiendo a una gama más amplia de desarrolladores de software aprovechar la aceleración por hardware. Al igual que la industria del software evolucionó de ensamblador a Python y Swift en cinco décadas, la programación FPGA está experimentando una maduración similar. El auge de herramientas a nivel de sistema como SpaceStudio, SDSoC y Merlin Compiler señala un cambio crucial —aunque la automatización total y la optimización fluida entre compiladores siguen hitos futuros.
Guy Bois, Ing., PhD es Fundador de Space Codesign Systems y Profesor en el Departamento de Ingeniería de Software y Computación en Polytechnique Montréal. Con amplia experiencia en I+D junto a líderes de la industria —STMicroelectronics, Grass Valley, PMC Sierra, Design Workshops Technologies y Cadabra Systems— la experiencia de Guy en co-diseño hardware/software llevó a la comercialización de SpaceStudio y la fundación de Space Codesign Systems Inc.
Incrustado
- Thomas Reiher, CEO de AMendate, sobre revolucionar la impresión 3D con optimización topológica automatizada
- Ravi Kunju de Altair habla sobre diseño guiado por simulación y el nuevo Inspire Print3D para impresión 3D
- Mejora tus plataformas de robots low‑cost con nuevo hardware de 7º eje y software gratuito de gemelo digital
- Omron presenta Flow Core: software avanzado que mejora fiabilidad y flexibilidad de robots móviles
- Navegando el nuevo panorama manufacturero: Estrategias para el éxito
- Iniciativa VE-VIDES presenta marco de diseño y verificación confiable para seguridad IoT
- Cadence lanza herramienta Cerebrus impulsada por ML para aumentar productividad de diseño de chips 10x y PPA 20%
- Acelerador FPGA de alto rendimiento para visión integrada con cámaras MIPI
- Cadence y UMC certifican flujo de diseño AMS 28HPC+ para desarrollo acelerado de chips automotriz, IoT e IA
- 5 preguntas reveladoras a Stefan Ferber, CEO de Bosch.IO
- Infineon y Elektrobit Entregan Seguridad de Nueva Generación para Coches Conectados