



Microcontroladores impulsando la próxima ola de Edge AI
Hasta hace poco, el machine learning —e incluso deep learning— se consideraba privilegio de servidores potentes, con entrenamiento e inferencia manejados por gateways, edge servers o data centers. Esa visión se mantenía porque el cambio hacia distribuir computación entre cloud y edge aún era incipiente. Hoy, avances de industria y academia han cambiado ese paradigma.
Consecuentemente, procesadores de alto rendimiento entregando trillones de operaciones por segundo (TOPS) ya no son prerrequisito para cargas de trabajo ML. Microcontroladores modernos, muchos equipados con aceleradores ML dedicados, ahora llevan inferencia inteligente directamente a dispositivos edge.
Estos controladores ejecutan tareas ML eficientemente, a coste y potencia mínimos, conectando a la cloud solo cuando se necesita. En esencia, microcontroladores con aceleradores ML embebidos marcan el próximo salto en dotar a sensores —micrófonos, cámaras, monitores ambientales— con inteligencia on‑device, la piedra angular de la cadena de valor IoT.
¿Qué tan profundo es el edge?
El edge se define comúnmente como el punto más lejano de la cloud en una red IoT, a menudo representado por un gateway avanzado o edge server. En realidad, el edge termina en los propios sensores —aquellos posicionados cerca del usuario final. Es por tanto lógico embeber tanta analítica como sea posible directamente dentro de esos sensores, un rol para el que los microcontroladores están perfectamente adaptados.
Single‑board computers pueden de hecho realizar edge processing, entregando rendimiento impresionante y, cuando se agrupan, aproximándose a supercomputadoras de pequeña escala. Yet permanecen demasiado voluminosos y caros para las miles de unidades demandadas por despliegues a gran escala. Además, requieren potencia DC externa —a menudo no disponible en entornos constrainidos— mientras un MCU consume solo milivatios y puede operar en baterías de moneda o unas pocas celdas solares.
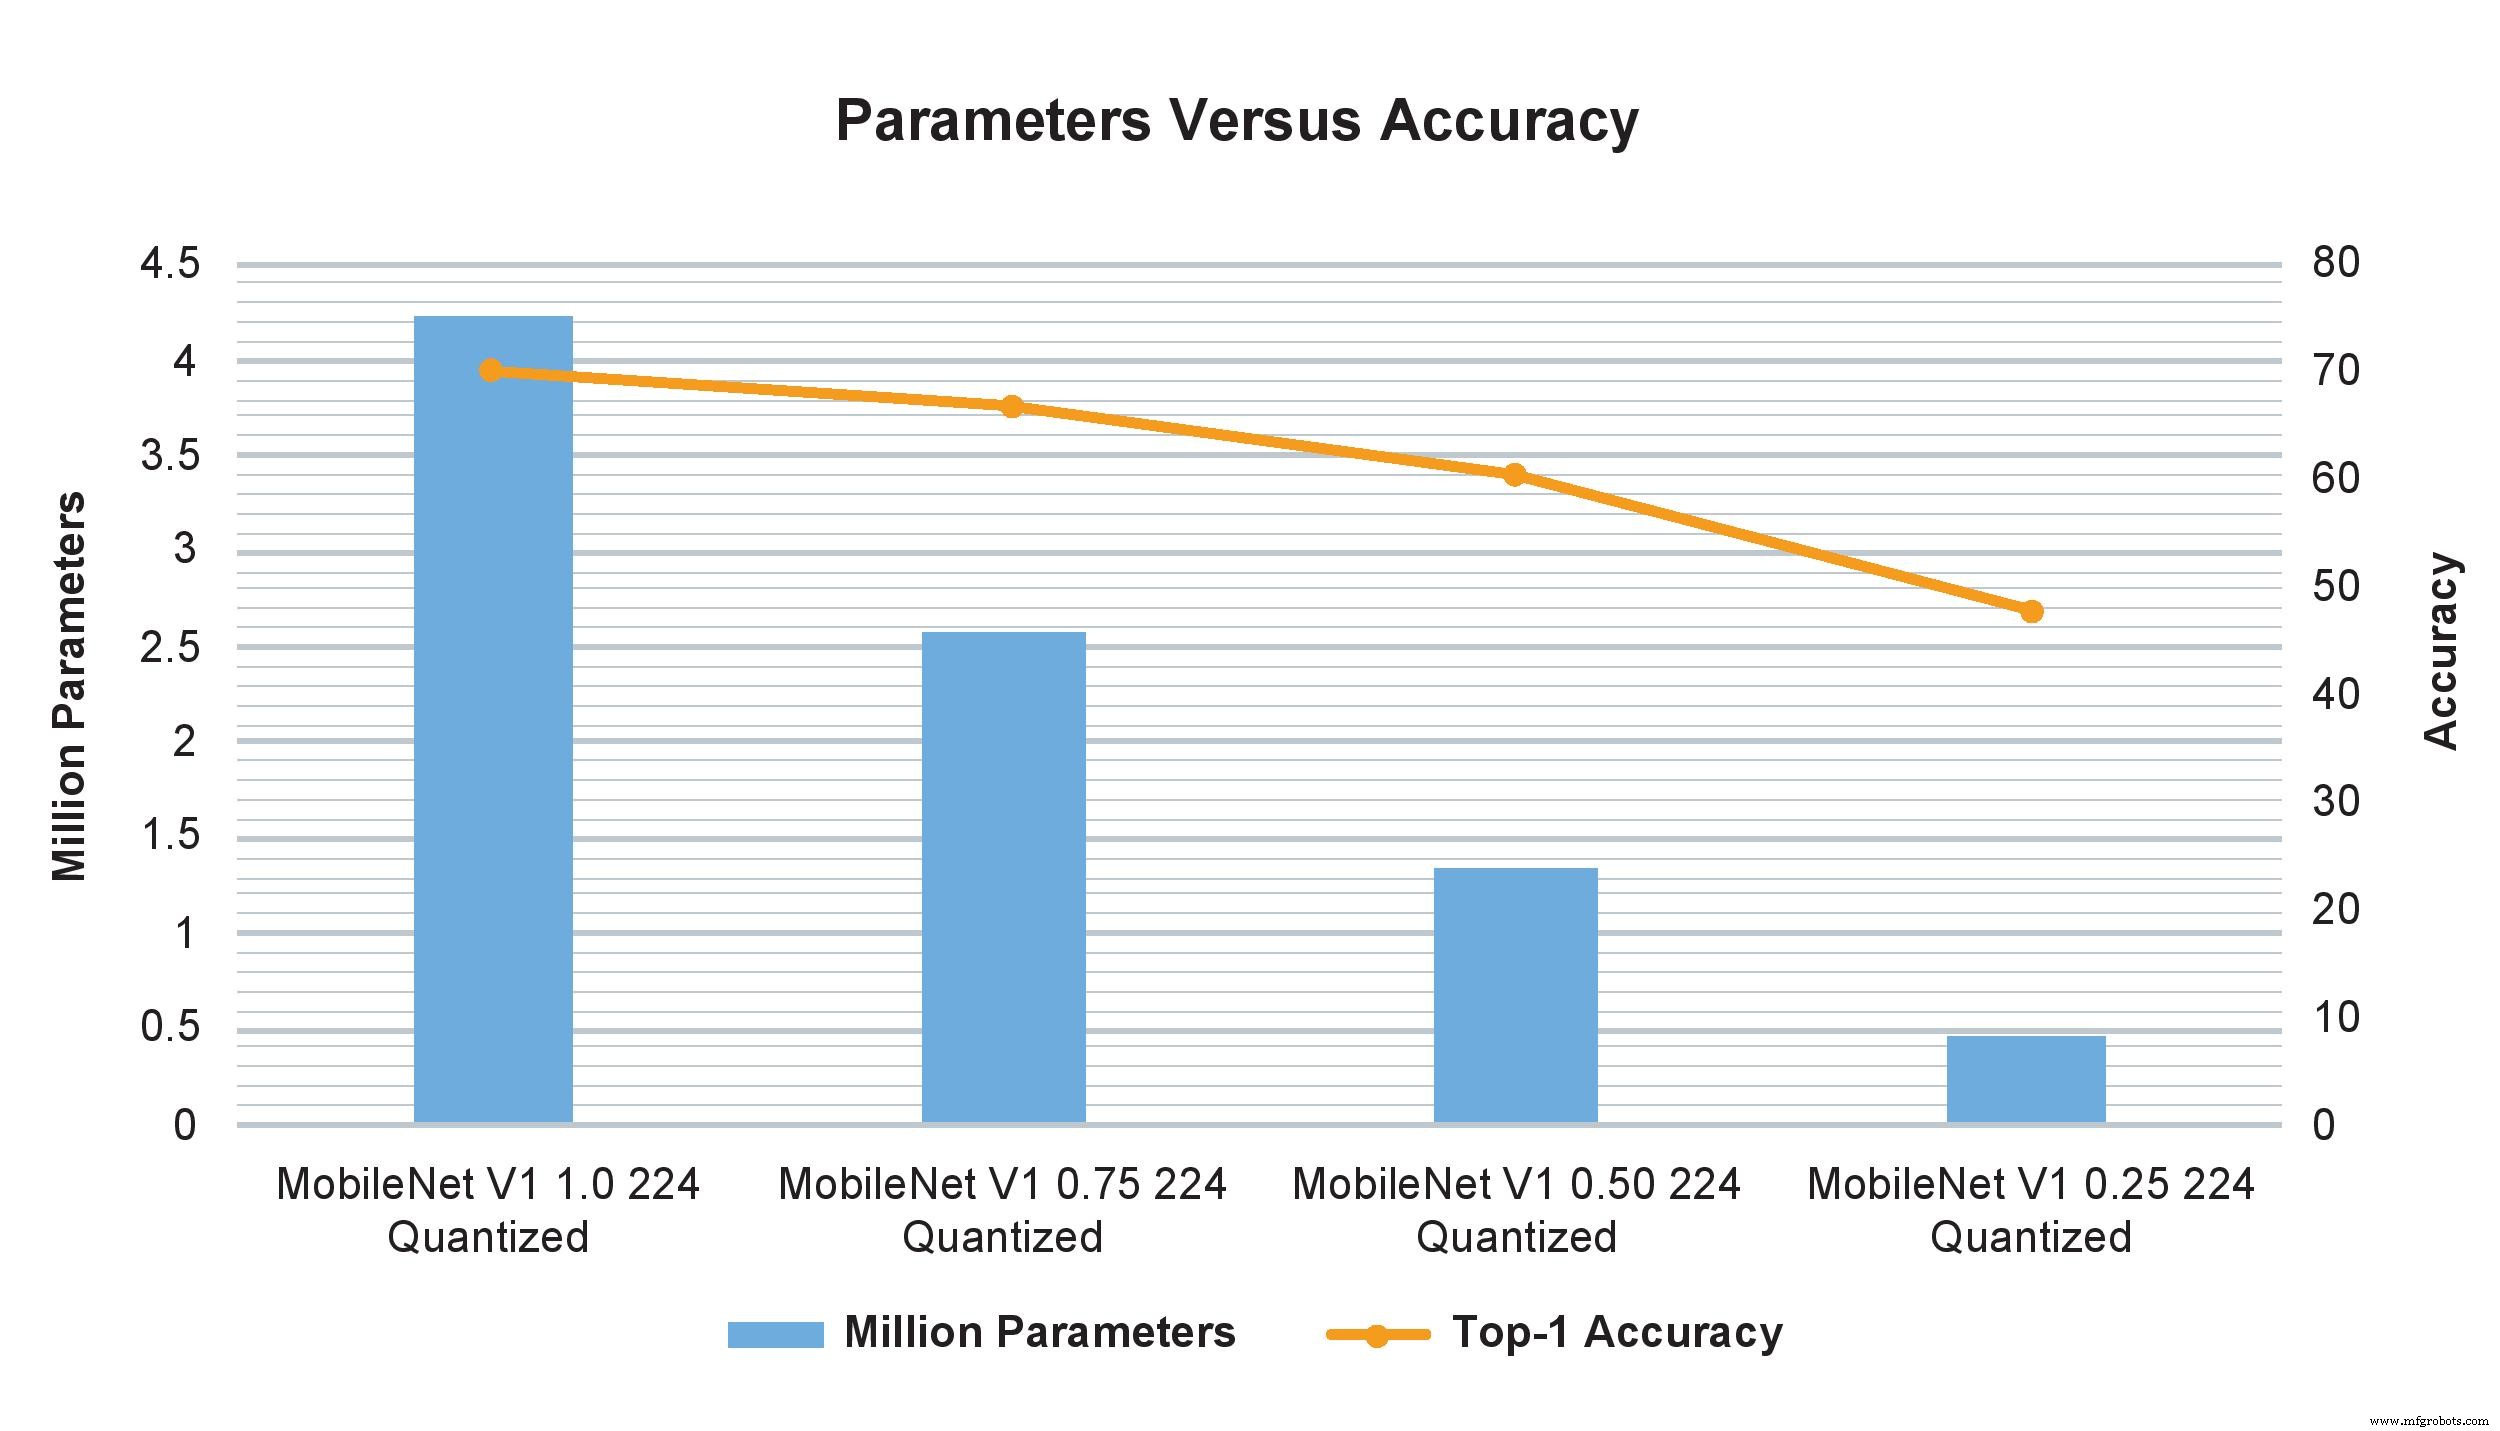
Consecuentemente, el campo de ML basado en microcontroladores —conocido como TinyML— ha explotado en popularidad. TinyML apunta a habilitar inferencia, y eventualmente entrenamiento, en dispositivos pequeños, low‑power, resource‑constrained, particularmente microcontroladores, en lugar de depender en plataformas mayores o la cloud. Esto necesita modelos de red neuronal compactos que quepan dentro de presupuestos limitados de procesamiento, almacenamiento y ancho de banda mientras preservan rendimiento.
Modelos resource‑optimized habilitan dispositivos a capturar datos de sensor adecuados para sus tareas mientras fine‑tunean precisión y reducen demandas de recursos. Consecuentemente, aunque algunos datos aún pueden transmitirse —directamente a la cloud o vía edge gateway— el volumen es significativamente menor porque análisis preliminar ya se ha ejecutado en el dispositivo.
Un caso de uso común TinyML es un sistema de detección de objetos basado en cámara que puede capturar imágenes de alta resolución yet enfrenta almacenamiento limitado, necesitando reducción de resolución. Con analíticas on‑device, la cámara captura solo los objetos de interés, preservando mayor resolución para los frames seleccionados. Este nivel de funcionalidad —una vez reservado para hardware potente— es ahora alcanzable en microcontroladores gracias a TinyML.
Pequeños pero poderosos
Aunque TinyML es un campo naciente, ya entrega inferencia impresionante —y cada vez más, entrenamiento— rendimiento en microcontroladores modestos, con pérdida de precisión negligible. Éxitos recientes abarcan reconocimiento de voz y facial, procesamiento de lenguaje natural voice‑command y ejecución simultánea de múltiples algoritmos de visión sofisticados.
Prácticamente, un microcontrolador bajo $2, con núcleo Arm Cortex‑M7 500‑MHz y 28 KB–128 KB de memoria, puede entregar el rendimiento necesario para render sensores verdaderamente inteligentes.
Incluso a este coste, tales microcontroladores incorporan features de seguridad robustas (AES‑128), soportan múltiples tipos de memoria externa, Ethernet, USB, SPI e interfaces para una gama de sensores, incluyendo Bluetooth, Wi‑Fi, SPDIF e I²C audio. Un aumento de precio modesto típicamente rinde un Cortex‑M7 1‑GHz, Cortex‑M4 400‑MHz, 2 MB de RAM y aceleración gráfica, todo mientras consumen solo unos pocos miliamperios de un suministro 3.3 V.
Algunas palabras sobre TOPS
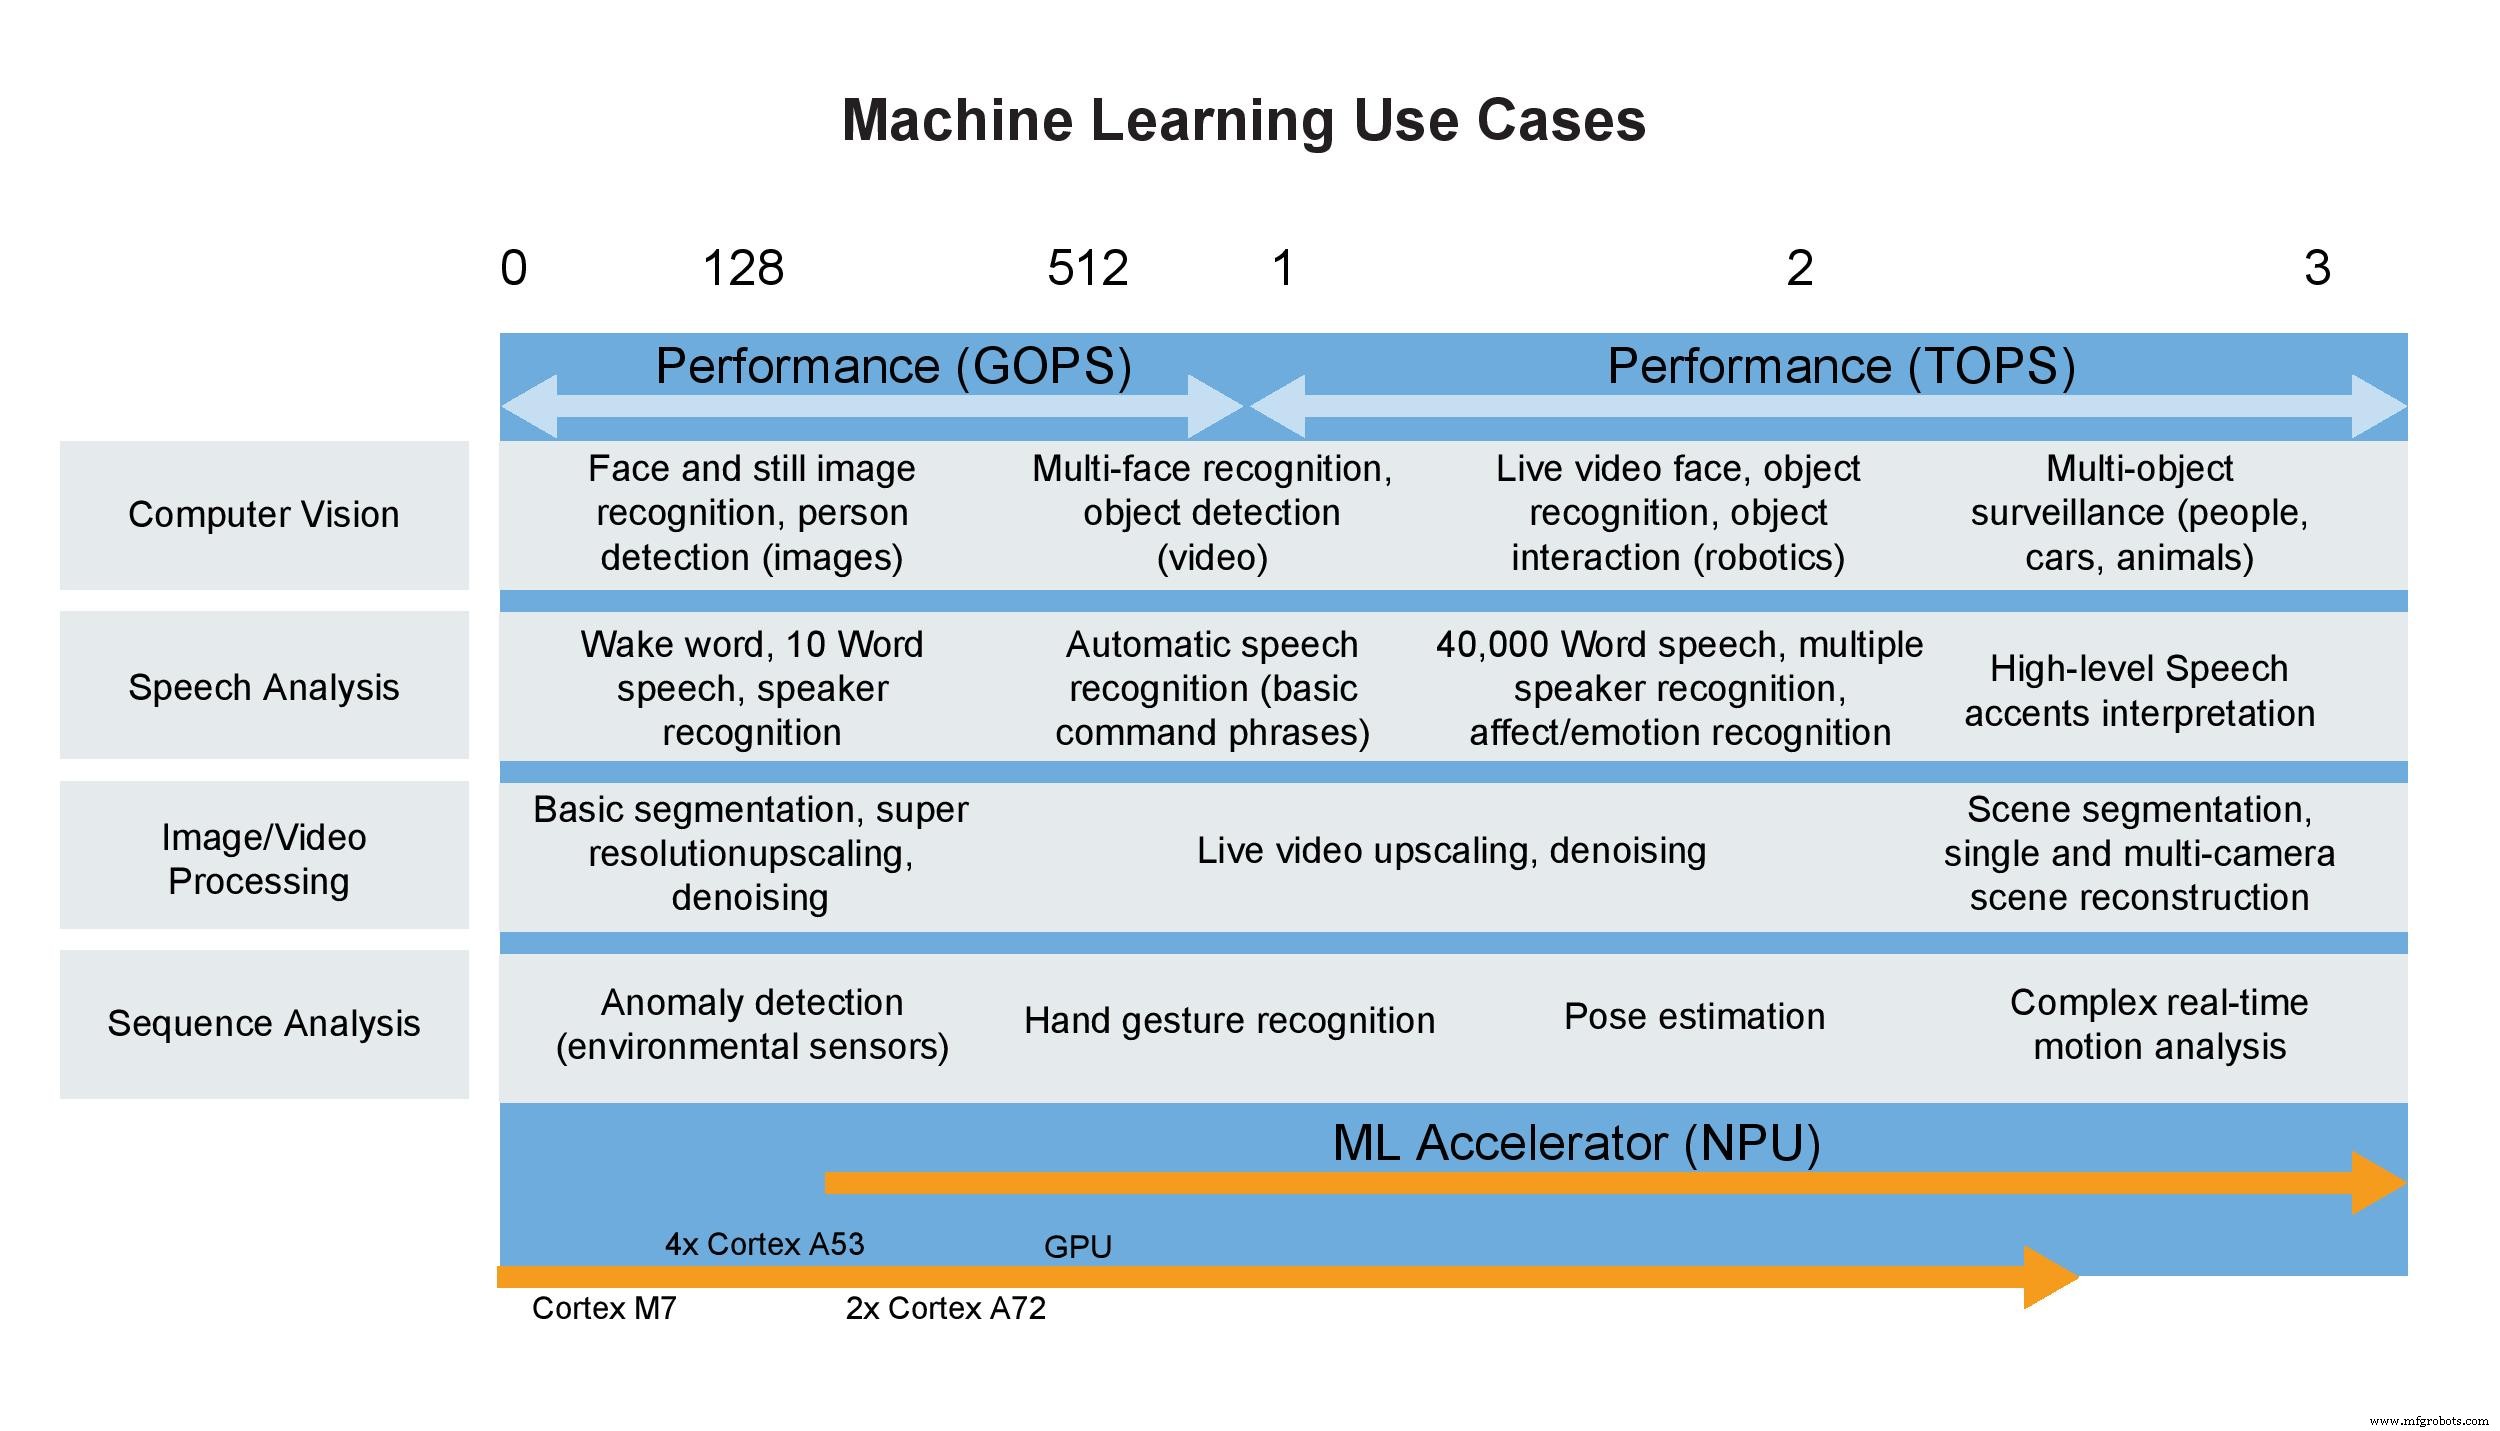
Fabricantes a menudo benchmark aceleradores de red neuronal usando una métrica única —trillones de operaciones por segundo (TOPS). Aunque atractiva, esta cifra puede ser engañosa. Refleja capacidad computacional raw en setting de lab controlado e ignora constraints prácticos como ancho de banda de memoria, overhead CPU y pre‑ y post‑procesamiento de datos. En despliegues reales, el throughput alcanzable puede ser 50–60% del valor TOPS anunciado.
Además, para microcontroladores, que típicamente ofrecen solo 1–3 TOPS, la métrica es incluso menos informativa. El poder real de estos dispositivos diminutos reside en sus procesadores Arm Cortex estrechamente integrados, soporte para operaciones entero y punto flotante, y la habilidad de correr motores de inferencia como TensorFlow Lite con huella mínima.
Conclusión
El empuje para correr inferencia directamente en o adyacente a sensores —sean cámaras still o video— se está acelerando conforme el ecosistema IoT se mueve hacia procesamiento edge‑centric. Avances rápidos en aceleradores de red neuronal a nivel microcontrolador están consolidando funcionalidad IA con procesadores de aplicación sin subida dramática en consumo de potencia o tamaño. Modelos entrenados en CPUs o GPUs potentes pueden adelgazarse con TensorFlow Lite y desplegarse a microcontroladores, escalando sin esfuerzo para cumplir demandas ML crecientes. Pronto, incluso entrenamiento será factible en estos dispositivos, posicionando microcontroladores como competidores formidables a sistemas mayores y más costosos.
>> Este artículo fue publicado originalmente en nuestro sitio hermano, EE Times.
Incrustado
- Robots impulsan futuro Industria 4.0 en NPE
- Cómo los Sistemas Embebidos Impulsan la Innovación en Vehículos Modernos
- Enfriamiento por Cámara de Vapor: Solución Creciente para Electrónica de Alto Calor
- El creciente papel del USB‑C en gestión de potencia para wearables y dispositivos móviles
- Murata y Google presentan el módulo Edge TPU IA más pequeño: 4 TOPS en chip de 10×15×1,5 mm
- ECM3532: Primera placa sensor IA integrada ultra-bajo consumo de Eta Compute acelera desarrollo edge
- ADLINK lanza NEON‑1000‑MDX: Cámara inteligente Edge AI llave en mano para despliegue rápido visión industrial
- Cómo Cloud Computing impulsa la innovación en IA y la eficiencia empresarial
- Definiendo el Edge: Dónde ocurre realmente el Edge Computing
- La recolección de energía RF impulsa la expansión de aplicaciones inalámbricas potenciadas por IA
- Cómo el Edge Computing Revoluciona los Despliegues Comerciales de IoT