



Entendiendo las Caídas en la Nube: Causas, Impacto y Prevención
Cuanto más depende la TI de servicios cloud, más probable es que sufras tiempo de inactividad y pérdidas de ingresos debido a una caída en la nube. Más del 60% de las organizaciones que usan la nube pública reportan pérdidas en 2022 debido a estos incidentes, así que las caídas no son una ocurrencia extraña que las empresas probablemente no enfrentarán.
Pero, ¿son las caídas suficiente razón para abandonar la nube para siempre? ¿O deberías quedarte con este tipo de infraestructura a pesar del riesgo de tiempo de inactividad ocasional?
Este artículo repasa todo lo que necesitas saber sobre las caídas en la nube. Describimos sus causas principales, examinamos estadísticas reveladoras, mostramos cómo minimizar el impacto del tiempo de inactividad cloud y observamos las caídas más impactantes ocurridas en años recientes.
¿Qué Es una Caída en la Nube?
Una caída en la nube es un período durante el cual los servicios de un proveedor cloud no están disponibles para los usuarios finales. La infraestructura del vendedor se cae (por un bug, fallo de energía, etc.), y los clientes pierden acceso a activos basados en la nube hasta que el proveedor soluciona el problema.
En cuanto a impacto, no hay diferencia entre un centro de datos on-site cayendo y una caída en la nube. Pierdes acceso a activos de TI en ambos casos, pero el enfoque hands-off de la computación en la nube añade algunas consideraciones únicas:
- Las caídas en la nube tienen poca o ninguna visibilidad de fallo, así que los usuarios típicamente no saben qué salió mal.
- El equipo del proveedor es responsable de arreglar el error, así que los clientes no participan en el proceso de recuperación.
- Como no tienes visibilidad ni control sobre el problema, no hay forma de saber cuándo los servicios volverán a estar online.
Como con el hardware local, hay dos tipos de caídas en la nube:
- Planificadas (típicamente ocurren por mantenimiento programado).
- No planificadas (ocurren cuando el proveedor se encuentra con un error inesperado y debe realizar medidas de restauración).
Estudios recientes revelan que las caídas no planificadas cuestan un 35% más que el tiempo de inactividad planificado (tanto on-premise como en la nube). La diferencia de precio existe porque los incidentes inesperados tardan más en identificarse y arreglarse — y cuanto más dura una caída, mayor es el daño.
Comparada con hardware on-site, la infraestructura basada en la nube resulta en tiempo de inactividad más frecuente pero con menor severidad. Como ningún sistema de hosting proporciona 100% uptime, los clientes están dispuestos a tolerar caídas ocasionales a cambio de las ventajas de la computación en la nube. Esta disposición también es evidente en el crecimiento del mercado: la nube representará el 14.2% del gasto total global de TI en 2024 (subiendo del 9.1% en 2020).
Causas de las Caídas en la Nube
Las caídas en la nube resultan de varias causas tanto dentro como fuera del control del proveedor. Aquí una lista de las más comunes:
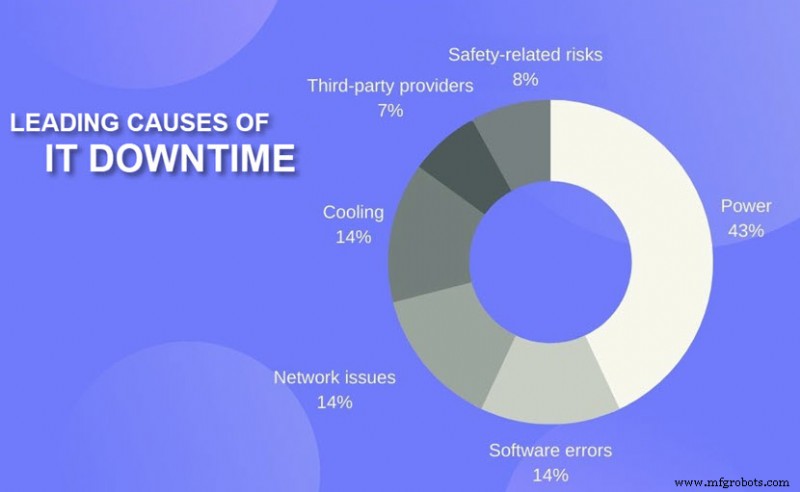
- Corte de energía: Los problemas relacionados con la energía causan el 43% de todas las caídas en la nube con tiempo de inactividad significativo y pérdida financiera. Los fallos de suministro ininterrumpido de energía (UPS) son la causa número uno de incidentes de energía.
- Ciberseguridad: Los ciberataques como el Denegación de Servicio Distribuido (DDoS) sobrecargan centros de datos con tráfico entrante. En ese caso, los usuarios finales no pueden acceder al servicio a través de la misma infraestructura de red. Otras amenazas (como ransomware o inyección SQL) pueden forzar al proveedor a cerrar servicios y remediar el problema offline.
- Error humano: Un solo comando incorrecto o un error con el cableado puede tirar abajo toda la infraestructura TI. Los errores humanos causan tanto problemas físicos como de software que llevan a caídas.
- Problemas técnicos: Los servicios cloud dependen de un sistema complejo de hardware tecnológico, así que un error que logra mantenerse bajo el radar el tiempo suficiente puede llevar a una caída en la nube.
- Bugs de software: Los fallos y bugs son comunes en centros de datos cloud. Los culpables habituales son bugs de formato de datos, bugs relacionados con fallos, bugs de temporización y bugs de valor constante.
- Problemas de red: Problemas asociados con comunicación de red y socios telco de terceros son otra causa común de caídas en la nube.
- Mantenimiento: El mantenimiento programado y actualizaciones de sistema a veces llevan a una caída, aunque los usuarios finales típicamente saben de estas ocurrencias con antelación.
- Causas ambientales: Eventos como huracanes, incendios, tormentas eléctricas y terremotos también desencadenan tiempo de inactividad cloud, ya sea poniendo la instalación en peligro o dañando la red eléctrica de la región.
- Despliegues más complejos: Modelos de despliegue más intrincados (como híbrido, distribuido y multi-cloud) complican las operaciones de centro de datos, creando más oportunidades para errores.
¿Qué Sucede Cuando la Nube Se Caé?
En el mejor escenario, una caída en la nube dura solo unos minutos y afecta a un pequeño número de usuarios o servicios. En el peor caso, una caída paraliza el negocio de un cliente por medio día o más. Una empresa pierde acceso a todos los activos basados en la nube y se queda aislada hasta que la caída termina.
Aunque amenazante, los errores de proveedores terceros fueron la causa de "solo" el 7% de caídas severas en 2021. Una caída severa debe involucrar uno (o varios) de los siguientes:
- Pérdidas financieras significativas.
- Daño reputacional.
- Incumplimientos de cumplimiento.
- Pérdida de vidas.
Aunque hay preocupaciones más apremiantes (como se muestra en el gráfico circular a continuación), recuerda que un minuto promedio de inactividad cuesta $5,600 (esta cifra por minuto sube a $9,000 para empresas). Si no estás preparado (es decir, no tienes backups de datos, recuperación ante desastres, etc.), una caída en la nube podría paralizar tu servicio y causar golpes masivos a la línea de fondo.
Una empresa que mantiene un pequeño segmento de operaciones en la nube es menos vulnerable a caídas. Por ejemplo, si solo alojas correos en la nube, incluso una caída de un día no es catastrófica. Puedes esperar el incidente o ejecutar apps con funcionalidad reducida, una estrategia que no funciona si usas la nube para ejecutar una plataforma IoT o procesar pagos.
En algunos casos, la caída en la nube lleva a pérdida permanente de datos (la cantidad de datos perdidos depende de la frecuencia de backups). Además, clientes en industrias estrictas son responsables de multas legales si una caída lleva a una brecha o fuga de datos, así que ten cuidado al decidir qué guardas en almacenamiento cloud.
¿Qué Pueden Hacer los Usuarios?
Aquí está lo que las empresas hacen para mitigar el impacto de las caídas en la nube:
- Eliminar puntos únicos de fallo: Preparar un backup de cada componente TI crítico para la misión, ya sea en una sala de servidores on-site o en un proveedor secundario. Si la nube se cae, realizas un failover (el proceso de cambiar a un servidor standby, componente de hardware, red, etc.) para asegurar continuidad del negocio.
- Tener un plan de contingencia: Un plan de recuperación ante desastres describe una estrategia paso a paso de qué hace el equipo en caso de caída. Este plan proporciona instrucciones para proteger datos, realizar failover, asegurar continuidad del negocio y restaurar operaciones. La planificación oportuna para una caída en la nube evita perder tiempo evaluando el mejor curso de acción durante el tiempo de inactividad.
- Invertir en un SLA de mayor disponibilidad: Si tus tareas críticas no pueden permitirse caídas prolongadas en la nube, busca un Acuerdo de Nivel de Servicio (SLA) de mayor disponibilidad, como el que garantiza 99.999% uptime (máximo 5.25 minutos de inactividad por año). Estos contratos son más caros, pero mantener tus servicios online se vuelve una prioridad mayor para el proveedor cloud.
- Realizar backups de datos regulares: Un backup asegura que tu equipo tenga forma de restaurar una versión reciente de archivos si una caída en la nube corrompe o elimina una base de datos. Idealmente, los backups deberían ocurrir automáticamente y entre una vez por hora a una vez por día (dependiendo de la criticidad).
- Detectar caídas ASAP: Cualquier capacidad adicional de monitoreo cloud que tu equipo configure ayuda a identificar una caída en tiempo real en lugar de esperar la notificación del proveedor. Aquí una lista de las mejores herramientas de monitoreo cloud para mejorar la detección de tiempo de inactividad y asegurar failover oportuno.
Las Caídas en la Nube Más Grandes Recientes
Las caídas en la nube son inevitables al usar la nube, e incluso los proveedores más populares (como Azure, AWS y Google Cloud) no son inmunes al tiempo de inactividad. Veamos algunas de las caídas en la nube más significativas en la historia reciente.
Caída de Azure (Octubre 2021)
En octubre de 2021, Microsoft Azure sufrió una interrupción que derribó servicios de máquinas virtuales durante seis horas. Durante la caída, muchos usuarios no pudieron desplegar nuevas VMs o actualizar extensiones. Operaciones básicas de gestión de servicios (como iniciar, crear y eliminar) también llevaron a errores.
La causa de la caída fue la incapacidad de las consultas VM para recuperar los datos de versión requeridos de un artefacto. Un informe post-recuperación reveló que el error basado en software ocurrió cuando Microsoft migró una de sus arquitecturas VM.
Caída de Google Cloud (Noviembre 2021)
Google Cloud se cayó por aproximadamente dos horas a mediados de noviembre del año pasado, afectando a empresas como:
- Home Depot.
- Snapchat.
- Etsy.
- Discord.
- Spotify.
Los sitios web afectados mostraban errores 404 cuando los visitantes intentaban acceder a ellos. Google reportó que la causa de la caída fue un fallo en una configuración de red responsable del balanceo de carga.
Caída de AWS (Diciembre 2021)
Un gran aumento de actividad de conexión abrumó dispositivos de red en una de las instalaciones insignia de AWS, afectando varios sitios web y apps. Algunas de las "víctimas" más notables fueron:
- El sitio web de Amazon.
- Prime Video.
- Netflix.
- IMDb.
- PlayStation Network.
El problema del centro de datos causó latencia severa dentro de las redes internas de AWS. Las apps de clientes sintieron los efectos en cascada, sufriendo retrasos de tráfico o apagones totales por aproximadamente siete horas.
Dos Caídas Subsecuentes de IBM (Enero 2022)
Un problema con la infraestructura de IBM afectó servicios cloud en la región de Dallas por más de cinco horas. El equipo interno resolvió el problema pero accidentalmente causó un problema adicional de una hora con cloud privada virtual. El problema secundario afectó usuarios globalmente, incluyendo EE. UU., Japón, Canadá y Alemania.
Caída de AWS/Slack (Febrero 2022)
Slack sufrió una caída de sus recursos cloud de AWS en febrero que impidió el uso normal de la plataforma de comunicación por cinco horas. Más de 11,000 usuarios reportados no pudieron:
- Enviar o recibir mensajes.
- Subir archivos.
- Unirse a canales.
- Lanzar la app de escritorio.
El equipo de Slack nunca compartió la razón detrás de la caída y solicitó a todos los usuarios afectados reiniciar la app y limpiar su caché tras la recuperación.
Caída de iCloud (Marzo 2022)
Quince servicios principales de Apple se cayeron por cuatro horas en marzo debido a una caída en la nube, incluyendo:
- App Store.
- Apple Maps.
- Apple TV.
Los sistemas corporativos y retail de Apple también se cayeron. La compañía reveló más tarde que la causa raíz fue un problema relacionado con el sistema de nombres de dominio (DNS) de la empresa.
Caída de Google Cloud (Marzo 2022)
El 8 de marzo de 2022, usuarios de Google Cloud sufrieron errores de servicio por dos horas y media. Spotify y Discord estuvieron entre los afectados por la caída.
Un cambio en el código del Traffic Director para procesar configuraciones causó el error. Según el informe post-recuperación, malos cambios de código descuidaron migraciones de formato de datos de configuración, por lo que la plataforma inadvertidamente eliminó la programación del usuario.
Caída de Atlassian (Abril 2022)
La mayor caída de Atlassian del año comenzó el 5 de abril y terminó el 18 de abril (aunque algunos usuarios empezaron a restaurar servicios el 8 de abril). La compañía explicó que la caída ocurrió por comunicación inadecuada del equipo y un plan de respuesta a incidentes mal planificado.
Aunque esta caída duró casi dos semanas para algunos usuarios, no hubo reportes de pérdidas significativas de datos de clientes. Sin embargo, usuarios de ambos productos insignia de Atlassian, Trello y Jira, fueron afectados por el problema.
Caída de Microsoft Azure (Junio 2022)
El 7 de junio, clientes de Azure no pudieron conectarse a recursos alojados en la región East US 2 (principalmente Virginia). La caída duró aproximadamente doce horas y no afectó a consumidores que confiaban en infraestructura redundante por zona. Servicios comprometidos incluían:
- Application Insights.
- Log Analytics.
- Managed Identity Service.
- Media Services.
- NetApp Files.
El culpable fue una oscilación repentina de energía en uno de los centros de datos locales, que causó que las Unidades de Manejo de Aire (AHUs) se apagaran.
Caída de Cloudflare (Junio 2022)
En junio, una caída accidental en Cloudflare causó disrupciones mayores que duraron una hora y media, derribando sitios populares como:
- Discord.
- Shopify.
- Fitbit.
- Peloton.
El vendedor basado en San Francisco explicó que el tiempo de inactividad no planificado resultó de un cambio en la configuración de red en 19 de sus centros de datos.
No Subestimes el Valor de la Planificación para Caídas en la Nube
Los ejemplos de caídas en la nube en años recientes envían un mensaje claro: aunque la nube es un cambio de juego en TI, la tecnología no es infalible. Las empresas que se preocupan por usuarios finales y disponibilidad de apps deben estar listas para tiempo de inactividad ocasional, lo que hace que backup y recuperación ante desastres (BDR) sea una parte integral del uso de recursos basados en la nube.
Computación en la nube
- Moldeo por Transferencia Explicado: Proceso, Ventajas y Variantes
- Comprendiendo las Transmisiones de Vehículos: Tipos, Funciones y Cómo Operan
- Dominando las auditorías de vacío: Por qué importan y cómo ejecutarlas
- Comprendiendo los Embragues Industriales: Definición, Funcionamiento y Aplicaciones
- Protocolos de Inspección de Grúas: Frecuencia, Importancia y Mejores Prácticas
- Benchmarking de rendimiento en nube pública: Por qué importa y cómo hacerlo
- Entendiendo la seguridad cloud: por qué su negocio la necesita
- La revolución cloud: cómo el cloud computing transforma TI, seguridad y carreras
- Arquitecturas sin agente vs. basadas en agente: elige el modelo de seguridad cloud adecuado
- Entendiendo servidores VPN ofuscados: cómo funcionan y por qué importan
- Cómo funciona Google Cloud Storage: guía completa