



Diseño de un búfer circular FIFO robusto en VHDL usando RAM de bloques
Los búferes circulares son estructuras populares para crear colas en lenguajes de programación secuenciales, pero también pueden implementarse en hardware. En este artículo, crearemos un búfer circular en VHDL para implementar una FIFO en RAM de bloques.
¿Cómo funciona un búfer circular?
Un búfer circular es una implementación de FIFO que utiliza memoria contigua para almacenar los datos encolados con un mínimo de movimiento de datos. Los nuevos elementos permanecen en la misma ubicación de memoria desde el momento de la escritura hasta que se leen y se eliminan de la FIFO.
Se utilizan dos contadores para rastrear la ubicación y el número de elementos en la FIFO. Estos contadores se refieren a un desplazamiento desde el inicio del espacio de memoria donde se almacenan los datos. En VHDL, esto será un índice a una celda de array. Para el resto de este artículo, nos referiremos a estos contadores como punteros.
Estos dos punteros son el head (cabeza) y el tail (cola). El head siempre apunta a la ranura de memoria que contendrá el próximo dato escrito, mientras que el tail se refiere al próximo elemento que se leerá de la FIFO. Existen otras variantes, pero esta es la que utilizaremos.
Estado vacío

Si el head y el tail apuntan al mismo elemento, significa que la FIFO está vacía. La imagen superior muestra una FIFO de ejemplo con ocho ranuras. Tanto el head como el tail apuntan al elemento 0, indicando que la FIFO está vacía. Este es el estado inicial del búfer circular.
Tenga en cuenta que la FIFO seguiría estando vacía si ambos punteros estuvieran en otro índice, por ejemplo, 3. Por cada escritura, el puntero head avanza una posición. El puntero tail se incrementa cada vez que el usuario de la FIFO lee un elemento.
Cuando cualquiera de los punteros está en el índice más alto, la siguiente escritura o lectura hará que el puntero vuelva al índice más bajo. Esta es la belleza del búfer circular: los datos no se mueven, solo lo hacen los punteros.
Head adelantado a tail

La imagen superior muestra el mismo búfer circular después de cinco escrituras. El puntero tail sigue en la ranura 0, pero el head se ha movido a la ranura 5. Las ranuras que contienen datos están coloreadas en azul claro en la ilustración. El tail apunta al elemento más antiguo, mientras que el head apunta a la próxima ranura libre.
Cuando el head tiene un índice mayor que el tail, podemos calcular el número de elementos en el búfer circular restando el tail del head. En la imagen superior, eso produce un conteo de cinco elementos.
Tail adelantado a head

Restar el head del tail solo funciona si el head adelanta al tail. En la imagen superior, el head está en el índice 2 mientras que el tail está en el índice 5. Por lo tanto, si realizamos este cálculo simple, obtenemos 2 - 5 = -3, lo cual no tiene sentido.
La solución es compensar el head con el número total de ranuras en la FIFO, 8 en este caso. El cálculo ahora produce (2 + 8) - 5 = 5, que es la respuesta correcta.
El tail siempre perseguirá al head, así es como funciona un búfer circular. La mitad del tiempo el tail tendrá un índice mayor que el head. Los datos se almacenan entre los dos, como indica el color azul claro en la imagen superior.
Estado lleno

Un búfer circular lleno tendrá el tail apuntando al índice directamente después del head. Una consecuencia de este esquema es que nunca podemos usar todas las ranuras para almacenar datos; debe haber al menos una ranura libre. La imagen superior muestra una situación donde el búfer circular está lleno. La ranura abierta pero inutilizable está coloreada en amarillo.
Una señal dedicada de vacío/lleno también podría usarse para indicar que el búfer circular está lleno. Esto permitiría que todas las ranuras de memoria almacenaran datos, pero requiere lógica adicional en forma de registros y tablas de búsqueda (LUTs). Por lo tanto, utilizaremos el esquema mantener una libre para nuestra implementación de la FIFO de búfer circular, ya que solo desperdicia RAM de bloques más barata.
Implementación de la FIFO de búfer circular
La forma en que defina las señales de interfaz hacia y desde su FIFO limitará el número de posibles implementaciones de su búfer circular. En nuestro ejemplo, utilizaremos una variación de la interfaz clásica de habilitación de lectura/escritura y señales empty/full/valid.
Habrá un bus de datos de escritura en el lado de entrada que transporta los datos que se empujarán a la FIFO. También habrá una señal de habilitación de escritura, que cuando se afirma, hará que la FIFO tome una muestra de los datos de entrada.
El lado de salida tendrá una señal de datos de lectura y una señal de valid de lectura controladas por la FIFO. También tendrá una señal de habilitación de lectura controlada por el usuario downstream de la FIFO.
Las señales de control empty y full son parte de la interfaz clásica de FIFO, las usaremos también. Son controladas por la FIFO y su propósito es comunicar el estado de la FIFO al lector y al escritor.
Contrapresión (Back pressure)
El problema de esperar hasta que la FIFO esté vacía o llena antes de actuar es que la lógica de interfaz no tendrá tiempo para reaccionar. La lógica secuencial funciona en base a ciclos de reloj, los flancos de subida del reloj separan efectivamente los eventos en su diseño en pasos de tiempo.

Una solución es incluir señales casi vacío y casi lleno que preceden a las señales originales en un ciclo de reloj. Esto da tiempo a la lógica externa para reaccionar, incluso cuando se lee o escribe continuamente.
En nuestra implementación, las señales anticipadas se llamarán empty_next y full_next, simplemente porque prefiero usar sufijos en lugar de prefijos en los nombres.

La entidad
La imagen siguiente muestra la entidad de nuestro búfer circular FIFO. Además de las señales de entrada y salida en el puerto, tiene dos constantes genéricas. El genérico RAM_WIDTH define el número de bits en las palabras de entrada y salida, el número de bits que contendrá cada ranura de memoria.
El genérico RAM_DEPTH define el número de ranuras que se reservarán para el búfer circular. Como una ranura se reserva para indicar que el búfer circular está lleno, la capacidad de la FIFO será RAM_DEPTH - 1. La constante RAM_DEPTH debe coincidir con la profundidad de la RAM en el FPGA objetivo. La RAM no utilizada dentro de un primitivo de RAM de bloque se desperdiciará, no puede compartirse con otra lógica en el FPGA.
entity ring_buffer is
  generic (
    RAM_WIDTH : natural;
    RAM_DEPTH : natural
  );
  port (
    clk       : in  std_logic;
    rst       : in  std_logic;
    -- Puerto de escritura
    wr_en     : in  std_logic;
    wr_data   : in  std_logic_vector(RAM_WIDTH - 1 downto 0);
    -- Puerto de lectura
    rd_en     : in  std_logic;
    rd_valid  : out std_logic;
    rd_data   : out std_logic_vector(RAM_WIDTH - 1 downto 0);
    -- Banderas
    empty     : out std_logic;
    empty_next: out std_logic;
    full      : out std_logic;
    full_next : out std_logic;
    -- Número de elementos en la FIFO
    fill_count: out integer range RAM_DEPTH - 1 downto 0
  );
end ring_buffer;
Además del reloj y el reset, la declaración del puerto incluye puertos clásicos de datos/habilitación de lectura y escritura. Estos son utilizados por los módulos upstream y downstream para empujar nuevos datos a la FIFO y para sacar el elemento más antiguo de ella.
La señal rd_valid es afirmada por la FIFO cuando el puerto rd_data contiene datos válidos. Este evento se retrasa un ciclo de reloj después de un pulso en la señal rd_en. Hablaremos más sobre por qué tiene que ser así al final de este artículo.
Luego vienen las banderas empty/full establecidas por la FIFO. La señal empty_next se afirmará cuando queden 1 o 0 elementos, mientras que empty solo está activa cuando hay 0 elementos en la FIFO. De manera similar, la señal full_next indicará que hay espacio para 1 o 0 elementos más, mientras que full solo se afirma cuando la FIFO no puede acomodar otro elemento de datos.
Finalmente, hay una salida fill_count. Este es un entero que reflejará el número de elementos actualmente almacenados en la FIFO. He incluido esta señal de salida simplemente porque la usaremos internamente en el módulo. Sacarla a través de la entidad es esencialmente gratis, y el usuario puede optar por dejar esta señal sin conectar al instanciar este módulo.
La región declarativa
En la región declarativa del archivo VHDL, declararemos un tipo personalizado, un subtipo, varias señales y un procedimiento para uso interno en el módulo del búfer circular.
architecture rtl of ring_buffer is
  type ram_type is array (0 to RAM_DEPTH - 1) of std_logic_vector(wr_data'range);
  signal ram : ram_type;

  subtype index_type is integer range ram_type'range;
  signal head : index_type;
  signal tail : index_type;

  signal empty_i     : std_logic;
  signal full_i      : std_logic;
  signal fill_count_i: integer range RAM_DEPTH - 1 downto 0;

  -- Procedimiento para incrementar y hacer wrap
  procedure incr(signal index : inout index_type) is
  begin
    if index = index_type'high then
      index <= index_type'low;
    else
      index <= index + 1;
    end if;
  end procedure;
Primero, declaramos un nuevo tipo para modelar nuestra RAM. El tipo ram_type es un array de vectores, dimensionado por las entradas genéricas. El nuevo tipo se usa en la siguiente línea para declarar la señal ram que contendrá los datos en el búfer circular.
En el siguiente bloque de código, declaramos index_type, un subtipo de entero. Su rango será gobernado indirectamente por el genérico RAM_DEPTH. Debajo de la declaración del subtipo, estamos usando el tipo de índice para declarar dos nuevas señales, los punteros head y tail.
Luego sigue un bloque de declaraciones de señales que son copias internas de las señales de la entidad. Tienen los mismos nombres base que las señales de la entidad pero están postfijadas con _i para indicar que son para uso interno. Usamos este enfoque porque se considera mala práctica usar modo inout en señales de entidad, aunque tendría el mismo efecto.
Finalmente, declaramos un procedimiento llamado incr que toma una señal index_type como parámetro. Este subprograma se usará para incrementar los punteros head y tail, y hacerles wrap de vuelta a 0 cuando estén en el valor más alto. El head y tail son subtipos de entero, que normalmente no soportan comportamiento de wrap. Usaremos el procedimiento para sortear este problema.
Sentencias concurrentes
En la parte superior de la arquitectura, declaramos nuestras sentencias concurrentes. Prefiero reunir estas asignaciones de señal de una línea antes de los procesos normales porque son fácilmente pasadas por alto. Una sentencia concurrente es en realidad una forma de proceso.
begin
  -- Copiar señales internas a salidas
  empty     <= empty_i;
  full      <= full_i;
  fill_count<= fill_count_i;

  -- Establecer las banderas
  empty_i     <= '1' when fill_count_i = 0              else '0';
  empty_next  <= '1' when fill_count_i <= 1             else '0';
  full_i      <= '1' when fill_count_i >= RAM_DEPTH - 1 else '0';
  full_next   <= '1' when fill_count_i >= RAM_DEPTH - 2 else '0';
En el primer bloque de asignaciones concurrentes, copiamos las versiones internas de las señales de la entidad a la salida. Estas líneas aseguran que las señales de la entidad sigan a las versiones internas exactamente al mismo tiempo, pero con un retraso de un ciclo delta en simulación.
El segundo y último bloque de sentencias concurrentes es donde asignamos las banderas de salida, señalando el estado lleno/vacío del búfer circular. Basamos los cálculos en el genérico RAM_DEPTH y en la señal fill_count. La profundidad de la RAM es una constante que no cambiará. Por lo tanto, las banderas cambiarán solo como resultado de un conteo de llenado actualizado.
Actualización del puntero head
La función básica del puntero head es incrementarse cada vez que la señal de habilitación de escritura se afirma desde fuera de este módulo. Lo hacemos pasando la señal head al procedimiento incr mencionado anteriormente.
PROC_HEAD : process(clk)
begin
  if rising_edge(clk) then
    if rst = '1' then
      head <= 0;
    else
      if wr_en = '1' and full_i = '0' then
        incr(head);
      end if;
    end if;
  end if;
end process;
Nuestro código contiene una declaración adicional and full_i = '0' para proteger contra sobrescrituras. Esta lógica puede omitirse si está seguro de que la fuente de datos nunca intentará escribir en la FIFO mientras esté llena. Sin esta protección, una sobrescritura hará que el búfer circular se vuelva a ver vacío.
Si el puntero head se incrementa mientras el búfer circular está lleno, el head apuntará al mismo elemento que el tail. Así, el módulo "olvidará" los datos contenidos, y el llenado de la FIFO aparecerá como vacío.
Al evaluar la señal full_i antes de incrementar el puntero head, solo olvidará el valor sobrescrito. Creo que esta solución es más limpia. De cualquier manera, si ocurren sobrescrituras, es indicativo de un mal funcionamiento fuera de este módulo.
Actualización del puntero tail
El puntero tail se incrementa de manera similar al head, pero se usa la entrada read_en como disparador. Al igual que con las sobrescrituras, nos protegemos contra sobrelecturas incluyendo and empty_i = '0' en la expresión booleana.
PROC_TAIL : process(clk)
begin
  if rising_edge(clk) then
    if rst = '1' then
      tail     <= 0;
      rd_valid <= '0';
    else
      rd_valid <= '0';
      if rd_en = '1' and empty_i = '0' then
        incr(tail);
        rd_valid <= '1';
      end if;
    end if;
  end if;
end process;
Además, pulsamos la señal rd_valid en cada lectura válida. Los datos de lectura son siempre válidos en el ciclo de reloj después de que se afirmara rd_en, si la FIFO no estaba vacía. Con este conocimiento, no hay realmente necesidad de esta señal, pero la incluiremos por conveniencia. La señal rd_valid se optimizará en síntesis si se deja sin conectar cuando se instancia el módulo.
Inferencia de RAM de bloques
Para que la herramienta de síntesis infiera RAM de bloques, debemos declarar los puertos de lectura y escritura en un proceso síncrono sin reset. Leeremos y escribiremos en la RAM en cada ciclo de reloj, y dejaremos que las señales de control manejen el uso de estos datos.
PROC_RAM : process(clk)
begin
  if rising_edge(clk) then
    ram(head) <= wr_data;
    rd_data   <= ram(tail);
  end if;
end process;
Este proceso no sabe cuándo ocurrirá la próxima escritura, pero no necesita saberlo. En su lugar, simplemente escribimos continuamente. Cuando la señal head se incrementa como resultado de una escritura, comenzamos a escribir en la siguiente ranura. Esto efectivamente bloquea el valor que se escribió.
Actualización del contador de llenado
La señal fill_count se usa para generar las señales full y empty, que a su vez se usan para prevenir sobrescritura y sobrelectura de la FIFO. El contador de llenado se actualiza mediante un proceso combinacional que es sensible a los punteros head y tail, pero esas señales solo se actualizan en el flanco de subida del reloj. Por lo tanto, el conteo de llenado también cambiará inmediatamente después del flanco de reloj.
PROC_COUNT : process(head, tail)
begin
  if head < tail then
    fill_count_i <= head - tail + RAM_DEPTH;
  else
    fill_count_i <= head - tail;
  end if;
end process;
El conteo de llenado se calcula simplemente restando el tail del head. Si el índice del tail es mayor que el head, debemos agregar el valor de la constante RAM_DEPTH para obtener el número correcto de elementos que están actualmente en el búfer circular.
Código VHDL completo para la FIFO de búfer circular
library ieee;
use ieee.std_logic_1164.all;

entity ring_buffer is
  generic (
    RAM_WIDTH : natural;
    RAM_DEPTH : natural
  );
  port (
    clk       : in  std_logic;
    rst       : in  std_logic;
    -- Puerto de escritura
    wr_en     : in  std_logic;
    wr_data   : in  std_logic_vector(RAM_WIDTH - 1 downto 0);
    -- Puerto de lectura
    rd_en     : in  std_logic;
    rd_valid  : out std_logic;
    rd_data   : out std_logic_vector(RAM_WIDTH - 1 downto 0);
    -- Banderas
    empty     : out std_logic;
    empty_next: out std_logic;
    full      : out std_logic;
    full_next : out std_logic;
    -- Número de elementos en la FIFO
    fill_count: out integer range RAM_DEPTH - 1 downto 0
  );
end ring_buffer;

architecture rtl of ring_buffer is
  type ram_type is array (0 to RAM_DEPTH - 1) of std_logic_vector(wr_data'range);
  signal ram : ram_type;

  subtype index_type is integer range ram_type'range;
  signal head : index_type;
  signal tail : index_type;

  signal empty_i     : std_logic;
  signal full_i      : std_logic;
  signal fill_count_i: integer range RAM_DEPTH - 1 downto 0;

  -- Incrementar y hacer wrap
  procedure incr(signal index : inout index_type) is
  begin
    if index = index_type'high then
      index <= index_type'low;
    else
      index <= index + 1;
    end if;
  end procedure;

begin
  -- Copiar señales internas a salidas
  empty     <= empty_i;
  full      <= full_i;
  fill_count<= fill_count_i;

  -- Establecer las banderas
  empty_i     <= '1' when fill_count_i = 0              else '0';
  empty_next  <= '1' when fill_count_i <= 1             else '0';
  full_i      <= '1' when fill_count_i >= RAM_DEPTH - 1 else '0';
  full_next   <= '1' when fill_count_i >= RAM_DEPTH - 2 else '0';

  -- Actualizar puntero head en escritura
  PROC_HEAD : process(clk)
  begin
    if rising_edge(clk) then
      if rst = '1' then
        head <= 0;
      else
        if wr_en = '1' and full_i = '0' then
          incr(head);
        end if;
      end if;
    end if;
  end process;

  -- Actualizar puntero tail en lectura y pulsar valid
  PROC_TAIL : process(clk)
  begin
    if rising_edge(clk) then
      if rst = '1' then
        tail     <= 0;
        rd_valid <= '0';
      else
        rd_valid <= '0';
        if rd_en = '1' and empty_i = '0' then
          incr(tail);
          rd_valid <= '1';
        end if;
      end if;
    end if;
  end process;

  -- Escribir y leer de la RAM
  PROC_RAM : process(clk)
  begin
    if rising_edge(clk) then
      ram(head) <= wr_data;
      rd_data   <= ram(tail);
    end if;
  end process;

  -- Actualizar contador de llenado
  PROC_COUNT : process(head, tail)
  begin
    if head < tail then
      fill_count_i <= head - tail + RAM_DEPTH;
    else
      fill_count_i <= head - tail;
    end if;
  end process;

end architecture;
El código anterior muestra el código completo para la FIFO de búfer circular. Puede completar el formulario a continuación para recibir instantáneamente por correo los archivos del proyecto ModelSim así como el testbench.
El testbench
La FIFO se instancia en un testbench simple para demostrar cómo funciona. Puede descargar el código fuente del testbench junto con el proyecto ModelSim usando el formulario a continuación.
Las entradas genéricas se han establecido en los siguientes valores:
- RAM_WIDTH: 16
- RAM_DEPTH: 256
El testbench primero resetea la FIFO. Cuando se libera el reset, el testbench escribe valores secuenciales (1-255) en la FIFO hasta que se llena. Finalmente, la FIFO se vacía antes de que la prueba se complete.
Podemos ver la forma de onda para la ejecución completa del testbench en la imagen siguiente. La señal fill_count se muestra como un valor analógico en la forma de onda para ilustrar mejor el nivel de llenado de la FIFO.
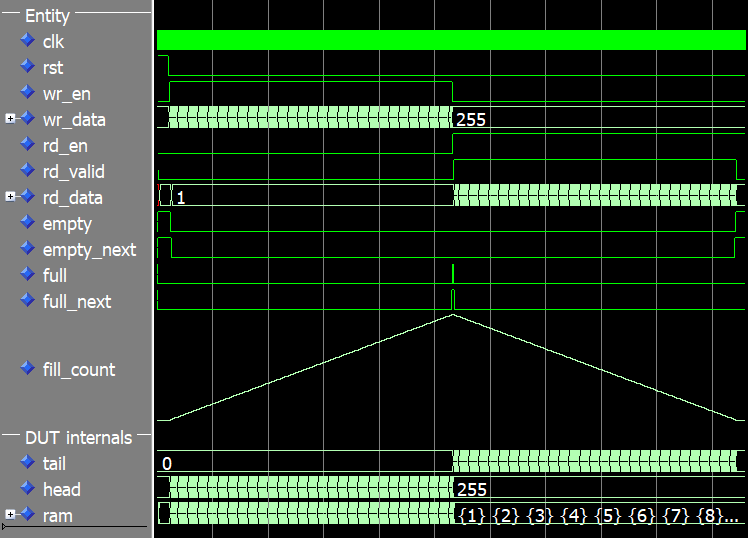
El head, el tail y el fill count son 0 al inicio de la simulación. En el punto donde la señal full se afirma, el head tiene el valor 255, y la señal fill_count también. El fill count solo llega a 255 aunque tengamos una profundidad de RAM de 256. Eso es porque estamos usando el método mantener una libre para distinguir entre lleno y vacío, como discutimos anteriormente en este artículo.
En el punto de inflexión donde dejamos de escribir en la FIFO y empezamos a leer de ella, el valor del head se congela mientras el tail y el fill count comienzan a disminuir. Finalmente, al final de la simulación cuando la FIFO está vacía, tanto el head como el tail tienen el valor 255 mientras que el fill count es 0.
Este testbench no debe considerarse adecuado para nada más que fines de demostración. No tiene comportamiento de auto-comprobación ni lógica para verificar que la salida de la FIFO es correcta en absoluto.
Usaremos este módulo en el artículo de la próxima semana cuando profundicemos en el tema de verificación aleatoria restringida. Esta es una estrategia de prueba diferente de las pruebas dirigidas más comúnmente usadas. En resumen, el testbench realizará interacciones aleatorias con el DUT (device under test), y el comportamiento del DUT debe ser verificado por un proceso de testbench separado. Finalmente, cuando se hayan producido un número de eventos predefinidos, la prueba se completa.
Haga clic aquí para leer el artículo de seguimiento:
Verificación aleatoria restringida
Síntesis en Vivado
Síntesis el búfer circular en Xilinx Vivado porque es la herramienta de implementación FPGA más popular. Sin embargo, debería funcionar en todas las arquitecturas FPGA que tengan RAM de bloques de doble puerto.
Tenemos que asignar algunos valores a las entradas genéricas para poder implementar el búfer circular como un módulo independiente. Esto se hace en Vivado usando el menú Settings → General → Generics/Parameters, como se muestra en la imagen siguiente.
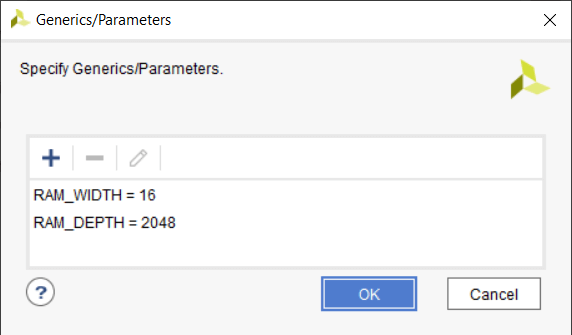
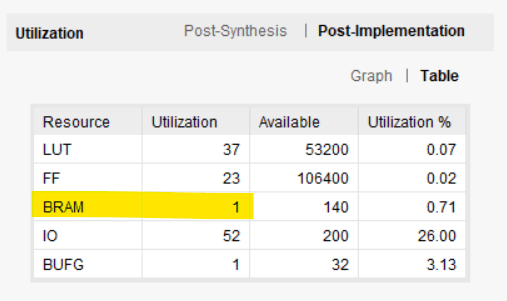
El valor para RAM_WIDTH se establece en 16, igual que en la simulación. Pero he establecido RAM_DEPTH en 2048 porque esta es la profundidad máxima del primitivo RAMB36E1 en la arquitectura Xilinx Zynq que he elegido. Podríamos haber seleccionado un valor menor, pero aún así habría usado la misma cantidad de RAMs de bloque. Un valor mayor habría resultado en el uso de más de una RAM de bloque.
La imagen siguiente muestra el uso de recursos post-implementación, según lo reportado por Vivado. Nuestro búfer circular ha consumido efectivamente una RAM de bloque y un puñado de LUTs y flip-flops.
Prescindir de la señal valid
Puede preguntarse si el retraso de un ciclo de reloj entre la señal rd_en y la señal rd_valid es realmente necesario. Después de todo, los datos ya están presentes en rd_data cuando afirmamos la señal rd_en. ¿No podemos simplemente usar este valor y dejar que el búfer circular salte al siguiente elemento en el próximo ciclo de reloj mientras leemos de la FIFO?

Estrictamente hablando, no necesitamos la señal valid. La incluí solo por conveniencia. La parte crucial es que debemos esperar hasta el ciclo de reloj después de haber afirmado la señal rd_en, de lo contrario la RAM no tendrá tiempo para reaccionar.
La RAM de bloques en FPGAs son componentes totalmente síncronos, necesitan un flanco de reloj tanto para leer como para escribir datos. El reloj de lectura y escritura no tiene que provenir de la misma fuente de reloj, pero debe haber flancos de reloj. Además, no puede haber lógica entre la salida de la RAM y el siguiente registro (flip-flops). Esto es porque el registro que se usa para registrar la salida de la RAM está dentro del primitivo de RAM de bloque.

La imagen superior muestra un diagrama de tiempos de cómo un valor se propaga desde la entrada wr_data en nuestro búfer circular, a través de la RAM, y finalmente aparece en la salida rd_data. Como cada señal se muestrea en el flanco de subida del reloj, se necesitan tres ciclos de reloj desde que empezamos a conducir el puerto de escritura antes de que aparezca en el puerto de lectura. Y un ciclo de reloj adicional pasa antes de que el módulo receptor pueda utilizar estos datos.
Reduciendo la latencia
Hay formas de mitigar este problema, pero a costa de recursos adicionales usados en el FPGA. Intentemos un experimento para eliminar un ciclo de reloj de retraso del puerto de lectura de nuestro búfer circular. En el fragmento de código siguiente hemos cambiado la salida rd_data de un proceso síncrono a un proceso combinacional sensible a las señales ram y tail.
PROC_READ : process(ram, tail)
begin
  rd_data <= ram(tail);
end process;
Desafortunadamente, este código no puede mapearse a RAM de bloques porque puede haber lógica combinacional entre la salida de la RAM y el primer registro downstream en la señal rd_data.
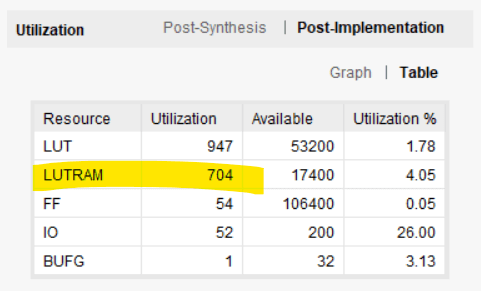
La imagen siguiente muestra el uso de recursos según lo reportado por Vivado. La RAM de bloques ha sido reemplazada por LUTRAM; una forma de RAM distribuida implementada en LUTs. El uso de LUTs se ha disparado de 37 LUTs a 947. Las tablas de búsqueda y flip-flops son más caros que la RAM de bloques, esa es la razón principal por la que tenemos RAM de bloques en primer lugar.
Hay muchas formas de implementar una FIFO de búfer circular en RAM de bloques. Puede ser capaz de ahorrar el ciclo de reloj extra usando otro diseño, pero costará en forma de lógica de soporte adicional. Para la mayoría de las aplicaciones, el búfer circular presentado en este artículo será suficiente.
Actualización:
Cómo crear una FIFO de búfer circular en RAM de bloques usando el handshake AXI ready/valid
En la próxima entrada del blog, crearemos un mejor testbench para el módulo de búfer circular usando verificación aleatoria restringida.
Haga clic aquí para leer el artículo de seguimiento:
Verificación aleatoria restringida
VHDL
- Creación de listas de cadenas en VHDL: Buenas prácticas y ejemplo
- Creación de un testbench dirigido por Tcl para un módulo VHDL de cerradura por código
- Finalizar elegantemente una simulación de testbench VHDL
- Implementación de un controlador PWM en VHDL: Diseño, simulación y demo en FPGA
- Generación de números aleatorios en VHDL: De uniforme a OSVVM
- Cómo construir un testbench de auto-comprobación en VHDL: Guía práctica
- Implementación de lista enlazada dinámica en VHDL con tipos protegidos y punteros de acceso
- Aprovechando procedimientos en-proceso para diseños FSM más limpios en VHDL
- Uso de funciones impuras en VHDL: Mejorando legibilidad y mantenibilidad de FSM
- Dominando funciones VHDL: Guía práctica para diseño eficiente
- Diseño de máquina de estados finitos en VHDL: Ejemplo práctico de semáforo