



Machine Learning 101: Entendiendo los 4 tipos fundamentales para principiantes
Sin duda, Big Data es parte importante del desarrollo tecnológico futuro. Sin embargo, machine learning (ML) e Inteligencia Artificial (IA) juegan un papel importante. La relación entre los tres: Big Data es el material, ML es el método, IA es el resultado.
¿Qué es Machine Learning?
Machine Learning (ML) es un tipo de inteligencia artificial (IA) donde los algoritmos se escriben de manera que el sistema tiene la capacidad de aprender, adaptarse y mejorar automáticamente mediante la experiencia sin ser programado explícitamente.
Los algoritmos ML construyen un modelo ejemplar basado en el tipo de datos al que se dirige a aprender, estos datos se llaman "datos de entrenamiento".
¿Tipos de machine learning?
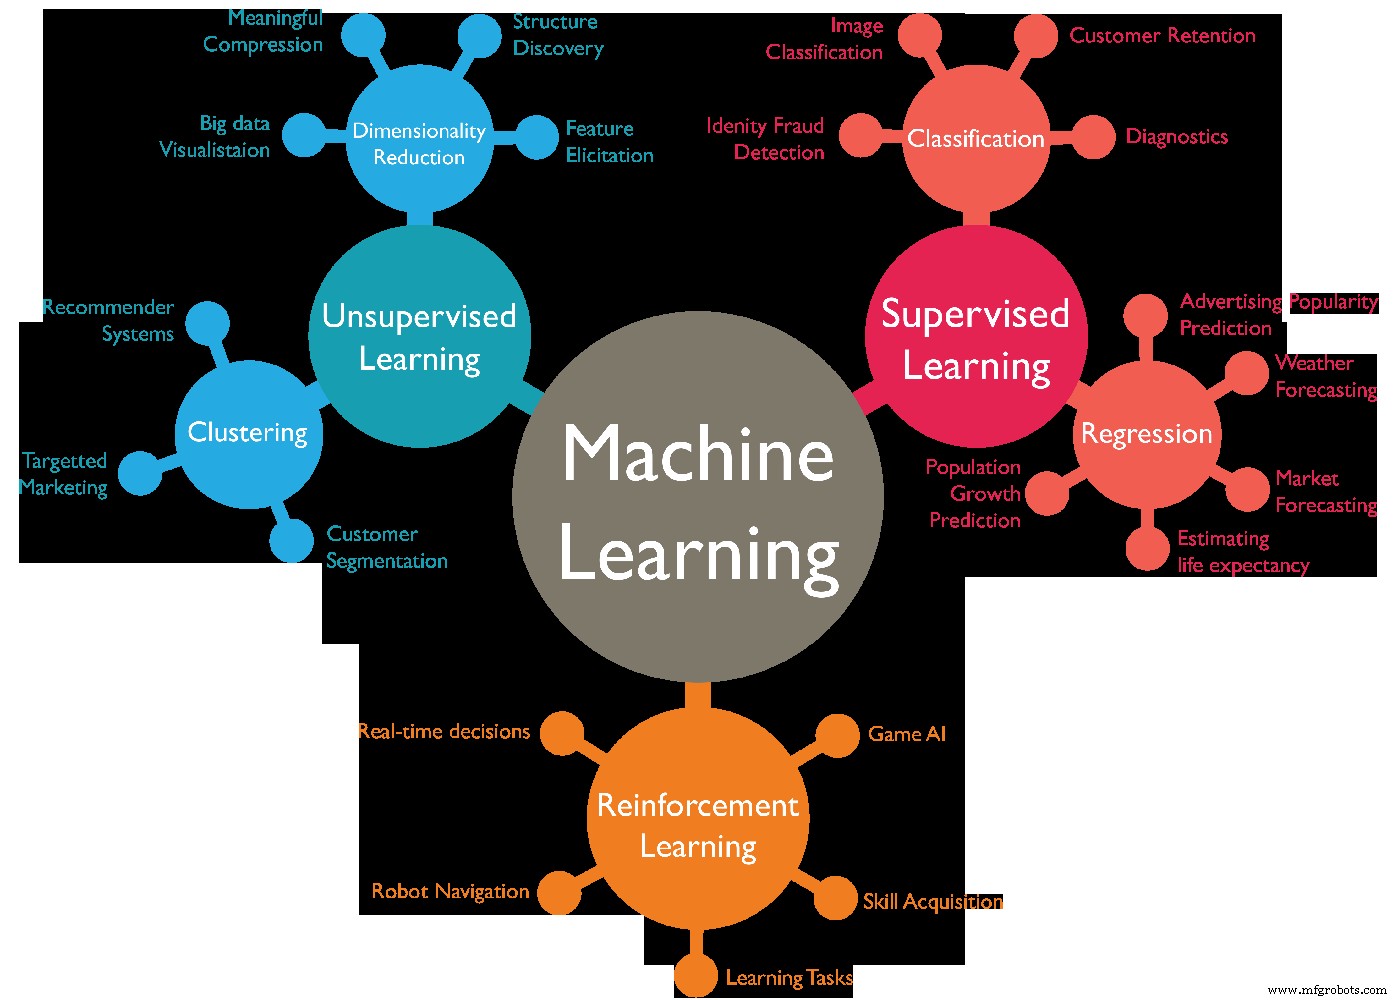
Hay varios tipos de algoritmos ML, comúnmente divididos en 4 categorías:
- Aprendizaje supervisado.
- Aprendizaje no supervisado.
- Aprendizaje semi-supervisado.
- Aprendizaje por refuerzo.
Aprendizaje Supervisado
Cuando la máquina es supervisada en su etapa de "aprendizaje", este entrenamiento se llama aprendizaje supervisado. ¿Qué significa realmente que una máquina sea supervisada? Significa aplicar algoritmos para que la máquina aprenda a usar sus datos antiguos (datos proporcionados en el pasado) y usarlos para predecir eventos futuros sobre el tipo de datos introducidos, es decir, datos antiguos.
El análisis comienza y todos los materiales en el conjunto de entrenamiento etiquetados se correlacionan con la máquina para que pueda predecir valores de salida correctos. Significa que damos a la máquina mucha info sobre un caso particular y luego da un resultado. El resultado se llama datos etiquetados, el resto son características de entrada. El sistema puede entonces dar objetivos para nuevas entradas tras entrenamiento suficiente. El algoritmo compara su salida con la salida intencionada y halla diferencias para cambiar el modelo según corresponda.
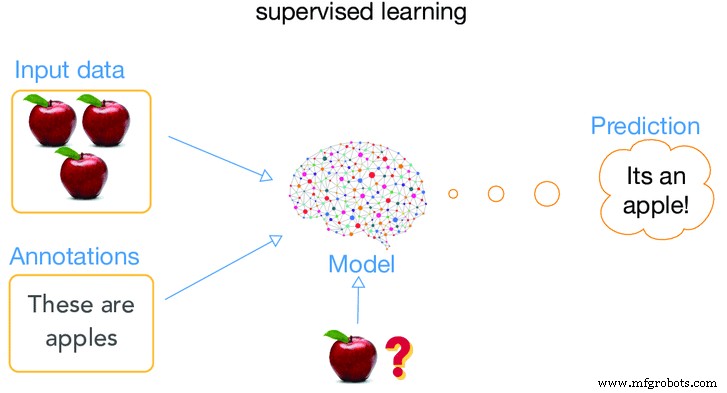
Imagen: artificialintelligence.oodles.io/
Mayormente este método es clasificación manual, lo más fácil para un ordenador y lo más difícil para humanos. Ejemplo: decirle a la máquina respuestas estándar, y al testear, la máquina siempre responderá según la respuesta estándar, por lo que su fiabilidad será mayor.
Aprendizaje no supervisado
En contraste con el supervisado, los algoritmos no supervisados se usan cuando la info para entrenar la máquina no está ni clasificada ni etiquetada; como sugiere el nombre, en aprendizaje no supervisado no se ofrece ayuda del usuario al ordenador para que aprenda.
El material no tiene etiqueta, y la máquina empareja características de los datos y clasifica los materiales. Por la falta de conjuntos de entrenamiento etiquetados, la máquina identifica patrones en los datos no tan obvios para humanos.
Imagen: data-flair.training/
En este método no hay clasificación manual, lo más fácil para humanos pero más difícil para el ordenador y puede causar más errores. El sistema mostly no averigua la salida intencionada, pero investiga los datos proporcionados y puede extraer relaciones de datasets para describir estructuras ocultas de datos no etiquetados. Por tanto, para reconocer patrones en datos el aprendizaje no supervisado es extremadamente útil y nos ayuda a tomar decisiones.
Aprendizaje semi-supervisado
El aprendizaje semi-supervisado es distinto al supervisado y no supervisado en que, o no hay etiquetas para todas las observaciones de datos o hay etiquetas presentes.
En semi-supervisado se usan tanto datos etiquetados (supervisados) como no etiquetados (no supervisados) para entrenamiento. SSL es una mezcla donde una pequeña cantidad de datos está etiquetada y grandes cantidades no lo están. La máquina debe hallar características mediante datos etiquetados y luego, usando el modelo base, clasifica otros datos según corresponda. Los sistemas SSL pueden mejorar considerablemente no solo su precisión de aprendizaje sino también hacer predicciones más precisas.
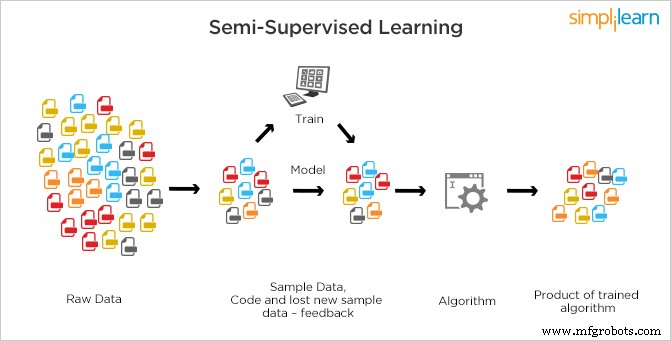
Es el método más usado porque el coste de etiquetar es alto al requerir expertos humanos cualificados. Requiere recursos relevantes para entrenar y aprender mientras que adquirir datos no etiquetados generalmente no requiere recursos adicionales. Por la falta de etiquetas en la mayoría de observaciones pero presencia de unas pocas, los algoritmos semi-supervisados son los mejores candidatos para construir un modelo.
Estos métodos se benefician de la idea de que aunque los miembros del grupo sean desconocidos porque los datos no etiquetados son más generales, información sobre los parámetros sigue llevándose en los etiquetados y puede encontrarse usándolos.
Aprendizaje por refuerzo
El aprendizaje por refuerzo es el más cercano a cómo aprendemos los humanos. Los algoritmos RML son un método donde la máquina interactúa repetidamente con su entorno construyendo nuevas acciones y descubriendo errores o recompensas. Usa un sistema de recompensas positivo o negativo.
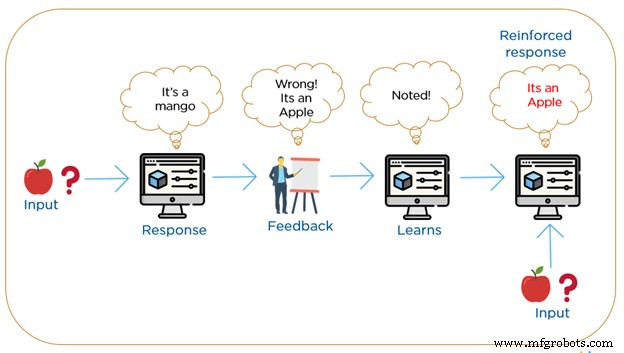
Búsqueda por ensayo y error con recompensa diferida es la característica más relevante. La máquina construye un comportamiento usando observaciones de interactuar con el entorno y toma acciones que maximicen la recompensa o minimicen el riesgo. Este método permite a las máquinas determinar automáticamente el comportamiento ideal en un contexto para aumentar su rendimiento. En aprendizaje por refuerzo no hay materiales etiquetados, sino que requiere simple feedback: qué paso es correcto y cuál incorrecto, conocida como señal de refuerzo.

Según el estándar de feedback, la máquina revisa gradualmente su clasificación hasta obtener el resultado correcto. La integración del aprendizaje por refuerzo es necesaria para lograr cierto nivel de precisión en aprendizaje no supervisado.
RML es probablemente el más difícil de producir y ejecutar en entorno empresarial, pero se usa comúnmente para coches autónomos.
Tecnología Industrial
- Entendiendo las Máquinas Fresadoras: Tipos, Funciones y Aplicaciones
- Elementary Robotics recauda 13 M$ en Serie A para expandir soluciones de visión y machine learning industrial
- Aprendizaje Automático Acelerará la Seguridad en Tuberías: Detección de Fallas en Tiempo Real Ahorra $10M
- Aprovechando el Machine Learning para Optimizar la Gestión de Cadena de Suministro MRO
- Maximice la eficiencia en la construcción: 4 preguntas para aprovechar los datos de campo en tiempo real
- Aprovechando la analítica de datos para impulsar eficiencia y rentabilidad para propietarios de activos Oil & Gas
- Explorando el poliuretano: Tipos, usos y por qué domina las industrias modernas
- Comprender las Fresadoras: Funciones, Aplicaciones y Beneficios
- Kepware vs. MachineMetrics: Elegir la plataforma óptima para recopilación de datos de máquinas industriales
- 9 Aplicaciones esenciales de Machine Learning que debes conocer
- AWS Impulsa Servicios de IA y Machine Learning con Nuevas Características e Integraciones