



El chip híbrido Data‑Flow & Von Neumann de Quadric acelera cargas de trabajo de IA y visión
Una novedosa arquitectura híbrida de flujo de datos y Von Neumann puede acelerar cargas de trabajo que incluyen redes neuronales, aprendizaje automático, visión por computadora, DSP y subprogramas básicos de álgebra lineal.
Quadric, una startup de Silicon Valley, ha diseñado un acelerador que impulsa tanto la inferencia de IA como algoritmos tradicionales de visión por computadora en dispositivos de borde como robots, automatización de fábricas e imágenes médicas. El diseño híbrido único del hardware unifica principios de flujo de datos y Von Neumann, permitiendo ejecución eficiente de redes neuronales, aprendizaje automático, DSP y rutinas de álgebra lineal.
«Desde el principio, reconocimos que los dispositivos de borde demandan más que solo IA», dijo el CEO Veerbhan Kheterpal a EE Times. «Los desarrolladores necesitan un único sistema que pueda ejecutar algoritmos clásicos de computación de alto rendimiento junto con IA.»
Kheterpal enfatizó que la arquitectura no es una colección de aceleradores discretos sino un único conjunto de instrucciones paralelo de datos que puede acelerar diversas cargas de trabajo, incluida la inferencia de IA.
«Trabajos recientes muestran que reemplazar capas enteras con transformadas rápidas de Fourier (FFT) puede acelerar dramáticamente transformers», dijo el Director de Producto Daniel Firu. Quadric está preparado para acelerar tales cargas, citando un artículo de Google donde una sub-capa de auto-atención de un transformer encoder se intercambió por una FFT, logrando 92 % de precisión en el benchmark BERT y entrenando hasta siete veces más rápido en GPUs o el doble de rápido en TPUs.
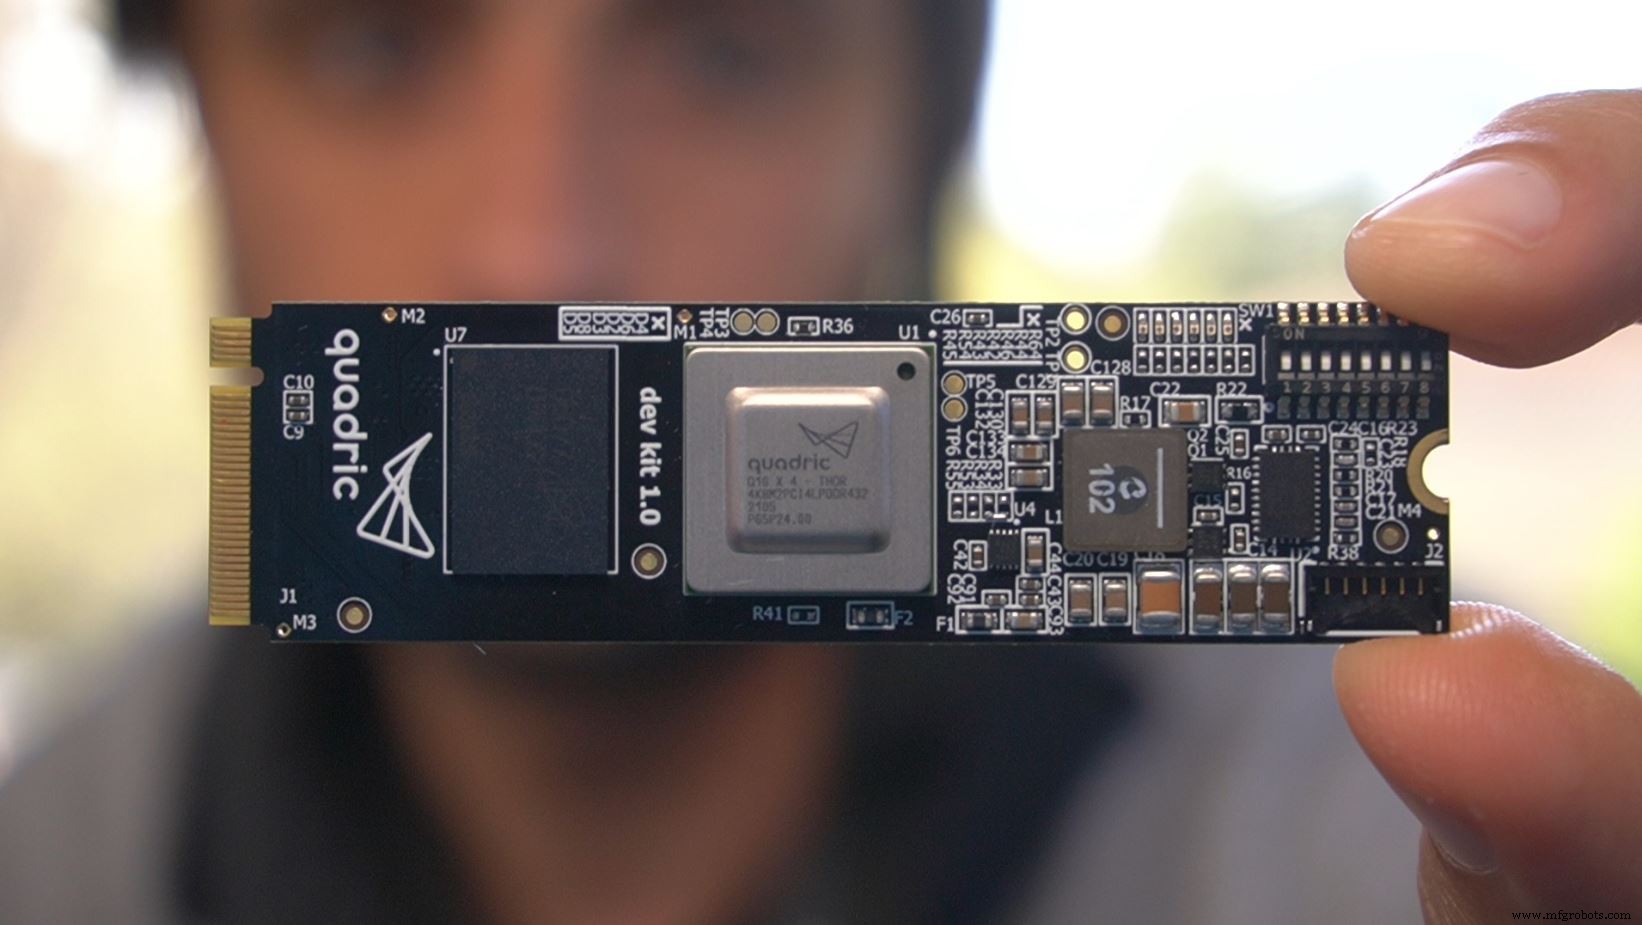
Kit de desarrollador de Quadric, una tarjeta M.2 con el procesador Q16 y 4 GB de memoria externa (Fuente: Quadric)
Robots para viñedos
Los fundadores —Veerbhan Kheterpal, Daniel Firu y Nigel Drego— fundaron anteriormente 21, una empresa de minería de bitcoin adquirida por Coinbase. El foco inicial de Quadric fue en robots agrícolas que recorrían viñedos del Valle de Napa, detectando fugas de riego y plagas. Sin embargo, el alto coste de soluciones basadas en drones empujó al equipo a explorar un acelerador personalizado.
Veerbhan Kheterpal (Fuente: Quadric)
«Nos dimos cuenta de que un sistema basado en drones costaría 5–10 mil $, pero una plataforma basada en tractor superaría los 50 mil $ con grandes GPUs y numerosas cámaras. Esa idea nos llevó a diseñar el chip acelerador que necesitábamos», explicó Kheterpal.
Tras una ronda semilla en 2017 y una Serie A de 13 M $ liderada por el Tier‑One automotriz Denso, Quadric ha recaudado 18 M $ hasta la fecha.
Diseño Turing‑completo
La arquitectura guiada por instrucciones de Quadric mezcla conceptos de flujo de datos y Von Neumann para reemplazar sistemas de borde heterogéneos con una única solución flexible. Los núcleos Vortex Turing‑completos entregan aceleración manteniendo programabilidad. Arreglos escalables y compatibilidad con procesos de 7 u 5 nm hacen el diseño adecuado para dispositivos de borde con presupuestos de potencia desde cientos de miliwatts hasta 20 W.
El chip Q16 alberga un array de 16 × 16 núcleos Vortex. Cada núcleo puede realizar multiplicación de matrices y operaciones de IA, e incluye una ALU multifuncional para lógica, reducción, desplazamiento y más. El software expone un amplio espectro algorítmico —desde funciones de activación LSTM hasta flujo de control personalizado— usando sentencias if-then-else a través del array para explotar dispersión de grano fino.
Cada núcleo disfruta de acceso en un solo ciclo a sus vecinos y una memoria en-núcleo de 4 Kb, mientras que la memoria on-chip proporciona acceso a datos de baja latencia y determinista.
Los núcleos ejecutan en modo «single instruction, multiple decode»: la misma instrucción se transmite cada ciclo, pero datos de tiempo de ejecución dinámicos permiten a núcleos individuales interpretarla de manera diferente, habilitando función heterogénea dentro de un array homogéneo.
Un bus de broadcast dedicado transmite eficientemente constantes —como pesos de redes neuronales— a todos los núcleos simultáneamente. Unidades de carga/almacenamiento estáticas controladas por software permiten tiempos de ejecución de kernel deterministas, con cargas dual-edge simultáneas y almacenamientos triple-edge reduciendo el tiempo de ejecución.
Daniel Firu (Fuente: Quadric)
«Cargar desde un lado y almacenar desde otro nos permite realizar re-mapeos de datos y rotaciones de imagen a nivel de hardware», dijo Firu.
Memorias estáticas on-chip, no cachés, proporcionan amplio espacio para grandes estructuras de datos. Los 8 GB de memoria del Q16 pueden contener múltiples buffers de frame HD o un conjunto completo de pesos de red neuronal.
Pila de software
Quadric construyó su pila de software antes que el silicio, permitiendo a desarrolladores prototipar en un simulador o FPGA. La pila abstrae la arquitectura mediante un compilador basado en LLVM y una API en C++. El modo Source soporta algoritmos paralelos de datos con control en C++ sobre características arquitectónicas, y puede expresar operaciones personalizadas a medida que los modelos de IA se vuelven más complejos.
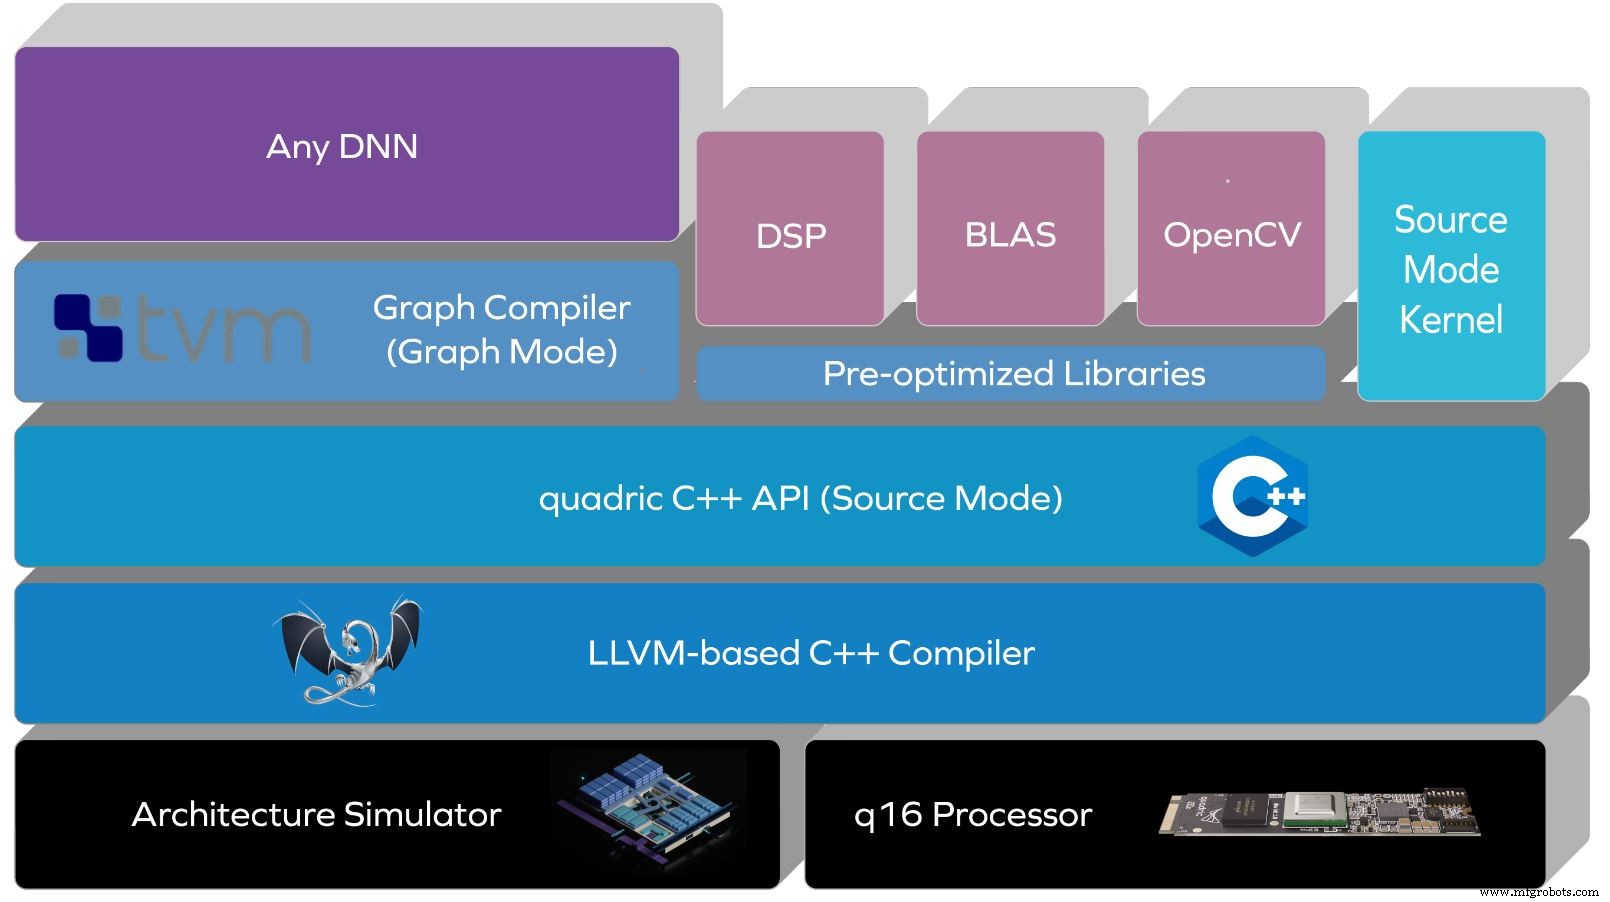
Pila de software de Quadric (Fuente: Quadric)
Un próximo modo Graph proporcionará una interfaz sin código para modelos TensorFlow u ONNX, respaldada por un compilador DNN basado en TVM que auto-genera código.
«La mayoría de plataformas te limitan a su propio compilador de IA, pero nosotros ofrecemos núcleos Turing‑completos que pueden ejecutar cualquier operación», explicó Kheterpal. «Esta flexibilidad permite a desarrolladores desplegar algoritmos personalizados u operadores no soportados sin restricción.»
Hoja de ruta del chip
El Q16 entrega 256 núcleos Vortex en un array 16 × 16 fabricado en silicio de 16 nm, alcanzando 4 TOPS INT8 DNN. Ejecuta ResNet‑50 a 200 inferencias por segundo en imágenes 224 × 224, consumiendo un promedio de 2 W.
La hoja de ruta de Quadric incluye una arquitectura de segunda generación y un chip Q32 —un array de 1.000 núcleos— dirigido a fabricación de 7 nm. El Q32 también podría integrar núcleos ARM o RISC‑V para servir como procesador host.
Un kit de desarrollador M.2 con el procesador Q16 y 4 GB de memoria externa está disponible hoy.
>> Este artículo se publicó originalmente en nuestro sitio hermano, EE Times.
Contenido relacionado
- Aceleradores de hardware sirven aplicaciones IA
- Cuando un DSP supera a un acelerador de hardware
- Guía para acelerar aplicaciones con instrucciones personalizadas RISC‑V just-right
- Rendimiento de chip de inferencia se basa en diseño optimizado de subsistema de memoria
- Nuevos módulos de aceleración IA mejoran rendimiento en el borde
- IA en el borde desafía tecnología de memoria
Para más contenido de Embedded, suscríbete al boletín semanal de Embedded.
Incrustado
- Optimice su flujo con cobot TM de Omron: integración fluida y programación intuitiva
- Comprender la Visión Hiperspectral: Una Herramienta Poderosa para la Seguridad Alimentaria
- IBM presenta arquitectura blockchain híbrida para gestionar redes IoT de forma segura
- Entendiendo el Diseño Arquitectónico: Principios, Prácticas e Impacto
- Blaize presenta el Graph Streaming Processor (GSP) para cargas de trabajo de IA
- STM32WB50: MCU inalámbrico dual‑core para aplicaciones IoT seguras
- Aceleración Edge AI: Principales procesadores especializados para 2024
- Lattice y Etron presentan controlador de memoria compacto y bajo consumo para cargas de trabajo Edge AI
- ECM3532: Primera placa sensor IA integrada ultra-bajo consumo de Eta Compute acelera desarrollo edge
- ADLINK lanza NEON‑1000‑MDX: Cámara inteligente Edge AI llave en mano para despliegue rápido visión industrial
- Entornos híbridos cloud: Seleccionando aplicaciones, cargas de trabajo y estrategias para rendimiento óptimo