



Acelere sus aplicaciones con instrucciones personalizadas RISC‑V a medida
La arquitectura de conjunto de instrucciones (ISA) abierta de RISC‑V ofrece una flexibilidad sin precedentes, permitiendo a los desarrolladores diseñar extensiones que se ajusten precisamente a los requisitos de su aplicación. Si bien el procesador base puede configurarse con extensiones estándar, la verdadera ventaja reside en crear nuevas instrucciones que aborden desafíos específicos de rendimiento o consumo.
El desafío de software de las ISAs fijas
Históricamente, las ISAs eran propiedad intelectual propietaria de proveedores comerciales. Los desarrolladores embebidos tenían que evaluar múltiples ISAs fijas para encontrar la más adecuada para sus cargas de trabajo, pero la incapacidad de alterar la semántica de las instrucciones significaba que optimizaciones críticas, como una instrucción dedicada de cifrado, eran imposibles. Esta limitación a menudo obligaba a los diseñadores a depender únicamente del escalado de proceso o la integración de periféricos para lograr diferenciación, lo que puede ser costoso y limitado en tiempo.
La ISA RISC‑V se originó en UC Berkeley y ahora es administrada por la Asociación Internacional RISC‑V, una organización sin ánimo de lucro con más de 300 miembros. Su licencia libre y abierta brinda a los desarrolladores una hoja en blanco: un núcleo estándar que puede extenderse, o un diseño completamente nuevo construido desde cero.
Las ISAs abiertas atraen a la academia, startups y grandes empresas por igual. Pueden usarse en FPGAs, SoCs, o como corazón de un microcontrolador, y admiten una variedad de modelos de negocio, desde IP comercial hasta código abierto y silicio personalizado.
Aprovechando la flexibilidad de RISC‑V
Comenzar es sencillo. Un punto de entrada típico es la configuración RV32IM de 32 bits, que incluye las extensiones de enteros "I" y multiplicación "M". Las herramientas de simulación permiten instanciar una ISA base, adjuntar un modelo de memoria con retardos realistas y ejecutar código C/C++ en un procesador virtual.
Usando un IDE como Eclipse y el depurador GNU (GDB), los desarrolladores pueden perfilar aplicaciones, identificar puntos calientes y modelar instrucciones personalizadas candidatas. La especificación RTL resultante y las estimaciones de rendimiento se retroalimentan en el bucle de desarrollo.
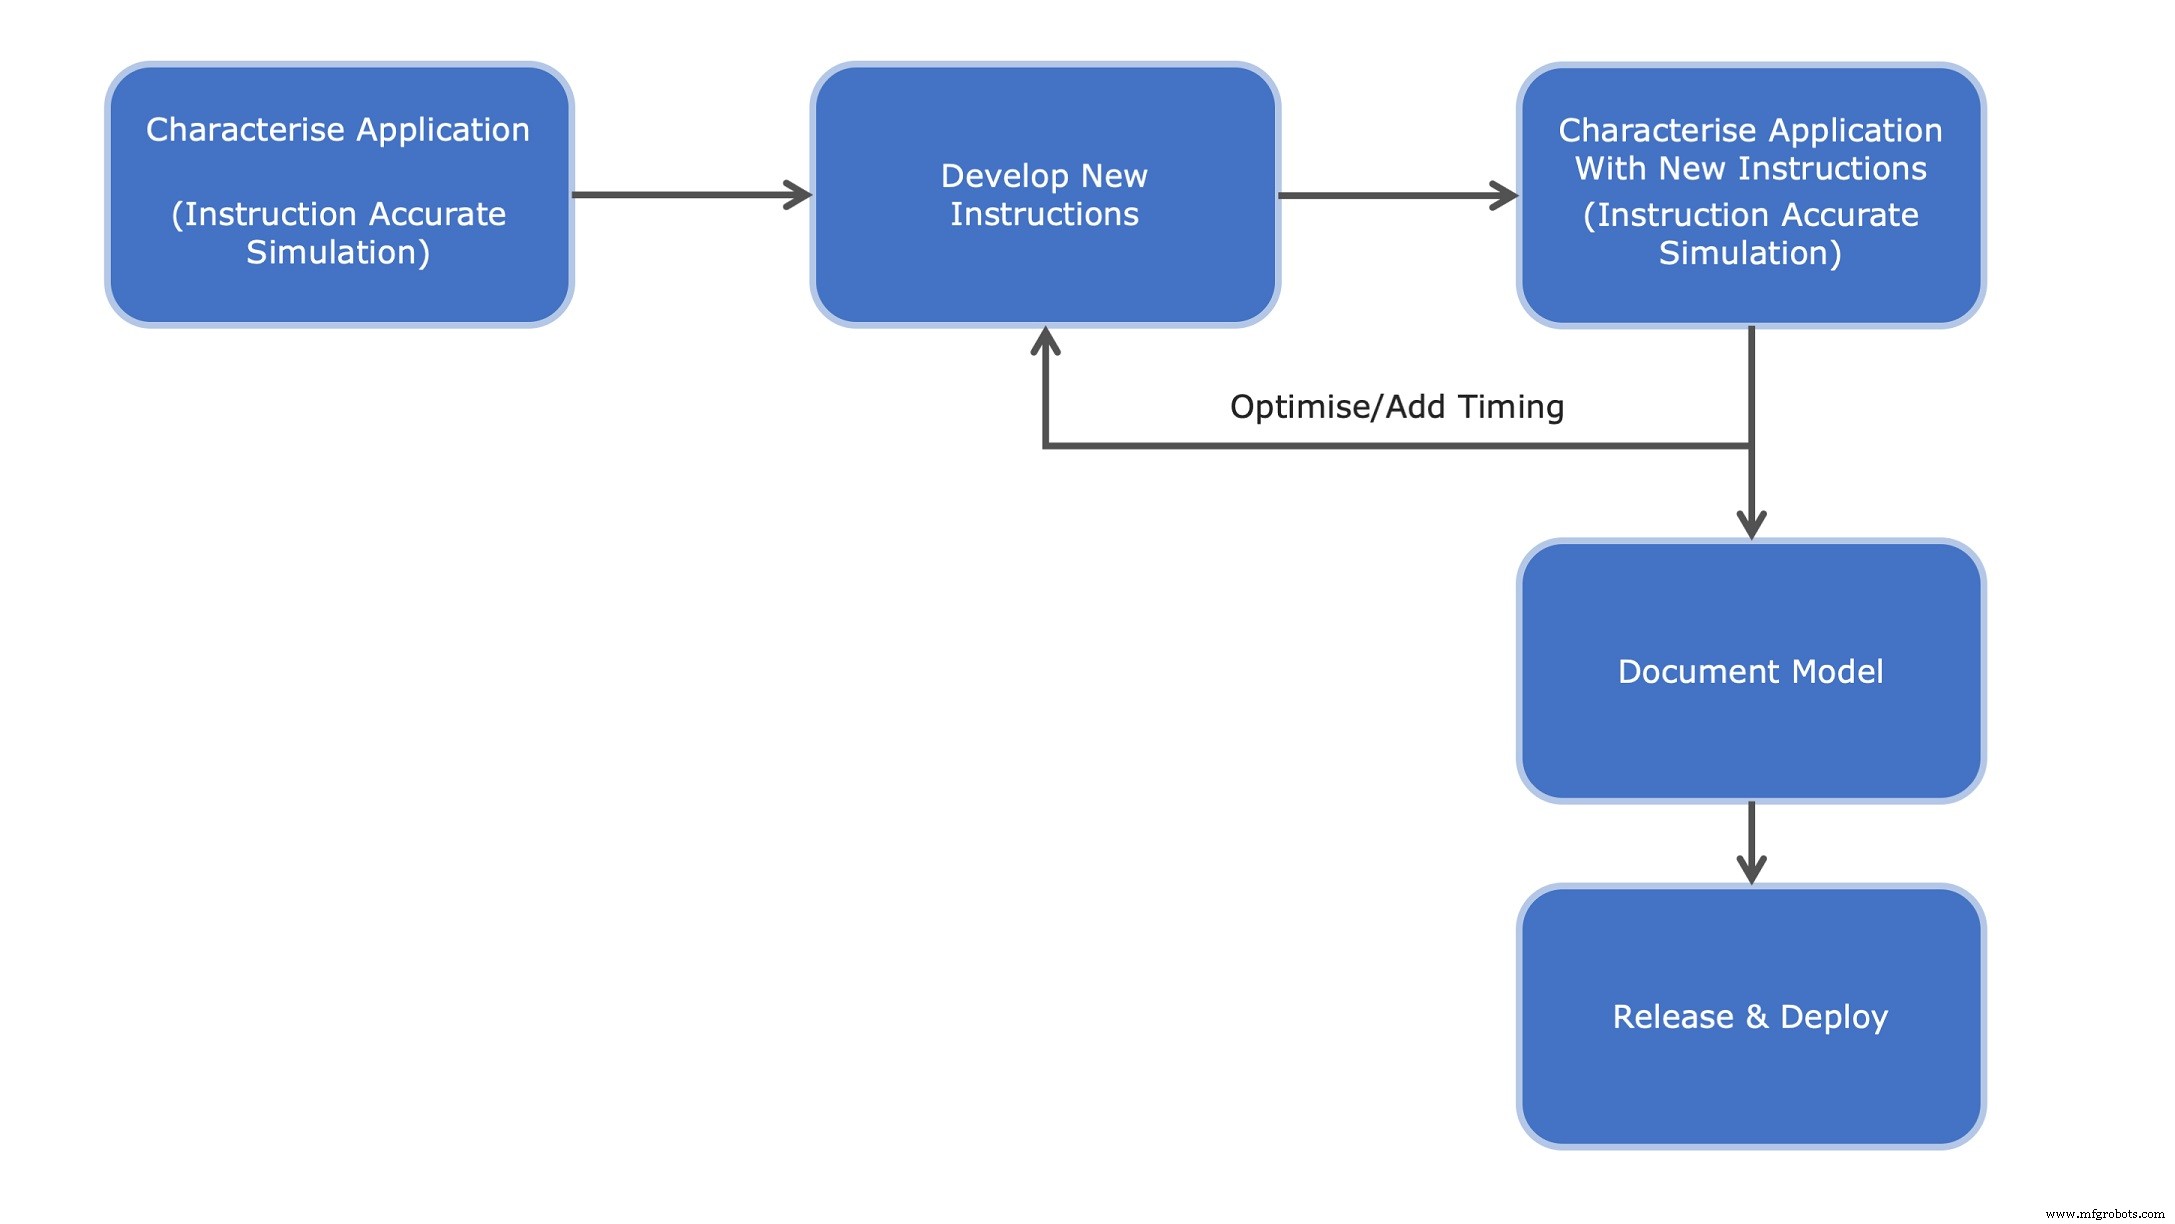
Considere el cifrado ChaCha20, un benchmark común en dispositivos de bajo consumo. Tras compilar un binario RV32IM vanilla y ejecutar un profiler de bloques básicos, la mayor parte del tiempo de ejecución se concentra en las operaciones XOR y rotación de "quarter-round" (ver Figura 2).

Las herramientas de visualización producen un árbol colapsable de estadísticas de ejecución, facilitando detectar las funciones dominantes, como processWord(), y sus sub-llamadas (Figura 3).

Una vez identificado el cuello de botella de rendimiento, el siguiente paso es diseñar instrucciones personalizadas que consoliden el patrón XOR-más-rotación en una sola micro-operación. Dado que RISC‑V es una arquitectura load-store, estas instrucciones deben operar en registros de 32 bits, lo que las hace adecuadas para el espacio de opcode custom-1.

Con las reglas de codificación de la ISA, los siete bits inferiores identifican el opcode, mientras que tres bits funct3 dan espacio para ocho operaciones distintas. Cuatro de estas —XOR más una rotación a la izquierda de 7, 8, 12 o 16 bits— son suficientes para ChaCha20.
Antes de comprometerse con hardware, los desarrolladores modelan estas instrucciones en el entorno ISS usando la API VMI de OVP. Este paso de simulación rápida verifica la corrección funcional y proporciona una primera vista de las ganancias de rendimiento.
Existen dos enfoques para la validación funcional:
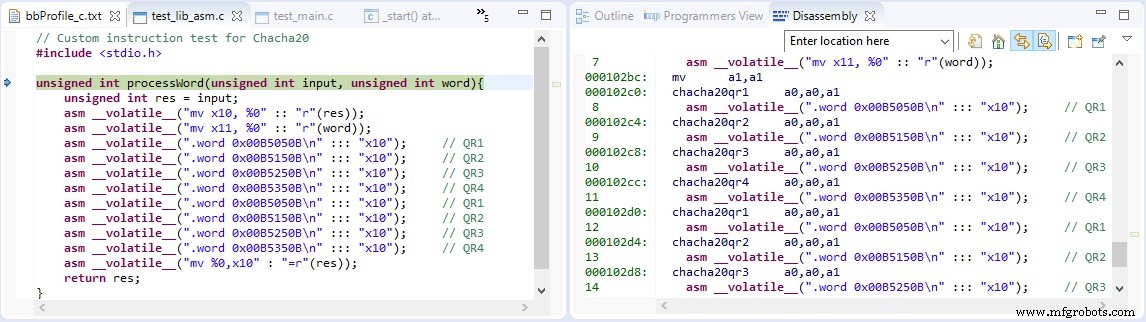
- Invocar la rutina original C/C++ y vincular las nuevas instrucciones mediante ensamblador en línea (Figura 5a).
- Implementar las instrucciones como operaciones morph VMI que reproducen el mismo comportamiento (Figura 5b).


Tras recompilar la aplicación con ensamblador en línea, el simulador reporta una reducción dramática en la cuenta de instrucciones y tiempo de ciclo:
Resultados con implementación C original
Info Instrucciones simuladas: 316,709,013
Info Tiempo simulado: 5,15 segundos
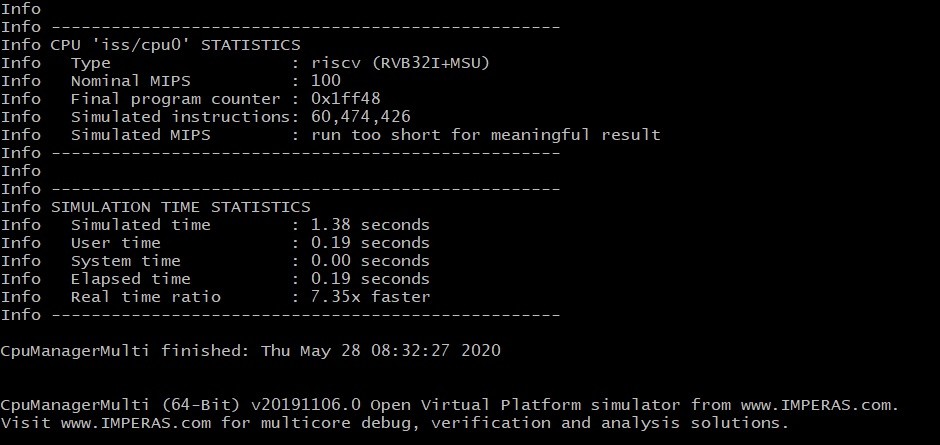
Resultados con instrucciones personalizadas
Info Instrucciones simuladas: 60,474,426
Info Tiempo simulado: 1,38 segundos
Con las nuevas instrucciones, la función processWord() sigue consumiendo la mayor parte del tiempo de ejecución (≈66 %) pero el algoritmo general es ahora tres veces más rápido.
Un refinamiento adicional implica asignar latencias de ciclo realistas a cada instrucción personalizada y volver a perfilar, incluyendo estados de espera de memoria que aparecerían en una implementación en silicio.
Dado que el ISS se integra perfectamente con Eclipse y GDB, la depuración completa tanto de la aplicación host como de la ISA personalizada puede realizarse antes del compromiso de hardware.
De la simulación a la implementación RTL
Con métricas de rendimiento validadas en mano, los desarrolladores traducen las instrucciones personalizadas a RTL. El modelo funcional generado previamente y el plan de verificación sirven como referencia de oro, reduciendo el riesgo durante la síntesis y el cierre de tiempos.
La documentación sigue el mismo flujo de trabajo: los modelos de procesador rápido de OVP incluyen documentación plantilla que puede extenderse para describir nuevas instrucciones. Una vez formateada en TeX, se genera un PDF para referencia de la comunidad (Figura 8).

Conclusión
La ISA abierta de RISC‑V desbloquea un mundo de extensiones personalizadas que pueden mejorar drásticamente el rendimiento de la aplicación, reducir el consumo de energía y cumplir plazos estrictos de tiempo real, capacidades que las ISAs fijas no pueden igualar. Al perfilar cargas de trabajo reales, modelar instrucciones personalizadas en simulación y verificar rigurosamente el RTL, los desarrolladores pueden llevar silicio personalizado al mercado con ganancias probadas.
Incrustado
- Inyección de aglutinante (Binder Jetting) en impresión 3D: cómo funciona, beneficios y mejores prácticas
- Impresión 3D de Titanio: Aplicaciones, Beneficios y Tecnologías Emergentes
- IA en seguros: Guía práctica para implementación real
- Domina la renegociación de costes con proveedores existentes: Una guía práctica
- IA en Medicina: 5 Aplicaciones Reales Comprobadas con Ejemplos Prácticos
- Router CNC madera: Precisión versátil para muebles de alta calidad y más
- Zapatas y Pastillas de Freno Personalizadas: Garantizando la Seguridad en Ferrocarriles de Alta Velocidad
- Microchip lanza MCUs basados en Arm para misiones espaciales escalables – De COTS a tolerantes a radiación y endurecidos
- Renesas lanza MCUs RX72M con EtherCAT integrado para automatización industrial
- Axiomtek tBOX400-510-FL: PC Transporte Dual-Processor con Switch PoE Gestionado 10-Puerto Integrado
- Perfilado de aplicaciones distribuidas con Linux perf: Guía práctica