



Construyendo sistemas de IA robustos: Algoritmos a prueba de errores para la industria
Fallos en cámaras de visión artificial, sensores no calibrados o sombras impredecibles pueden llevar a errores potencialmente costosos y peligrosos en sistemas industriales de IA. Sin embargo, los investigadores están desarrollando algoritmos a prueba de errores, así como medidas simples que pueden tomarse para reducir la probabilidad de error.
La inteligencia artificial ha evolucionado mucho más allá de la red neuronal artificial básica del perceptrón, pero el error sigue siendo un problema. Imagen cortesía de Pixabay
Aplicaciones industriales para la inteligencia artificial
Hay numerosas aplicaciones industriales para la IA (inteligencia artificial), como plataformas robóticas, manipulación de materiales, embalaje, cuidado de máquinas, ensamblaje, inspección y BAS (sistemas de automatización de edificios). Ejemplos más específicos incluyen tecnología de drones y enjambres para clasificación, movimiento y transporte de artículos o detección de anomalías en procesos de producción.
La IA se ha convertido en un aspecto crítico pero a menudo olvidado de la automatización industrial dependiente de visión artificial, brazos robóticos, detección remota y control de procesos.
Sin embargo, las herramientas de IA no son una caja negra simple en la que se proporcionan datos como entrada y se transforman en una salida precisa. A veces la salida es incorrecta, y eso es una fuente de preocupación.
Tipos de errores en aplicaciones industriales
Las computadoras hacen lo que se les dice que hagan, por lo que un humano está en la raíz de cada error. Puede ser un error de diseño, un error algorítmico, un error de ingeniería o malos datos, pero habrá un humano en la raíz.
Esto también se aplica a la IA, incluida la IA industrial. Los errores dentro de la IA industrial pueden caer en una de dos categorías: sesgo algorítmico y sesgo de máquina.
El sesgo algorítmico involucra errores que son tanto repetibles como sistémicos. Tales errores pueden manifestarse de varias maneras diferentes: error inherente en la lógica del algoritmo, uso no anticipado de la salida del algoritmo, o problemas con los datos proporcionados al sistema de IA.
El sesgo de máquina ocurre cuando se usa un conjunto de datos limitado para entrenar el sistema, llevando a una salida errónea.
La importancia de mantener el error de IA bajo control
Como ejemplo de sesgo algorítmico, considere un sistema de visión artificial potenciado por IA usado para sistemas automatizados de control de calidad. Tal aplicación depende en gran medida de mediciones precisas suministradas como datos a la IA, determinando si la pieza cae dentro de tolerancias. Si se proporcionan mediciones inexactas a la IA, resultará en etiquetado erróneo de piezas.
Los algoritmos detrás de la visión artificial de IA pueden ser 100% correctos, pero malos datos significan mala salida. Piezas aceptables pueden ser desechadas, mientras que piezas de mala calidad pueden ser enviadas a clientes. Esto conduce a costes innecesarios y tiempo de inactividad mientras se rastrea la fuente del problema.
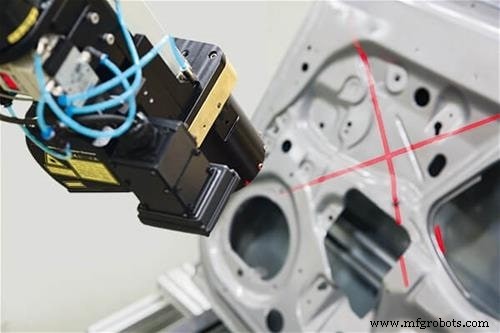
iRVision 3DL de FANUC usa láseres e IA para verificar las condiciones de superficie de una pieza. Imagen cortesía de FANUC
Algunos sistemas de IA que requieren entrenamiento antes de su uso en un entorno o aplicación particular. En tales casos, los datos de entrenamiento proporcionados al sistema son extremadamente importantes. Por ejemplo, si un sistema recibe entrenamiento limitado a condiciones en un área iluminada, habrá problemas cuando el sistema deba funcionar sin luz.
IA a prueba de errores (Entrenamiento de IA)
Debido a que hay un elemento humano detrás de la IA y el aprendizaje automático, no puede ser a prueba de errores. Sin embargo, hay formas de minimizar el error dentro de los sistemas de IA. Un ejemplo incluye CARRL (Aprendizaje por Refuerzo Profundo con Robustez Adversarial Certificada), un algoritmo de aprendizaje profundo desarrollado en MIT cuyo propósito es asistir sistemas autónomos fomentando un nivel de escepticismo sobre los datos que tiene en cuenta, como el ruido en los datos y esfuerzos adversarios para confundir el sistema.
Carnegie Mellon también ha estado trabajando en un algoritmo de IA para modelos de aprendizaje profundo. Llamado RATT (Asignar, Entrenar y Rastrear Aleatoriamente), este enfoque usa datos de entrenamiento sin etiquetar y ruidosos para establecer un límite superior para el riesgo de error real. Este límite superior puede determinar qué tan bien un modelo de IA se adapta a nuevos datos de entrada. Además, investigadores de Princeton han estado analizando algoritmos que permitirán a un sistema de IA aprender eficazmente cuando hay errores presentes en los datos de entrenamiento.
También hay estándares en desarrollo que impactarán los esfuerzos de prueba de errores. NIST (Instituto Nacional de Estándares y Tecnología) está contribuyendo activamente a estándares de IA que incluyen un enfoque en evaluar la confiabilidad de la tecnología de IA. NIST también ha propuesto un enfoque para reducir el riesgo de sesgo en sistemas de IA.
La Agencia de Ciberseguridad e Infraestructura de EE. UU. (CISA) ya está analizando estándares para vetar algoritmos de IA y recopilación de datos, como se reveló durante un panel de 2020 titulado "Máquinas Geniales". Este esfuerzo, junto con el de NIST, enfatiza la responsabilidad.
Abordar el error en sistemas de IA
Aunque hacer a prueba de errores los sistemas de IA de los que es responsable puede no ser posible debido al elemento humano involucrado, ciertamente hay formas de minimizar la posibilidad de errores.
Si sospecha que los errores provienen de su sistema de IA, no culpe automáticamente al algoritmo; más bien, estudie los errores para buscar un patrón. Por ejemplo, si es un robot de recolección en contenedores autónomo cometiendo errores, vea si hay algo en común que los artículos mal clasificados tengan o si hay cambios en el entorno del robot (iluminación, sombras, etc.) que podrían afectar su rendimiento. También podría haber un problema con una lente de cámara sucia en la parte de visión artificial del sistema, como las encontradas en robots móviles autónomos.
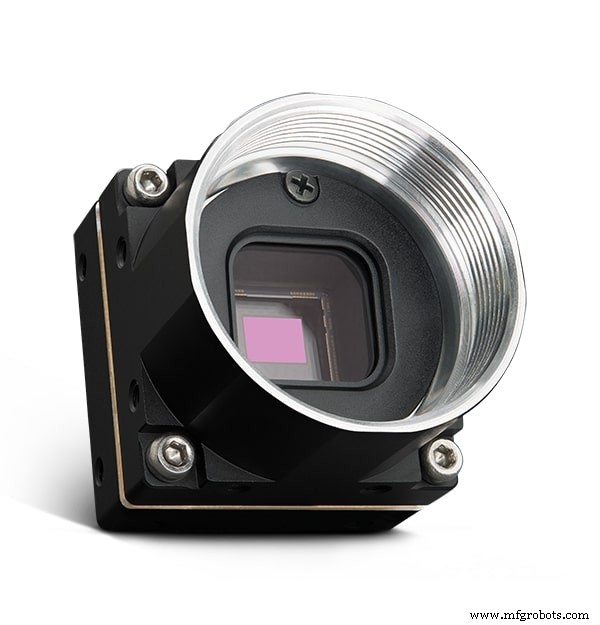
Muchas cámaras de visión artificial tienen sistemas de IA integrados, como la FLIR Firefly DL, pero estos sistemas pueden generar errores si no se mantienen limpios y configurados correctamente. Imagen cortesía de FLIR
Una regla dura de programación es que una mala entrada siempre resultará en una mala salida. El primer paso para minimizar el error generado por un sistema industrial de IA es asegurar que sus datos sean lo más precisos posible, comenzando con los sensores. Los sensores que proporcionan datos de entrada a los sistemas de IA deben calibrarse regularmente.
Las herramientas dentro del sistema de IA que permiten a los usuarios establecer rangos aceptables para los datos deben implementarse después de una cuidadosa consideración de un rango aceptable: demasiado estricto, y la IA no proporcionará mucho valor; demasiado laxo, y genera demasiados errores. Y recuerde, estos valores pueden ajustarse.
Además, como se aludió anteriormente, mantenga limpias las cámaras. Si bien los sistemas de visión artificial están diseñados para ser robustos en diversas condiciones ambientales, eso no significa que aún funcionen bien cuando la visión se ve comprometida por una lente sucia. Lo mismo es cierto para otros sensores industriales cuya precisión puede verse comprometida por acumulación de incrustaciones, exposición a entornos corrosivos, problemas mecánicos o envejecimiento.
La IA se usa ampliamente en el sector industrial para todo, desde controles de proceso hasta inspecciones de calidad. Y debido al factor humano involucrado, estos sistemas de IA también están sujetos a error. Los algoritmos a prueba de errores están en desarrollo, pero estos métodos no están completamente maduros, ni han sido probados extensivamente en aplicaciones industriales. Y aunque organizaciones como NIST y CISA están trabajando hacia estándares a prueba de errores, aún están en desarrollo. Sin embargo, algunas medidas simples pueden reducir la probabilidad de error en sus sistemas de IA.
Robot industrial
- Internet Industrial de las Cosas (IIoT): Definición, alcance e impacto industrial
- Entendiendo los Tipos de Datos en C++: Fundamentos, Modificadores y Mejores Prácticas
- Tipos de datos en C explicados: int, float, char y más – guía completa
- Entendiendo los tipos de datos en C: Guía completa
- Uniones en C explicadas: Gestión eficiente de memoria para múltiples tipos de datos
- Guía Completa de Tipos de Datos en C#: Valor, Referencia y Punteros
- Tipos de Datos en MATLAB: Guía Completa de Conversión y Determinación
- Dominando tipos de datos en Python: Guía práctica
- Dominando la encapsulación en Java: Guía práctica de ocultamiento de datos
- Dominando los Algoritmos de Colecciones de Java: Ordenación, Mezcla y Más
- Dominando el Casting de Tipos en Java: Desde Ensanchamiento hasta Estrechamiento y Más Allá