



Parseo XML en Python: Guía Práctica con Minidom y ElementTree
¿Qué es XML?
XML, o eXtensible Markup Language, fue creado para almacenar y transportar datos estructurados eficientemente. Es ampliamente usado para intercambio de información entre sistemas y aplicaciones.
Python provee librerías robustas para parsear y manipular documentos XML. Sin embargo, para parsear un archivo XML, el documento completo debe cargarse primero en memoria. En este tutorial demostraremos cómo usar los módulos xml.dom.minidom y xml.etree.ElementTree de Python para leer, inspeccionar y modificar archivos XML.
Al final de esta guía podrás:
- Parsear XML con
minidom - Crear nuevos nodos XML
- Parsear XML con
ElementTree
Parseando XML con minidom
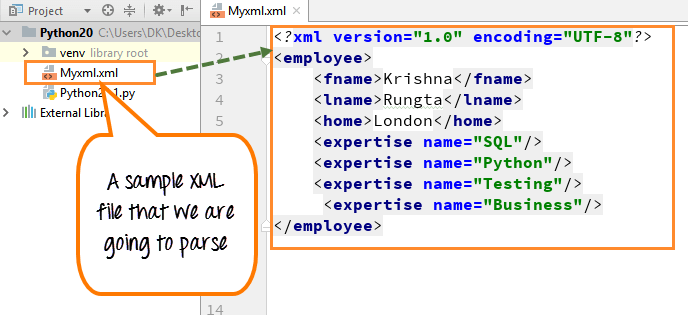
Empezaremos con un archivo XML de ejemplo que contiene datos de empleados. El archivo se ve así:
Paso 1) El archivo lista nombre, apellido, domicilio y áreas de experiencia de un empleado como SQL, Python, Testing y Business.
Paso 2) Tras cargar el documento, imprimiremos el nodeName del elemento raíz y el tagName de su primer hijo. Estas son propiedades estándar de un objeto DOM.
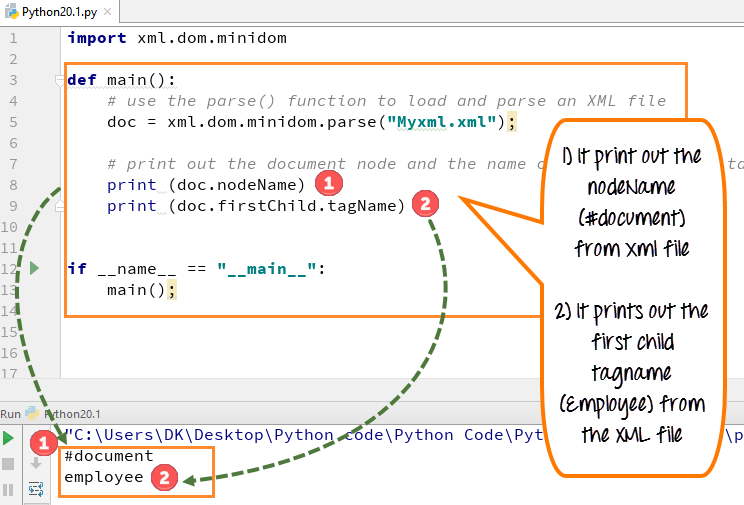
- Importa
xml.dom.minidomy carga el archivo XML (myxml.xml). - Parsea el archivo con
parse()para obtener objeto documento. - Recupera y muestra el
nodeNamedel documento ytagNamedel primer hijo. - Usa
getElementsByTagName()para listar todos los elementosexpertisee imprime cada habilidad.
Nota: Los valores nodeName y tagName siguen convenciones de nomenclatura DOM XML, que pueden ser desconocidas si eres nuevo en XML.
Paso 3) Podemos extraer una lista de todas las habilidades del documento. El siguiente código demuestra cómo reunir los nombres de habilidades en un set.
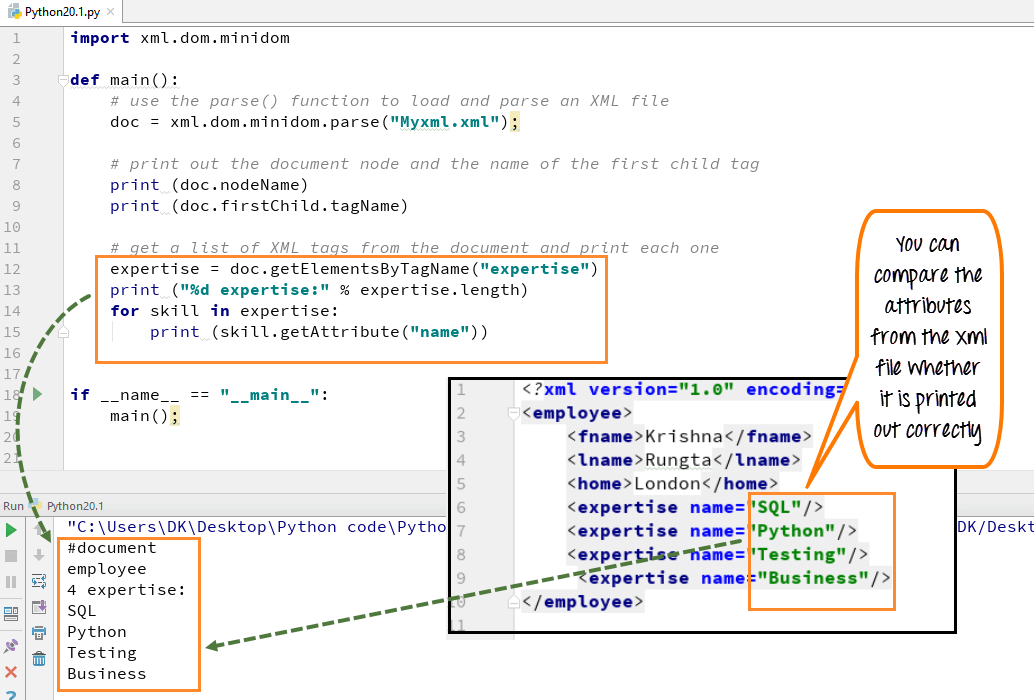
- Usa
getElementsByTagName("skill")para recuperar todos los elementos skill. - Itera sobre la lista retornada y muestra el atributo
namede cada skill.
Creando un Nuevo Nodo XML
Añadir nuevos datos a una estructura XML existente es sencillo con minidom. En nuestro ejemplo, añadiremos un nuevo nodo expertise etiquetado "BigData".
- Crea el nuevo elemento con
createElement("expertise")y establece su atributoname. - Añade el nuevo elemento al hijo raíz del documento.
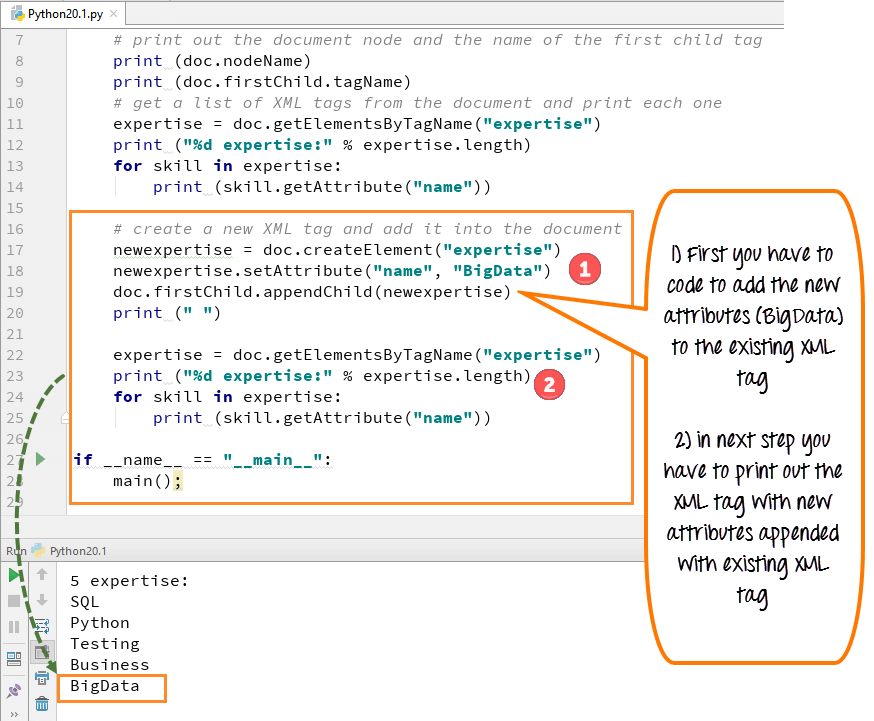
- Tras la inserción, la lista
expertiseahora incluye la nueva habilidad "BigData".
Ejemplo Parser XML
Ejemplo Python 2
import xml.dom.minidom
def main():
    # Cargar y parsear archivo XML
    doc = xml.dom.minidom.parse("Myxml.xml")
    # Mostrar información raíz
    print doc.nodeName
    print doc.firstChild.tagName
    # Listar entradas expertise existentes
    expertise = doc.getElementsByTagName("expertise")
    print "%d expertise:" % expertise.length
    for skill in expertise:
        print skill.getAttribute("name")
    # Añadir nueva entrada expertise
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print " "
    # Verificar adición
    expertise = doc.getElementsByTagName("expertise")
    print "%d expertise:" % expertise.length
    for skill in expertise:
        print skill.getAttribute("name")
if __name__ == "__main__":
    main()
Ejemplo Python 3
import xml.dom.minidom
def main():
    # Cargar y parsear archivo XML
    doc = xml.dom.minidom.parse("Myxml.xml")
    # Mostrar información raíz
    print(doc.nodeName)
    print(doc.firstChild.tagName)
    # Listar entradas expertise existentes
    expertise = doc.getElementsByTagName("expertise")
    print("%d expertise:" % expertise.length)
    for skill in expertise:
        print(skill.getAttribute("name"))
    # Añadir nueva entrada expertise
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print(" ")
    # Verificar adición
    expertise = doc.getElementsByTagName("expertise")
    print("%d expertise:" % expertise.length)
    for skill in expertise:
        print(skill.getAttribute("name"))
if __name__ == "__main__":
    main()
Parseando XML con ElementTree
ElementTree es una API ligera que hace manipulación XML simple y pythonica. Es ideal para leer archivos XML grandes sin overhead de DOM completo.
Nuestros datos XML de ejemplo:
<data>
  <items>
    <item name="expertise1">SQL</item>
    <item name="expertise2">Python</item>
  </items>
</data>
Leyendo XML con ElementTree:
Primero, importa el módulo:
import xml.etree.ElementTree as ET
Parsea el archivo y obtén el elemento raíz:
tree = ET.parse('items.xml')
root = tree.getroot()
Aquí el código completo para mostrar todos los nombres de habilidades:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()
print('Datos de Expertise:')
for elem in root:
    for subelem in elem:
        print(subelem.text)
Salida:
Datos de Expertise:
SQL
Python
Resumen
Los módulos xml.dom.minidom y xml.etree.ElementTree de Python empoderan a desarrolladores para cargar, analizar y modificar documentos XML eficientemente. Mientras minidom provee representación DOM completa adecuada para manipulaciones complejas, ElementTree ofrece alternativa ligera para parsing y extracción directos.
- Carga XML con
parse()(ej.doc = xml.dom.minidom.parse(archivo)). - Usa
getElementsByTagName()para recuperar elementos. - Crea y añade nuevos nodos con
createElement()yappendChild(). - Con ElementTree, simplemente itera sobre elementos hijos para acceder a datos.
python
- Entrada/Salida de Archivos en Python: Dominando Operaciones de Lectura, Escritura y Gestión
- Domine el Método strip() de Python: Guía Completa y Ejemplos Prácticos
- Python len(): Guía Práctica para Medir Longitud de Objetos
- Dominando yield en Python: Generadores vs Return – Guía práctica
- Counter de collections en Python: conteo eficiente, actualización y operaciones aritméticas
- Dominando enumerate() en Python: bucles con índices para listas, tuplas, cadenas y diccionarios
- Comprobación de existencia de archivos y directorios en Python – Guía práctica
- Python JSON: Codificación, decodificación y manejo de archivos – Guía práctica
- Python list.index(): Cómo Encontrar Posiciones de Elementos con Ejemplos Prácticos
- Entrada/Salida de Archivos en Python: Domina las Operaciones I/O
- Lectura de archivos en Java con BufferedReader – Guía práctica con ejemplos